AI生成内容伪装术升级?跨模态鉴伪技术实测揭秘真实风险防线
从肉眼找破绽到模型寻证据:AI鉴伪的技术范式转移
在过去很长一段时间里,公众对AI生成内容的认知往往停留在那些显而易见的“穿帮”细节上:招牌上的文字如同天书般不可读,人物眼镜左右不对称,镜中倒影与主体动作脱节,或者是视频中人物吃面时脸部与餐具发生的诡异融合。这些视觉上的逻辑谬误,曾构成了大众识别生成式AI的直觉基础。
然而,这一经验正在迅速失效。随着扩散模型、Transformer架构以及多模态大模型的迭代升级,高质量生成内容已能够修复绝大多数明显的结构错误。视频模型维持动作连续性的能力大幅提升,文本生成也通过风格模仿和压缩改写削弱了特有的“AI语感”。当异常从肉眼可见的局部畸变,转移到频谱分布、噪声残差、帧间一致性以及深层语义冲突等隐蔽层面,内容鉴伪就不再是一场简单的视觉“找茬”游戏,而演变为一个在开放世界中寻找证据链的安全检测问题。
跨模态鉴伪的核心逻辑:多维证据的综合研判
从产品界面看,AI鉴伪似乎只是输出“真实”或“AI生成”的二元结论。但从安全研究的角度深入剖析,一个成熟的鉴伪系统背后至少包含四个维度的任务:首先,判断整段内容是否由生成模型产生;其次,识别真实素材中是否存在局部篡改,如金额、人物或关键文本段的修改;再次,精准定位篡改发生的区域,给出可疑像素块、视频时间片段或文本风险段落;最后,提供证据解释,说明风险来源是频谱伪影、噪声不一致、时序异常还是语言分布异常。
这四种能力相互独立又互补。以常见的诈骗场景——模拟支付截图为例,攻击者通常只修改金额或收款对象,此时大部分像素仍来自真实界面,异常区域占比极小。如果检测器仅依赖整图平均特征,很容易被真实区域稀释,导致漏判。因此,系统必须具备在局部细节中寻找微弱异常信号的能力,并结合全局语义进行综合判断。
开放世界检测的挑战:泛化能力是关键
检测器在训练阶段只能接触到有限的生成模型,但在部署后,却要面对层出不穷的新模型、新算法。生成内容在社交平台传播过程中,往往还要经历截图、裁剪、JPEG压缩、滤镜处理、缩放、翻译以及二次转码等复杂链路。这种复杂的后处理环境使得检测器难以依赖单一的生成器“指纹”进行识别。
2025年ICLR论文《A Sanity Check for AI-generated Image Detection》提出的AIDE框架,为这一难题提供了重要思路。研究通过Chameleon数据集检验了多个现成模型,发现几乎所有模型在面对高质量AI图片时都会产生误判。AIDE因此引入了CLIP高层语义、高低频局部块特征,以及噪声和抗锯齿等底层统计特征的组合。这一研究揭示了一个核心趋势:AI图片检测的关键已从“捕捉固定破绽”转向“在未知模型和复杂环境中寻找稳定组合证据”。
跨模态检测的技术路径差异化
“跨模态”并不意味着将图片、视频和文本强行映射到同一特征空间,而是为每种模态建立差异化的检测路径,最终在产品层统一呈现风险结果。
图片检测:语义与频谱的双重验证 高层语义关注物体结构、遮挡关系、光影方向及镜面倒影的合理性;低层特征则聚焦频率分布、噪声残差、边缘过渡及纹理重复性。生成模型越擅长修复结构错误,检测器就越需要将高层语义理解与底层统计痕迹相结合,以应对复杂材质和动态光影的挑战。
视频检测:单帧自然不等于时间连续 视频鉴伪不仅要分析单帧空间特征,更要观察人物身份、物体边界、运动轨迹及光照变化是否跨帧稳定。早期“吃面”视频的穿帮,并非单帧不可看,而是脸、手、餐具在时间轴上无法维持同一物理关系。因此,时序异常检测是视频鉴伪的核心。
文本检测:无物理指纹下的统计博弈 文本缺乏相机传感器噪声和像素频谱,检测只能依赖用词概率、句法结构、语义推进及高维逻辑表征。短文本、翻译及人工润色都会改变这些信号,而公文或技术文档本身的规则性也可能产生误判。因此,文本鉴定的难点不仅在于“能判”,更在于对证据不足的样本给出适当的不确定性表达。
实测案例:14个AI正样本的深度检验
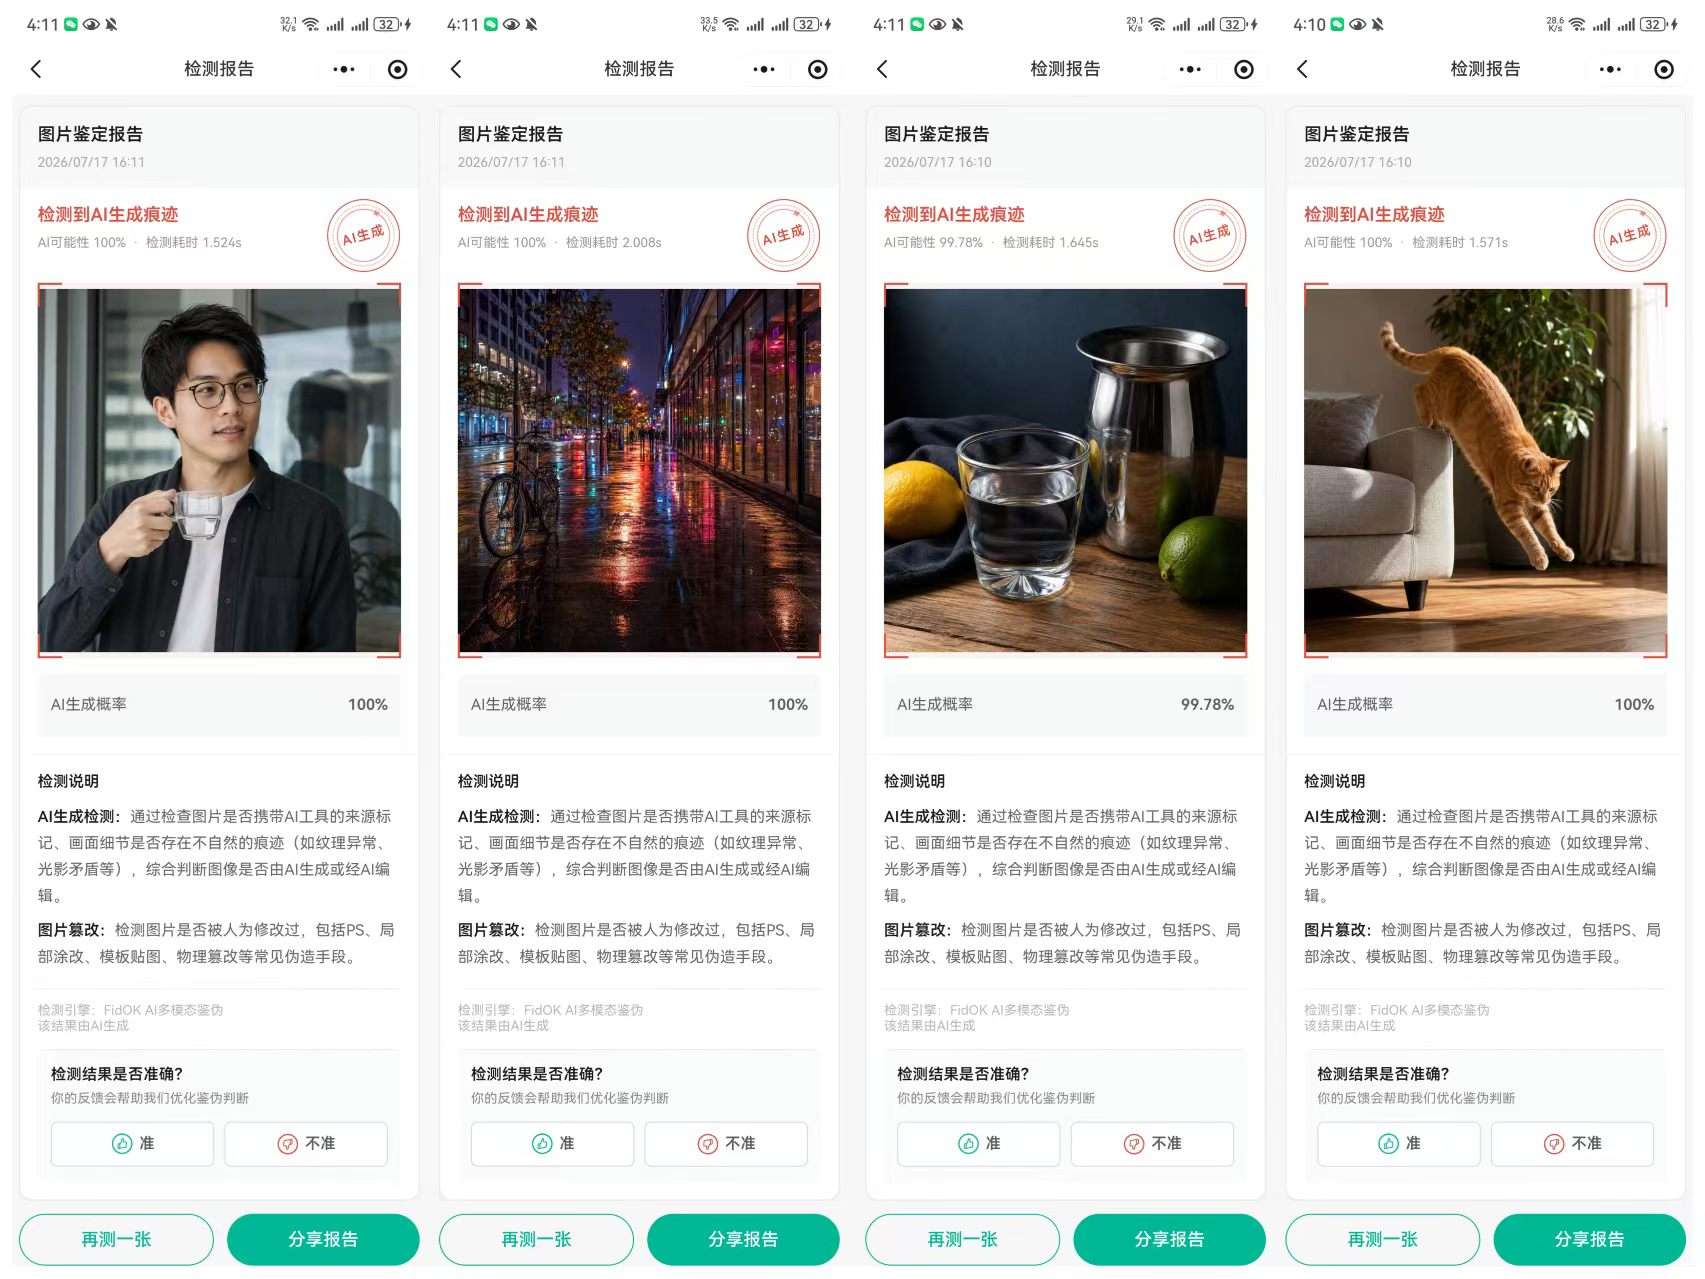
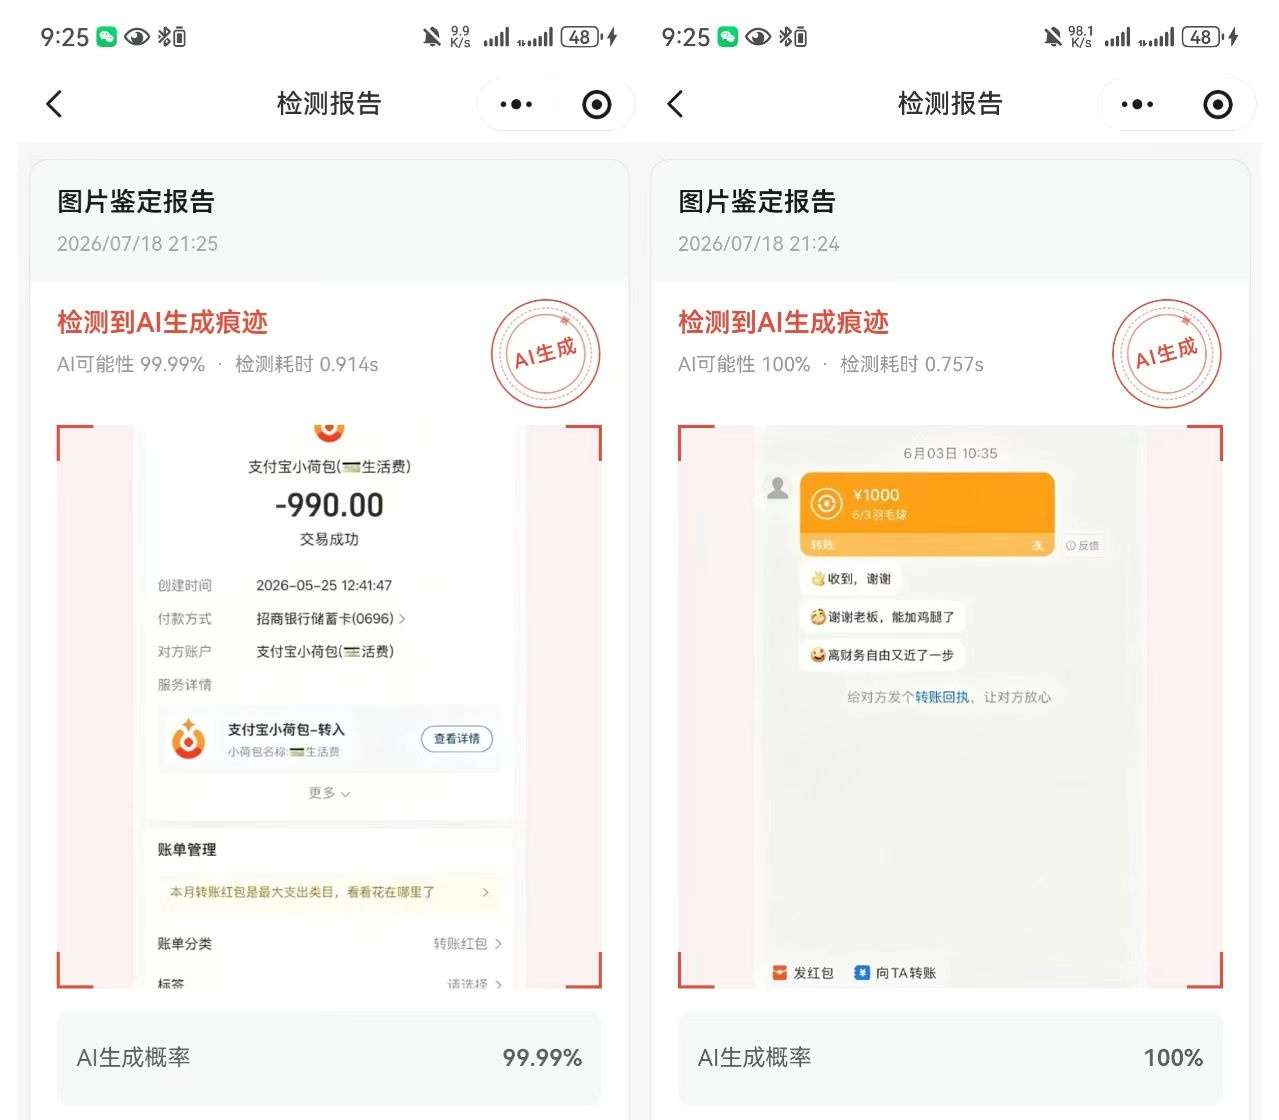
本轮测试选取了6张图片、2段视频和6段不同文体的文本。样本设计不仅涵盖自然场景,还特别增加了两张模拟支付截图,以观察系统处理UI元素密集、自然纹理较少内容的表现。
图片检测:高置信度覆盖多场景 测试结果显示,6个AI生成图片样本全部被检出,分数区间为99.78%至100%。其中,涉及人体结构、复杂反射、材质边界及动态姿态的图像均获得极高分。特别是两张模拟支付截图,分别获得99.99%和100%的分数,检测耗时均在1秒以内。这一结果对于金融反诈骗具有直接业务价值,因为此类图像的检测重点已从“画面像不像照片”转向“界面结构、文字渲染及局部编辑痕迹的一致性”。
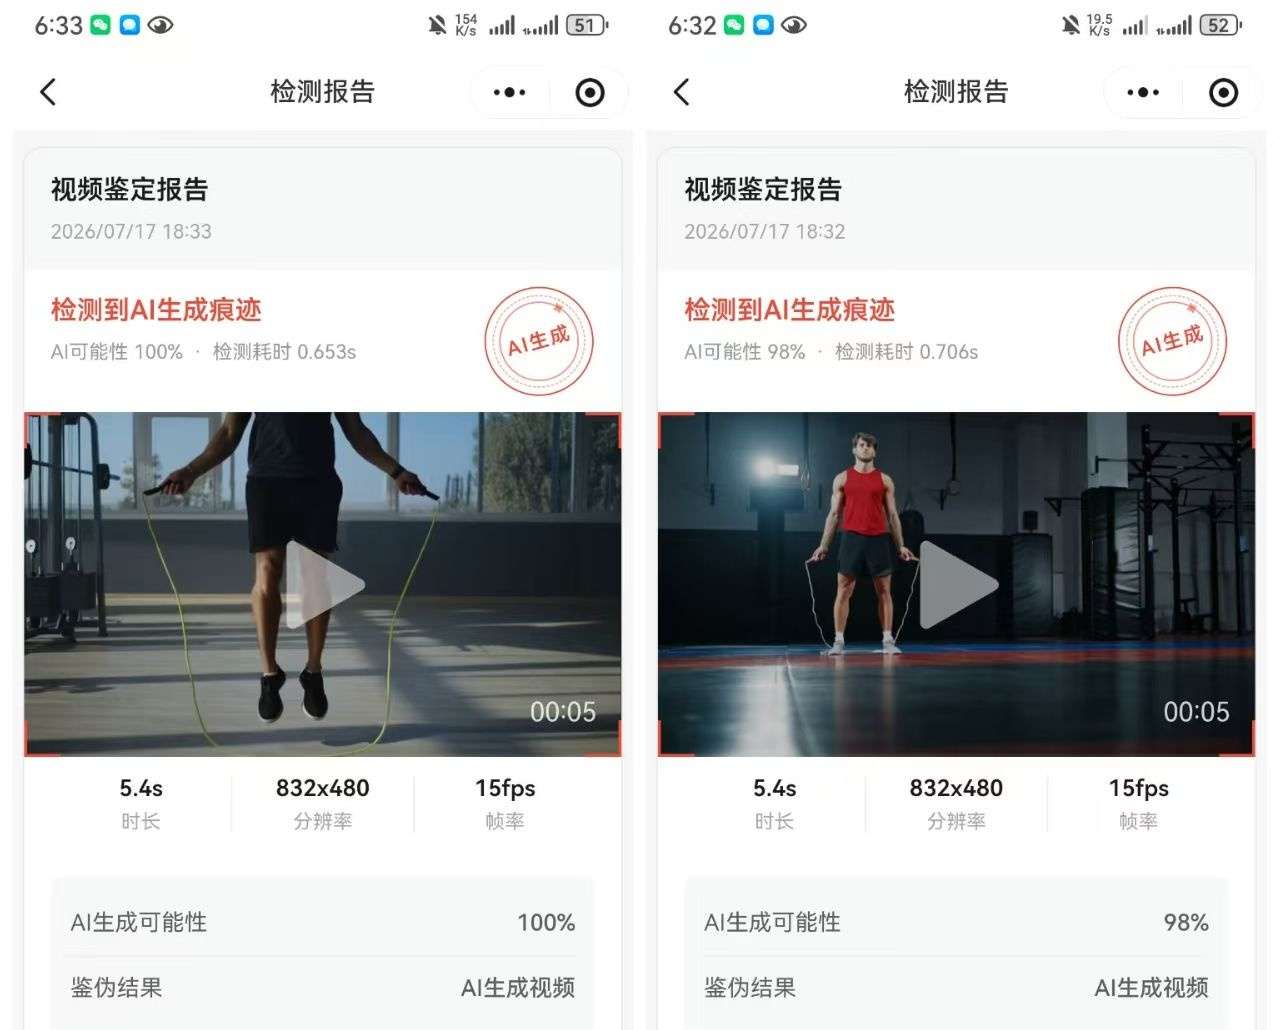
视频检测:时序连续性的精准捕捉 两段5.4秒的AI跳绳视频,规格为832×480、15fps,分别获得100%和98%的分数,耗时均低于0.7秒。跳绳动作涉及人体四肢、绳体轨迹及起落节奏的连续因果关系,是检验视频鉴伪能力的理想样本。系统通过同时分析时序动态信息(如运动规律)和静态特征(如单帧语义和频谱伪影),实现了快速且准确的检测。
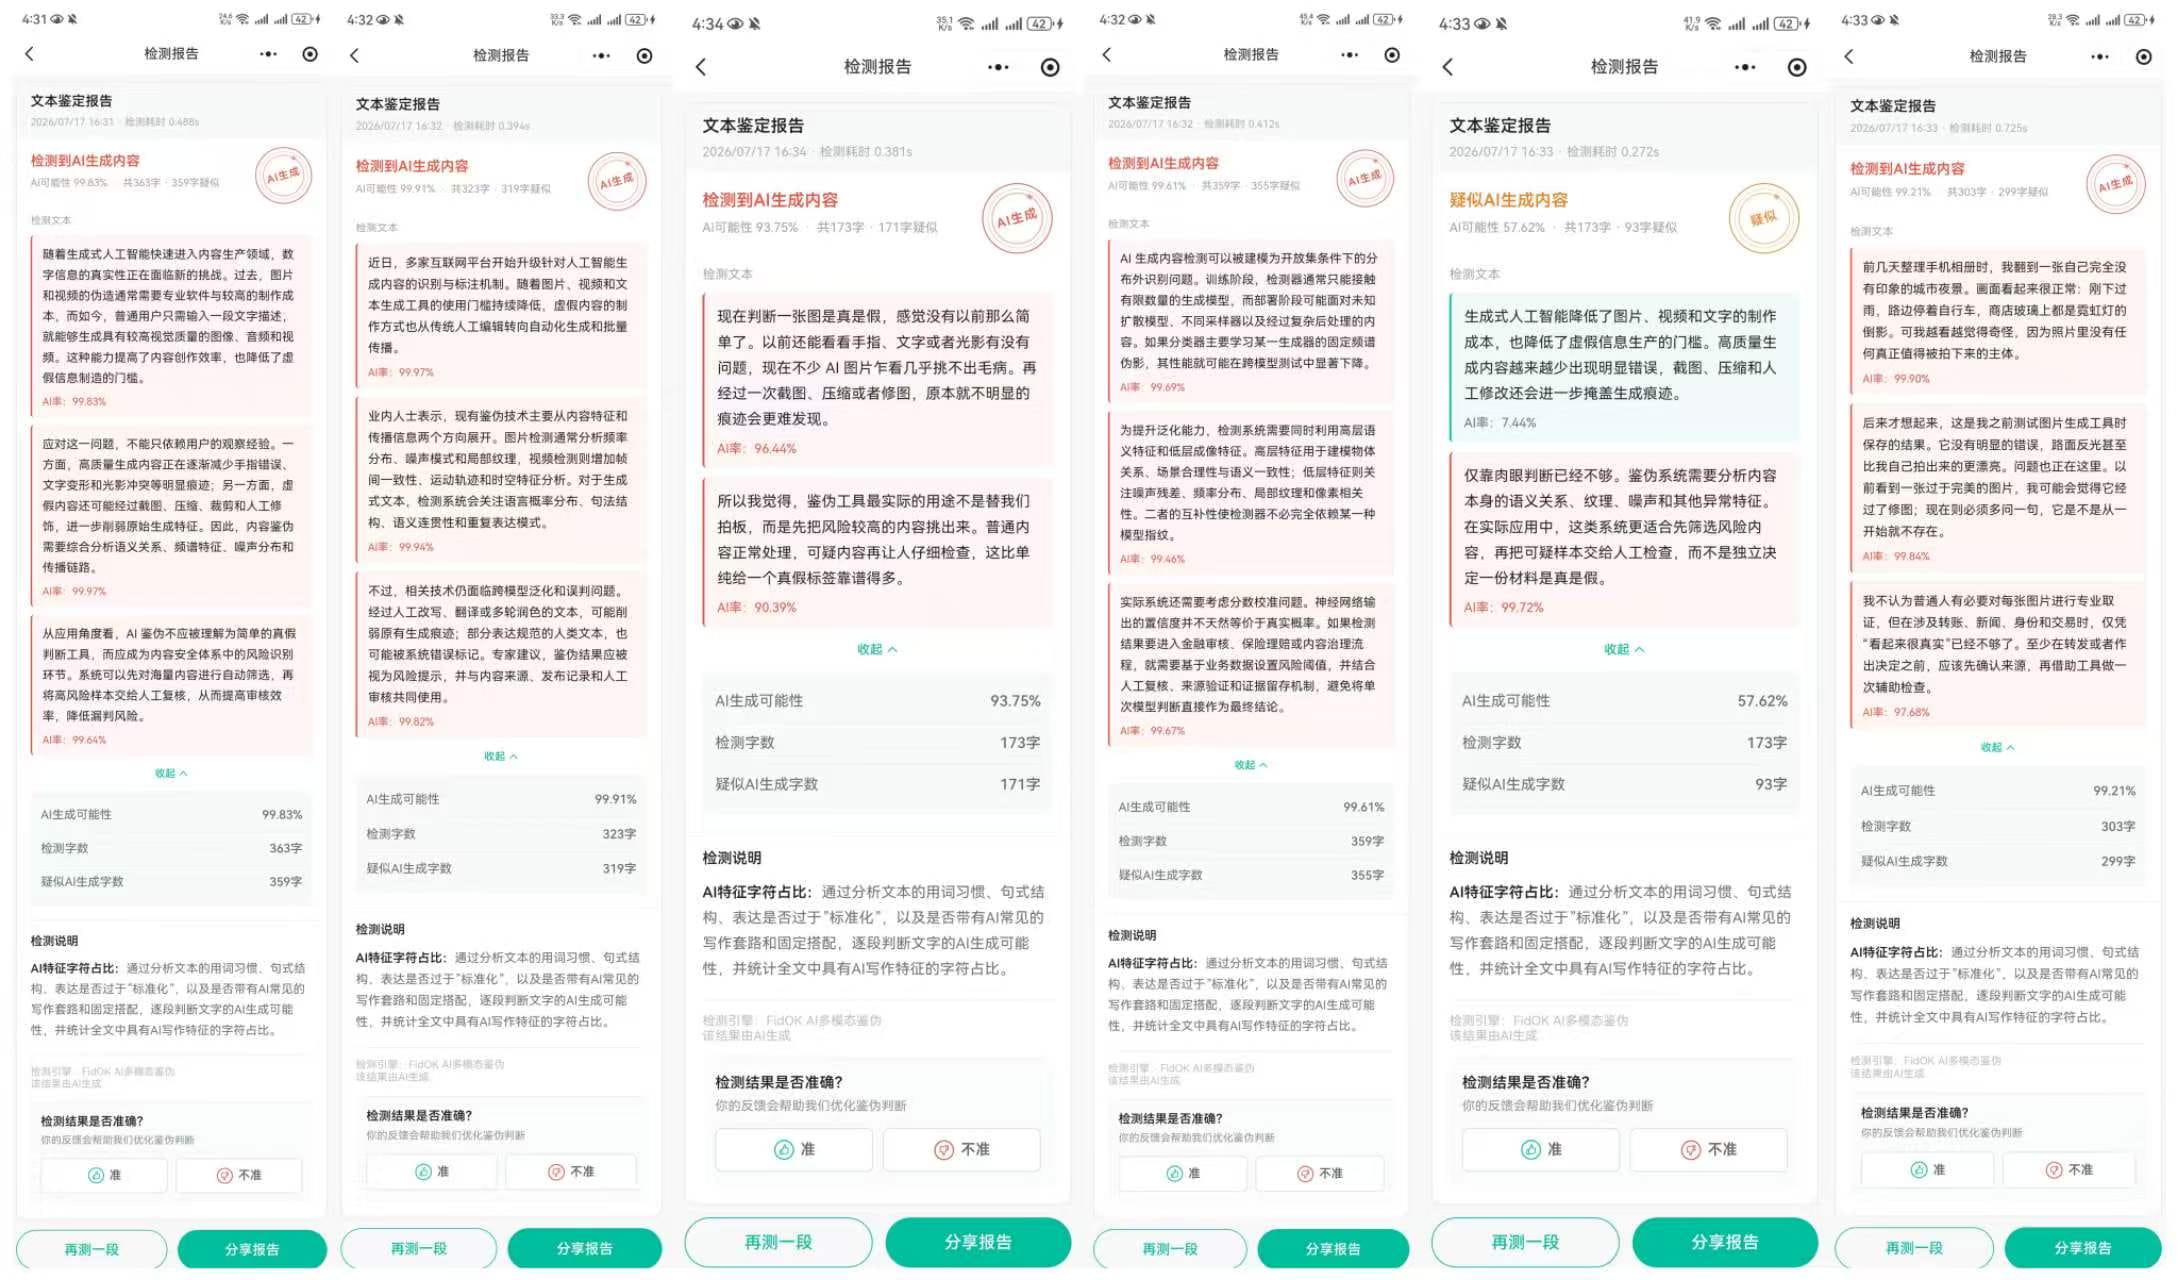
文本检测:边界样本的区分能力 6段AI生成文本(涵盖科普、新闻、口语、技术、压缩改写及个人叙事)均被识别。其中,长文本及结构化表达样本分数超过93%。值得关注的是,“压缩改写短文”的分数降至57.62%,系统将其标记为“疑似AI生成”而非绝对结论。这一结果体现了检测器的区分能力:短文本因样本量少、结构信号弱,检测置信度自然降低,系统通过表达不确定性而非强行给出高分,增强了工具的可信度。
行业前沿理论在应用中的映射
AIDE与FakeShield代表了当前图片鉴伪的两个技术坐标:前者解决“面对新模型能否识别”的泛化问题,后者解决“识别后能否解释”的可复核问题。本次实测中,扫描全能王AI鉴伪在多场景分类、快速输出及文本片段标记上已形成闭环。
FakeShield的技术思路尤其适合局部篡改场景。当篡改区域比例ρ很小时,全局特征可能被稀释,因此从分类走向定位与解释,是鉴伪产品服务高风险业务的关键方向。未来,增加图片可疑区域热力图、视频异常时间段标记及更细粒度的证据解释,将进一步提升审核效率。
用户体验与业务价值:从实验室到日常场景
此次实测中,产品的四个细节尤为突出:统一的跨模态入口降低了用户使用门槛;亚秒级的响应速度使其能嵌入“转发前、付款前、采信前”的动作流;分数与片段标记提供了层次化的风险参考;而贴近支付截图、聊天红包等真实风险的样本设计,让技术更具落地价值。
在实际部署中,AI鉴伪并非替代人类做最终裁决,而是作为内容风险的第一道关卡,构建“内容输入→自动鉴伪→风险分级→人工复核→业务处置”的自动化链路。对于金融、电商及媒体平台,这种可规模化的自动初筛能力,能显著降低人工审核成本,将有限的人力资源集中于高风险材料,从而提升整体安全效率。
结语:验证成为新常态
当AI生成内容从明显的视觉异常转向隐蔽的统计与语义异常,仅凭肉眼经验已无法覆盖所有风险。合合信息此次展示的跨模态鉴伪技术,通过整合高频图像、时序分析及文本统计特征,为应对这一挑战提供了有效方案。随着生成式AI技术的持续进化,内容鉴伪将从专业的取证流程转化为类似扫码查真般的日常习惯,成为数字时代信息信任体系的重要基石。