AI算力军备赛:为何“超节点”成为巨头博弈的终极生死线?
在刚刚落幕的世界人工智能大会上,一个显著的变化令人瞩目:曾经作为主角的大模型算法,其风头正被“超节点”这一基础设施概念逐渐取代。在展馆的核心区域,“超节点”不仅占据了C位,更成为了行业讨论的焦点。这一现象并非偶然,而是AI发展进入深水区后的必然结果。当大模型的参数量从千亿迈向万亿,算力的需求逻辑发生了根本性重构——从追求单点性能的极致,转向追求大规模集群的系统协同能力。超节点,作为由多个计算节点通过高效互联协议紧密连接而成的“一台计算机”,正成为这场基础设施战争的核心战场。
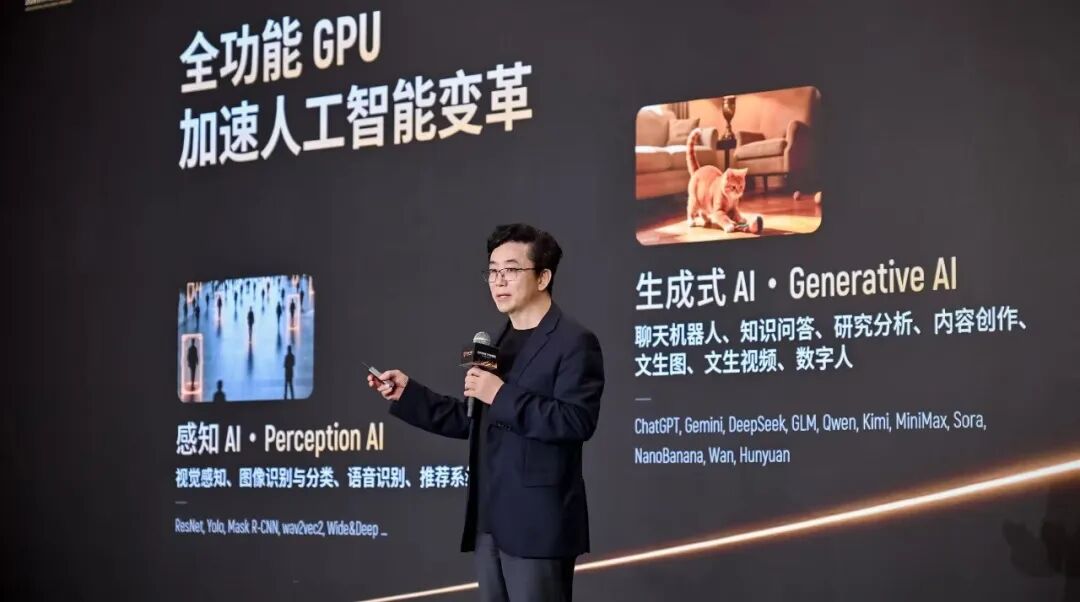
从“单机八卡”到“十万卡”集群的范式跃迁
超节点的崛起,底层逻辑在于大模型规模化的无休止竞赛。随着智谱、月之暗面等头部模型公司不断推出拥有数万亿参数的大模型,算力瓶颈已从算法层面转移到了基础设施层面。传统的“单机八卡”模式已无法支撑如此庞大的计算需求,算力集群正迅速向万卡甚至十万卡规模演变。
这种规模的跃迁直接推动了资本市场的狂欢。2026年上半年,紫光股份、浪潮信息等算力基础设施厂商股价大幅上涨,市值飙升。这背后是供需关系的极端紧张。一位服务器厂商高管透露,目前互联网巨头在采购时,第一句话往往是询问是否有十万片的供应能力,若无则免谈。这种需求已经前置到了2027年甚至2028年。超节点不再仅仅是技术概念,而已成为衡量厂商实力的“硬通货”,甚至被戏称为资本市场的“造富机器”。
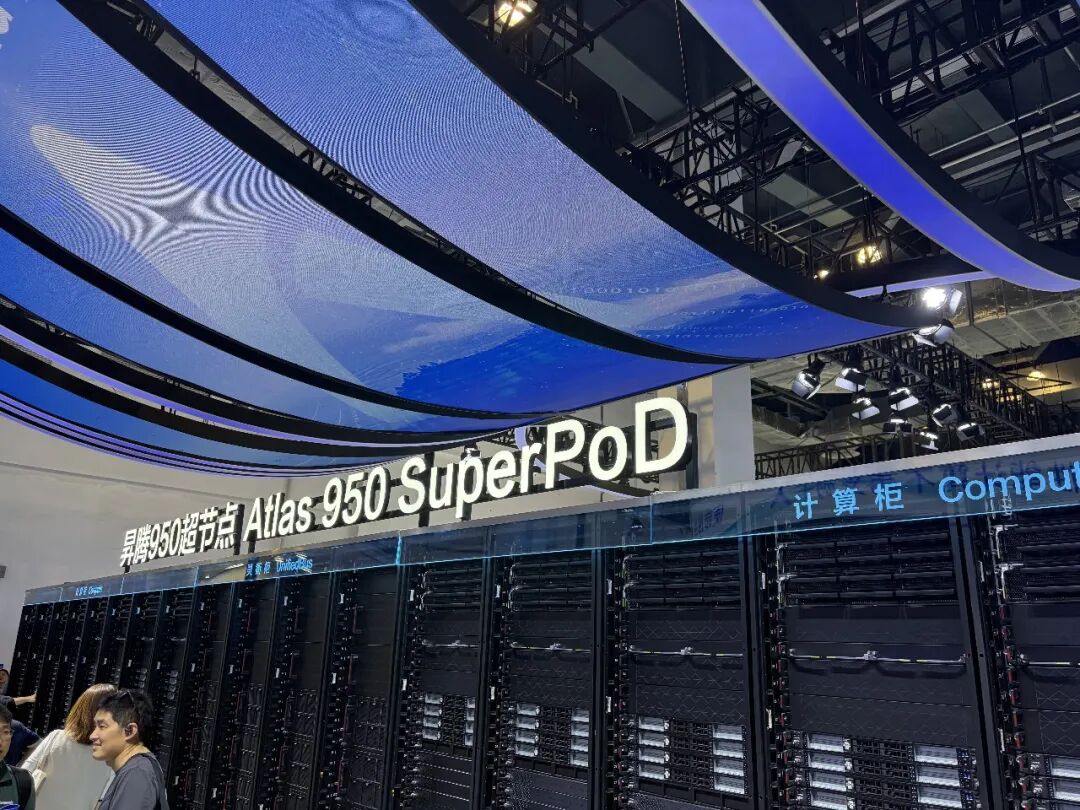
然而,规模的扩张并非简单的加法。新华三在杭州建设的AI超级工厂,单个点位功率高达240至300千瓦,这标志着算力密度进入了全新的量级。华为发布的昇腾950超节点,以及中兴通讯的OEX超节点,均在展示其从32卡到1024卡乃至更大规模的交付能力。这种规模化趋势,意味着谁掌握了超节点的产能,谁就掌握了通往未来AI世界的门票。
全栈自研与开放生态:两条技术路线的殊途同归
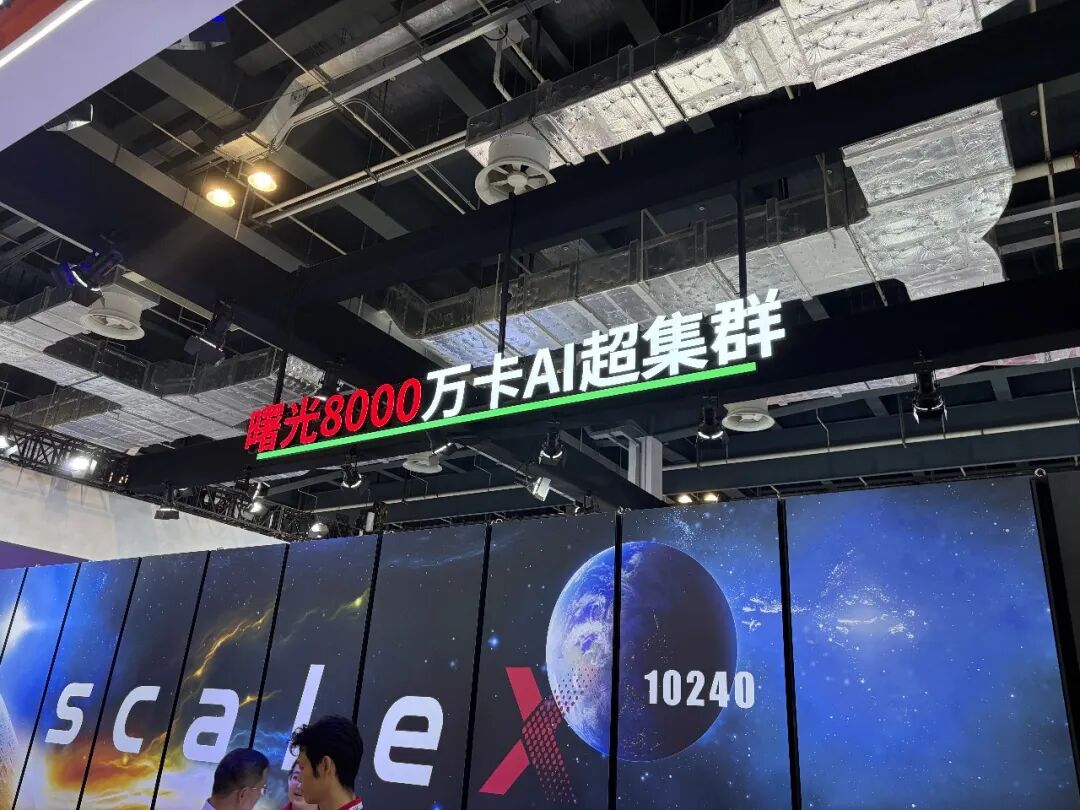
在超节点领域,各家厂商的技术路线呈现出明显的分化,但目标一致:解决大规模集群的系统协同问题。华为选择了一条极致的全栈自研路线,从芯片架构、互联协议到散热系统,实现层层向上延伸的深度协同。这种路线的优势在于整体系统效率远高于独立堆砌,但其研发体量之大、难度之高,也构成了极高的壁垒。
与之相对,中兴通讯联合壁仞科技、沐曦股份等多家合作伙伴,走的是开放生态、多芯协同的路线。这种策略不押注单一芯片,允许客户在不同算力芯片之间灵活组合,降低了锁定风险,增强了系统的适应性。阿里平头哥、百度昆仑芯等厂商也推出了各自的超节点产品,更强调推理效率和性价比,服务于特定的垂直场景。
正如芯和半导体副总裁仓巍所指出的,判断最终格局还为时尚早。真正的竞争焦点不在于算力数字的大小,而在于系统工程的完整性。从芯片、互联到软件栈、运维工具,能否用一套完整的产品和系统能力交付给客户,而非单点优势,将是决定胜负的关键。这种多元格局的形成,意味着不同厂商将在不同的应用场景和客户群体中占据各自的优势地位,而非简单的赢者通吃。
超级工程的挑战:成本、运维与物理极限
尽管超节点性能强大,但其高昂的成本和复杂的运维挑战,使其目前仍是大厂的游戏。据估算,超节点产品的投入可能在数百万元至几千万元之间。对于中小型企业而言,除非拥有极高的Token吞吐效率和明确的ROI(投资回报率)模型,否则自购超节点并非最优解。这也催生了算力租赁和智算中心运营平台的兴起,如九章云极致力于打造类似“高速公路和换电站”的算力资产运营平台。
除了经济账,物理层面的挑战更为严峻。超节点表面上的“耗电多”,深层考验的是整个供电链路的协同设计。机柜内的热分布不是简单的风扇堆砌,而是芯片功耗、封装热阻与液冷板流量设计的复杂耦合。华为展示的无需高昂液冷改造的风冷超节点,正是解决了高密度智算升级中的这一难题。
互联方面,随着集群规模增大,纯铜缆互联在带宽和距离上已触及天花板,光互联成为必然选择。但光模块对温度极度敏感,与高功耗AI芯片封装在一起,带来了电、光、热三个物理场的全新设计挑战。这些复杂的技术瓶颈,使得系统工程师在科技大厂中的地位日益提升,他们成为连接芯片物理特性与系统性能需求的关键桥梁。
算力重构:GPU不再是唯一的核心
在超节点的系统工程中,一个有趣的现象是GPU的重要性相对下降,而CPU、存储和网络交换卡的系统优化权重上升。2025年,超节点架构中GPU与CPU的比例约为8:1或4:1,但预计到2026年,这一比例可能变为1:2甚至1:1。
这一变化的背后,是智能体(Agent)多轮推理对CPU调度和内存的依赖增加。在复杂的任务流中,CPU承担了大量的记忆系统工作、任务分配和上下文管理,而NPU(神经网络处理单元)更多时候沦为CPU的协处理器。这种“CPU为中心”的通算整机柜趋势,反映了AI工作负载从单一训练向复杂推理和交互转变的现实。
然而,CPU需求的激增也带来了供应链的紧张。英特尔上调服务器CPU售价,HBM和高带宽内存同样供不应求。存储的价值不再仅仅是容量,更体现在带宽和低时延能力上,以支持智能体的长期记忆和知识库检索。供应链的价格波动和交付周期拉长,正在指挥着超节点市场的狂飙节拍,也让这场算力战争更加残酷和充满不确定性。
结语:基础设施能力的终极博弈
超节点的兴起,标志着AI竞争进入了一个新的维度。它不再仅仅是算法的较量,而是底层基础设施系统工程能力的比拼。无论是全栈自研的封闭生态,还是开放多芯的协同架构,核心都在于能否在物理极限、成本约束和商业需求之间找到最佳平衡点。
未来,随着模型参数规模的持续跃升,算力需求的基准线将不断上推。超节点将成为支撑前沿模型诞生的“模型工厂”和“Token生产工厂”。在这场战争中,能够提前布局、掌握核心互联技术、优化系统能效比的厂商,将在2026年乃至未来的AI基础设施市场中占据主导地位。这不仅是算力的争夺,更是对产业链控制力、技术创新力和生态整合力的全面检验。对于行业参与者而言,理解超节点的深层逻辑,才能在算力成生死线的时代,找到确定的生存与发展之道。