重构听觉体验:基于魔珐星云TTS的具身交互有声书开发实战
在数字化内容消费日益碎片化的今天,传统的视觉阅读正面临注意力稀缺的挑战。与此同时,听觉经济悄然崛起,有声书市场呈现出爆发式增长态势。然而,传统有声书制作依赖专业配音员录制,不仅周期漫长,且成本高昂,难以覆盖海量的长尾内容。随着人工智能技术的演进,特别是文本转语音(Text-to-Speech, TTS)技术的突破,一种全新的“具身交互”阅读模式应运而生。这种模式不仅解放了用户的双手与双眼,更通过拟人化的语音交互,为视障人士及多场景学习者提供了平等的信息获取渠道。
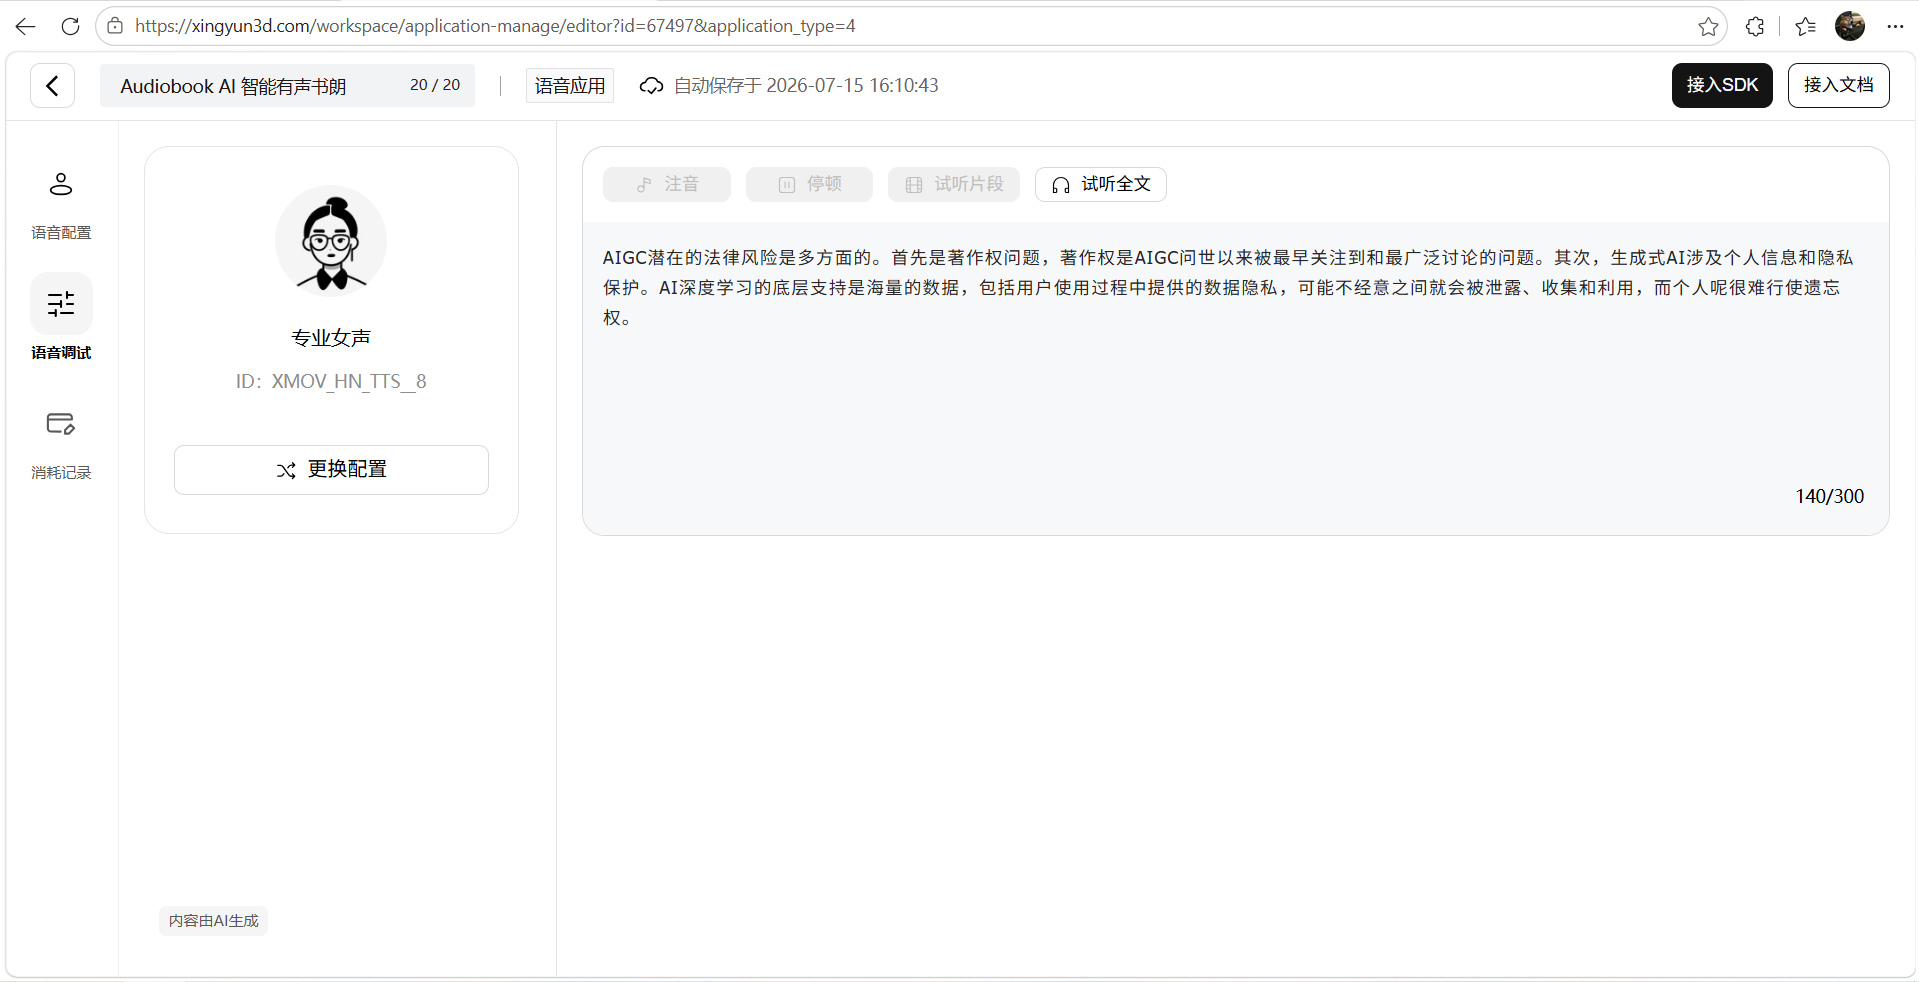
构建一个现代化的具身交互智能有声书平台,核心在于解决语音合成的自然度、实时性以及前端交互的流畅性。在众多技术方案中,魔珐星云凭借其深厚的深度学习积累,提供了高保真、低延迟的TTS服务,成为构建此类应用的理想基石。本文将摒弃泛泛而谈的理论介绍,直接从工程落地视角出发,详细阐述如何基于React 18、TypeScript和Vite技术栈,结合魔珐星云的全域具身交互智能配套TTS引擎,从零搭建一个支持实时流式播放、文字同步高亮及多音色切换的专业级有声书平台。
技术选型与架构设计的深层逻辑
在启动项目之前,技术栈的选择直接决定了系统的可维护性与扩展性。前端框架选用React 18,其并发特性能够有效处理高频的音频数据流与UI更新之间的竞争关系,确保界面在大量数据涌入时依然保持响应灵敏。TypeScript的引入则是为了在复杂的音频处理逻辑中提供严格的类型约束,减少运行时错误。构建工具方面,Vite凭借其基于ESBuild的快速冷启动和热更新能力,极大提升了开发效率。
系统架构的核心挑战在于网络通信与安全鉴权。魔珐星云的TTS服务通过WebSocket协议提供流式数据传输,以实现“边合成边播放”的低延迟体验。然而,浏览器的WebSocket API存在一个显著限制:无法在握手阶段自定义HTTP Headers。而魔珐星云的鉴权机制要求将App ID、时间戳和MD5签名通过Headers传递。这一矛盾迫使我们在客户端与服务端之间引入一个轻量级的Node.js代理服务器。
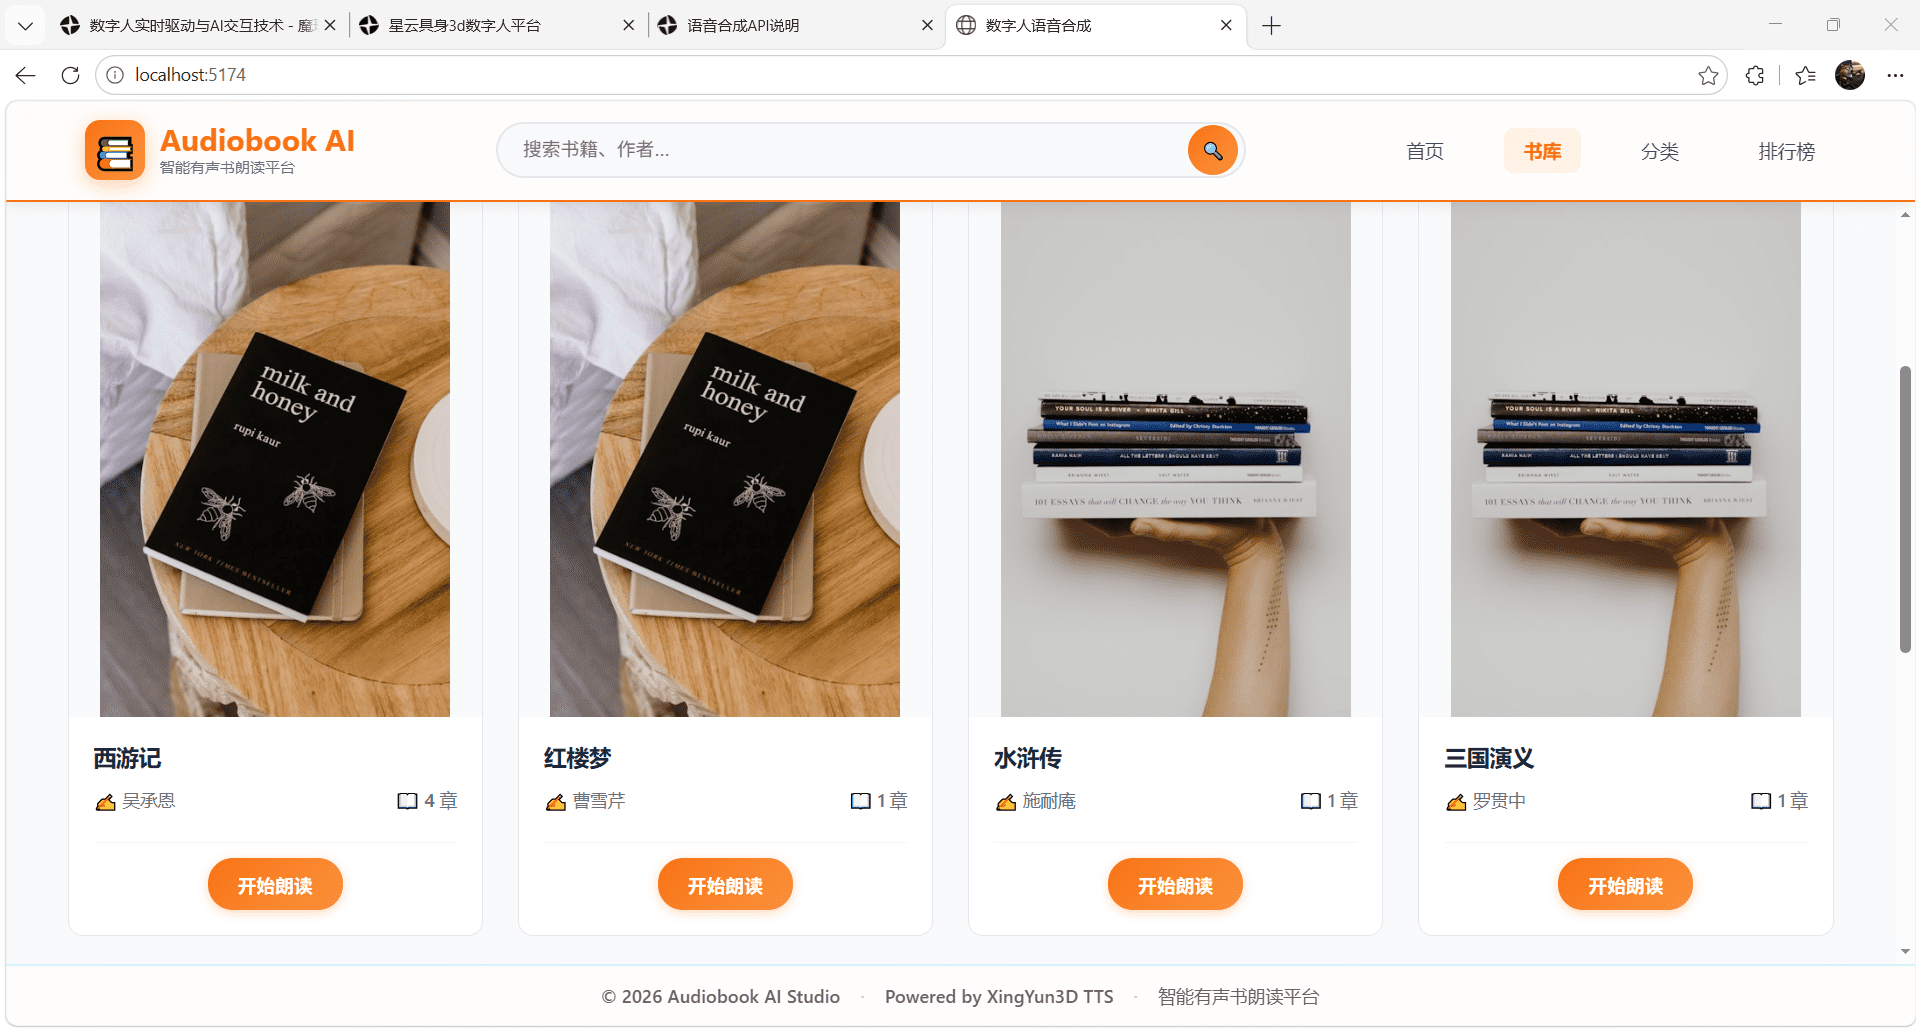
该代理服务器充当了“中间人”角色。前端应用通过本地WebSocket连接至代理服务器,将鉴权参数作为URL查询字符串传递。代理服务器接收连接后,解析这些参数,重新构建带有正确Headers的WebSocket连接请求,转发至魔珐星云的云端服务。这种设计既规避了浏览器的限制,又将敏感的密钥管理保留在后端或本地开发环境中,保障了安全性。整个数据流向清晰明确:前端发起请求 -> 本地代理添加鉴权头 -> 魔珐云端合成音频 -> 音频流经代理返回 -> 前端解码播放。
安全鉴权与代理服务的实现细节
魔珐星云采用基于MD5的签名鉴权机制,这是保障API调用安全的第一道防线。签名的生成过程需要严格遵循特定算法:首先对请求参数进行JSON序列化并排序,去除所有空格,然后将URL、HTTP方法、排序后的参数字符串、App Secret以及当前秒级时间戳拼接成一个字符串,最后对该字符串进行MD5哈希计算。任何顺序的错误或空格的遗漏都会导致签名验证失败。
在前端代码中,我们需要封装一个通用的鉴权生成函数。该函数接收请求方法、URL路径和数据对象,自动完成上述计算过程,返回包含X-APP-ID、X-TIMESTAMP和X-TOKEN的请求头对象。值得注意的是,URL必须包含完整的查询参数,因为这部分内容也参与签名计算。此外,时间戳的使用不仅用于签名,还能防止重放攻击,确保每次请求的唯一性。
由于浏览器端的限制,我们必须在本地搭建一个Node.js代理服务。利用ws库,我们可以轻松创建一个WebSocket服务器。当客户端连接时,服务器从URL中提取鉴权参数,然后向魔珐星云的官方地址发起新的WebSocket连接,并将提取的参数填入HTTP Headers中。一旦上游连接建立,代理服务器只需简单地在客户端Socket和上游Socket之间双向转发消息即可。这种透传模式几乎不增加额外的延迟,却完美解决了跨域和鉴权头缺失的问题。
PCM音频流的实时解码与播放策略
魔珐星云返回的音频数据并非标准的MP3或WAV格式,而是原始的PCM(脉冲编码调制)数据。PCM数据未经压缩,保留了最原始的波形信息,适合实时流式处理,但也给前端播放带来了挑战。浏览器原生的<audio>标签无法直接播放PCM流,因此我们必须使用Web Audio API进行手动解码和播放。
首先,接收到的音频数据通常是Base64编码的字符串。我们需要将其解码为二进制数组,再转换为Uint8Array。关键在于理解PCM数据的结构:魔珐星云默认输出的是16位有符号整数(Int16),采样率为24000Hz。这意味着每两个字节代表一个采样点,且数据范围在-32768到32767之间。
在解码过程中,我们需要遍历字节数组,每两个字节组合成一个16位整数。由于JavaScript中的位运算通常处理32位整数,我们需要小心处理字节序和符号位。如果读取到的无符号值大于32767,则需减去65536以得到正确的有符号值。随后,将这些整数值归一化到-1.0到1.0的浮点数范围,填入AudioBuffer的通道数据中。为了避免音量过大导致爆音,通常会引入一个0.8左右的增益系数。
为了实现流畅的播放体验,不能简单地每收到一个数据包就创建一个新的AudioBufferSourceNode并立即播放,这会导致声音断续。正确的做法是维护一个播放队列。当第一个音频块到达时,立即创建源节点并播放;后续到达的音频块则排队等待。当前一个源节点播放结束时,触发onended事件,从队列中取出下一个音频块继续播放。这种串行播放机制确保了音频流的连续性,消除了卡顿感。
字符级时间映射与沉浸式交互体验
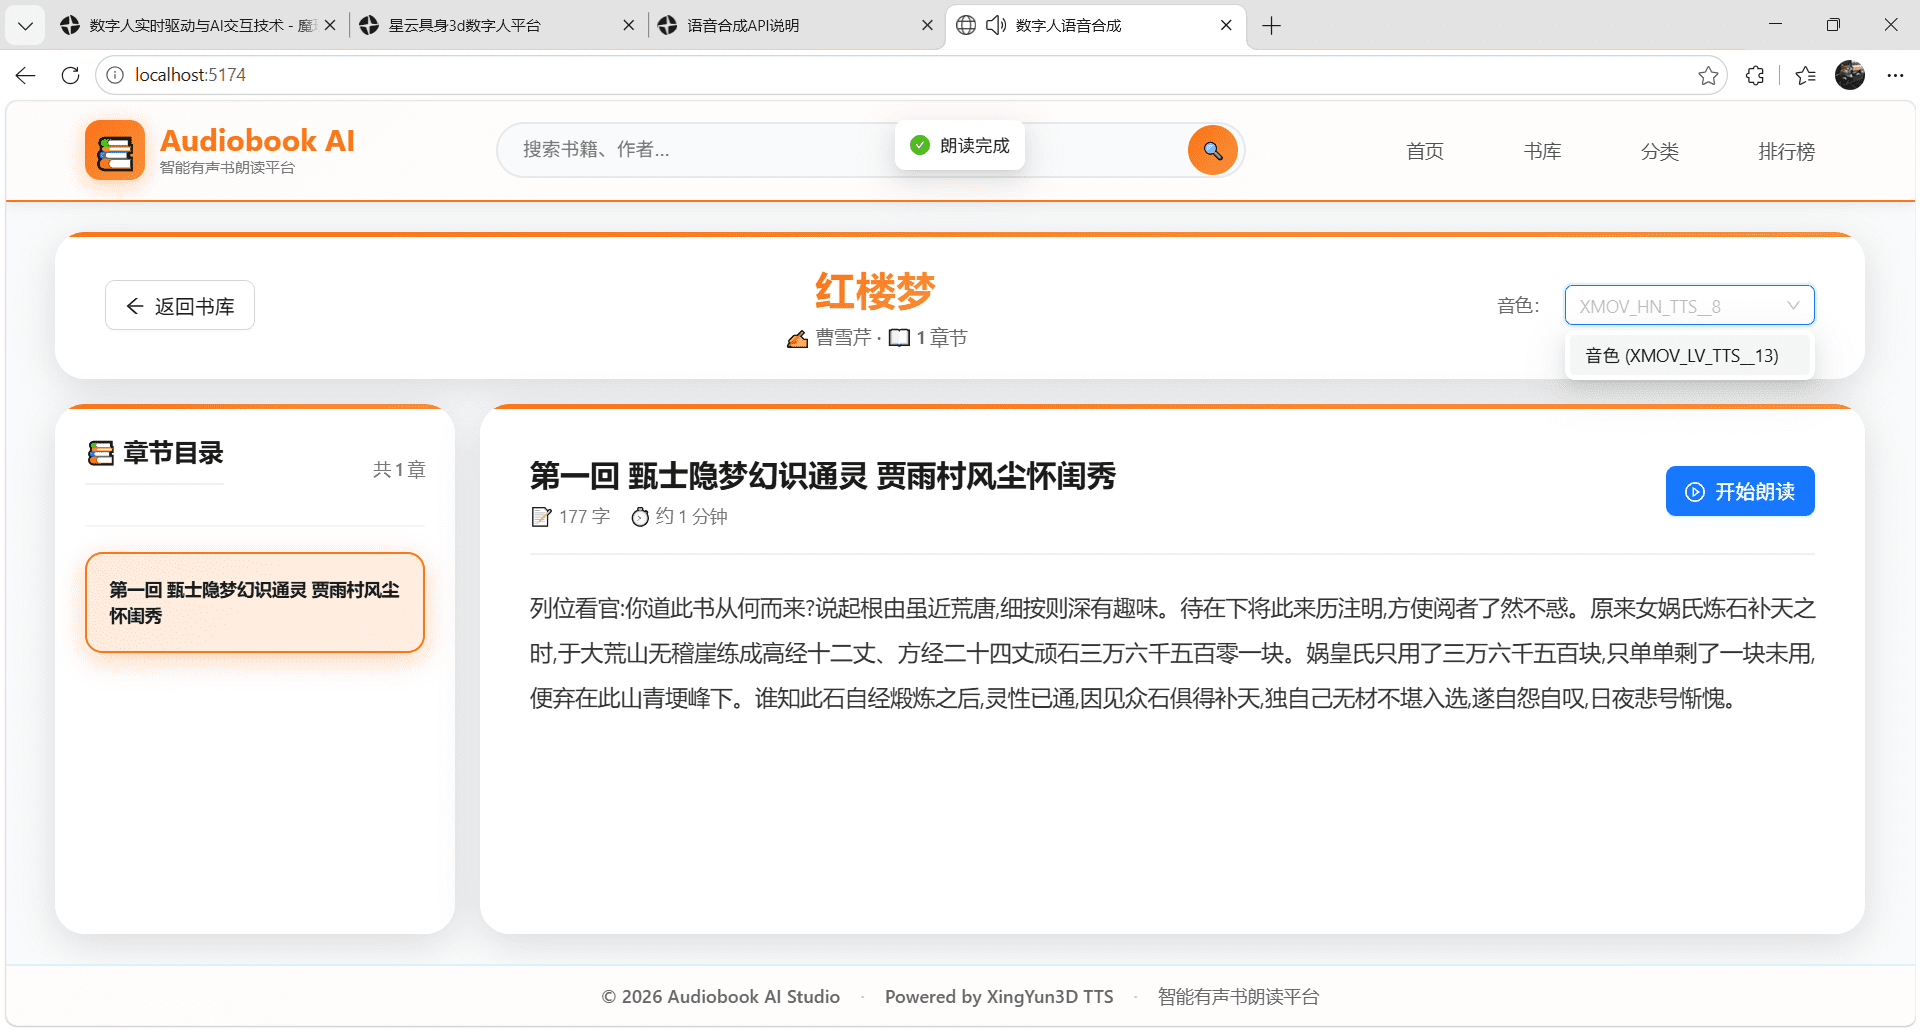
具身交互的核心在于“同步”。用户不仅希望听到声音,更希望看到文字随着语音的节奏逐字高亮,从而获得类似真人朗读的沉浸感。魔珐星云在返回音频数据的同时,还会发送一个特殊的CHAR_TIME_MAP数据类型,其中包含了每个字符在音频流中的起始时间和持续时间。
前端接收到这个映射表后,需要将其与当前章节的文本内容进行匹配。由于TTS引擎可能会忽略部分标点符号或对文本进行微调,直接按索引对应可能存在偏差。因此,更稳健的做法是根据字符内容和时间戳动态计算高亮状态。我们可以维护一个全局的时间计数器,随着音频播放进度递增,实时查找当前时间点应该高亮的字符索引。
在UI渲染层面,避免频繁的重排(Reflow)至关重要。直接将整个段落拆分为数千个<span>标签并进行样式切换,性能开销巨大。优化方案是采用虚拟滚动或仅渲染可视区域内的文本节点,或者使用CSS变量结合requestAnimationFrame来更新高亮位置。在实际项目中,可以将文本分割为句子或小段落,仅对当前正在朗读的句子进行细粒度的字符高亮,其余部分保持静态,从而在视觉效果和性能之间取得平衡。
此外,为了增强交互性,平台应支持用户点击任意文字跳转至对应的音频位置。这需要反向利用字符时间映射表,找到点击字符的起始时间,然后调整Web Audio API的播放偏移量,或重新发起TTS请求并从指定位置开始合成。虽然后者会增加网络开销,但能确保精确定位,特别是在长文本场景中更为可靠。
结语与未来展望
通过整合React的前端优势、Node.js的代理能力以及魔珐星云强大的TTS引擎,我们成功构建了一个具备商业级潜力的具身交互有声书平台。该系统不仅解决了技术层面的鉴权、解码和同步难题,更在用户体验上实现了质的飞跃。从解放双眼的便捷性,到视障人士的无障碍支持,再到碎片化时间的高效利用,AI朗读技术正在重塑人们的阅读习惯。
未来,随着多模态大模型的发展,具身交互将不再局限于声音。结合数字人形象、情感识别以及上下文理解,有声书平台将进化为真正的“智能阅读伴侣”。它能够根据故事情节自动调整语调和背景音乐,甚至根据读者的反馈实时调整朗读节奏。对于开发者而言,掌握底层的音频处理技术和流式通信架构,将是通往这一未来的关键钥匙。本文所提供的实践路径,仅为这一广阔领域的起点,更多的创新等待着我们去探索与实现。