端侧AI算力爆发:锐龙AI Max+如何重塑笔记本性能边界?
端侧算力的范式转移:从云端依赖到本地智能
随着人工智能技术向边缘端下沉,个人计算设备正经历一场前所未有的架构变革。传统PC算力主要集中在CPU和独立显卡(GPU),而在生成式AI爆发的当下,这种分散的算力模式已难以满足复杂本地模型运行的低延迟与高隐私需求。在2026年7月10日开启的Bilibili World(BW2026)上,AMD与联想的联合发布动作,标志着这一变革从概念验证走向了规模化商用阶段。
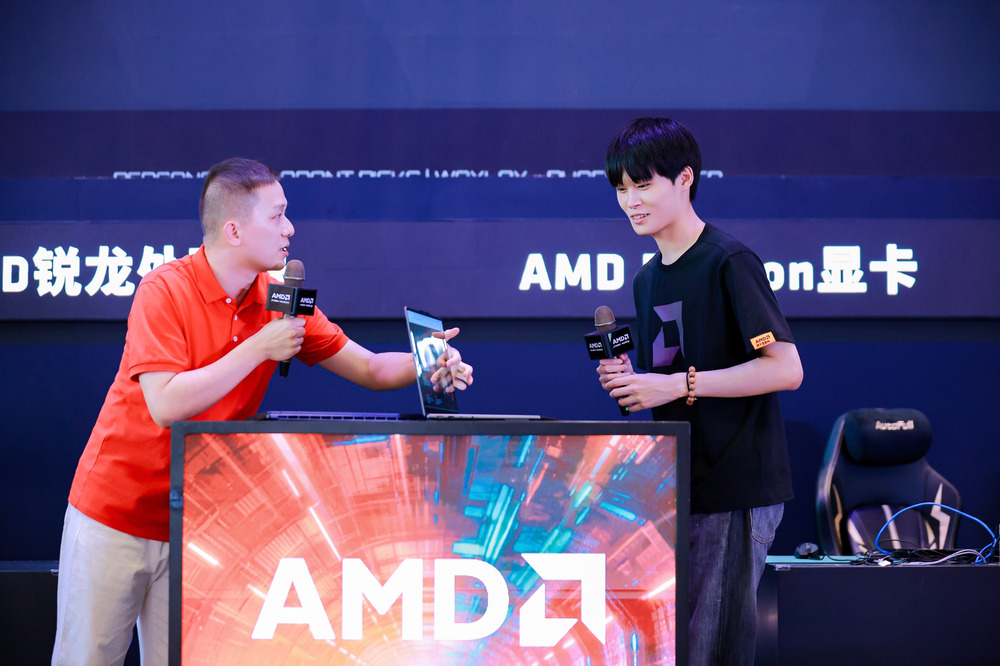
此次发布的核心在于两款基于全新锐龙AI Max+系列处理器的旗舰笔记本:YOGA Pro 15锐龙AI创作本与联想拯救者R9000X游戏本。这并非简单的硬件迭代,而是通过整合CPU、GPU与NPU(神经网络处理单元)的异构计算架构,重新定义了移动设备的性能边界。对于追求极致效率的内容创作者和硬核玩家而言,这意味着计算不再受限于网络带宽,而是回归到设备本身,实现了算力与便携性的完美平衡。

统一内存架构:打破数据搬运瓶颈的关键

在传统计算架构中,CPU与GPU各自拥有独立的显存和内存。当处理大型AI模型或高分辨率视频素材时,数据需要在两者之间频繁复制与传输,这不仅消耗大量时间,还受限于总线带宽,成为制约性能的“数据墙”。
此次亮相的锐龙AI Max+系列处理器,其核心突破在于采用了先进的统一内存架构(UMA)。YOGA Pro 15与拯救者R9000X均配备了64GB大容量统一内存,支持四通道256bit高带宽访问。这一设计允许CPU、GPU以及NPU共享同一块物理内存池,最高可将48GB内存动态分配给图形处理或AI推理使用。
这种架构的优势在运行大规模参数模型时体现得淋漓尽致。以YOGA Pro 15为例,得益于高带宽与统一内存,它能够直接在本地流畅部署并运行70B参数级别的大语言模型。相比之下,传统PC由于显存限制,往往需要依赖云端API或大幅缩减模型规模才能勉强运行。统一内存架构不仅提升了数据吞吐效率,更通过减少数据冗余拷贝,显著降低了功耗,为轻薄机身实现高性能释放提供了物理基础。
双旗舰差异化定位:精准切入两大核心场景
AMD与联想此次推出的两款产品,并非简单的同质化竞争,而是基于锐龙AI Max+系列的两款不同规格处理器,精准切入了“专业创作”与“高性能游戏”两个截然不同的用户群体。
YOGA Pro 15:移动工作站的重构
YOGA Pro 15锐龙AI创作本定位高端创意生产力,其搭载的锐龙AI Max+ 388处理器采用8核16线程设计,虽核心数少于旗舰型号,但单核性能保持一致,确保了日常交互的极致响应速度。其核心竞争力在于配备了Radeon 8060S集成显卡与50 TOPS算力的XDNA 2 NPU。
对于视觉创作者而言,这款设备的显示与交互系统进行了针对性优化。屏幕峰值亮度达到1100尼特,并拥有双PANTONE色彩认证及出厂逐屏校准,确保了户外强光下的可视性与色彩准确性。此外,全域压感触控板支持4096级压感笔操作,配合Wacom官方认证,使得直接在屏幕上草图构思、精细修图成为可能。1.7kg的机身重量与强大的本地AI处理能力,使其成为移动办公与户外创作的得力助手。
拯救者R9000X:轻薄与性能的极致平衡
拯救者R9000X则面向追求极致性能的游戏玩家与电竞选手。它搭载了更顶级的锐龙AI Max+ 392处理器,拥有12核心24线程,最高加速频率可达5.0GHz,基于Zen 5架构构建。尽管没有配备独立显卡,但凭借Radeon 8060S的强大图形能力与120W的整机电机性能释放,它依然能够流畅运行主流3A大作。
该机型的轻薄化设计令人印象深刻,整机重量仅1.55kg,厚度控制在15.9mm,是目前市面上最轻薄的AMD锐龙AI Max系列游戏本。2.5K分辨率、165Hz刷新率的OLED屏幕不仅提供了极致的画面流畅度,其高对比度特性也为视频剪辑与色彩校正提供了专业支持。1.5mm键程的键盘设计兼顾了游戏操作的精准度与长时间打字的舒适性,解决了高性能游戏本普遍存在的厚重与散热噪音痛点。

天禧AI 4.0:让本地大模型成为生产力工具
硬件算力的提升需要软件生态的配合才能转化为实际的用户价值。联想在此次新品中内置了自研的天禧AI 4.0系统,这是连接硬件算力与用户场景的关键桥梁。
天禧AI 4.0的核心功能是支持本地大模型的一键部署与调用。在YOGA Pro 15上,它化身为智能创作助手,能够快速完成文案撰写、创意发散、复杂文档总结以及素材处理。对于拯救者R9000X用户,AI则能辅助游戏技巧分析、实时渲染加速以及社区内容生成。
这种本地化部署具有三大显著优势:首先是数据隐私安全,敏感工作数据无需上传云端,完全在本地闭环处理;其次是零延迟响应,摆脱了网络波动对即时创作的影响;最后是成本可控,无需按次或按量支付云端API费用。天禧AI 4.0的引入,标志着端侧AI从单纯的“功能演示”迈向了“即用型生产力工具”的新阶段。
技术底座解析:Zen 5与XDNA 2的协同效应
锐龙AI Max+系列处理器的强大性能,源于AMD在架构层面的深度整合。锐龙AI Max+ 392采用的Zen 5架构,在IPC(每时钟周期指令数)上实现了大幅提升,单核性能的增强使得操作系统响应、应用加载速度以及游戏帧率的稳定性得到保障。
图形部分集成的Radeon 8060S,拥有40个计算单元,其图形性能已接近部分入门级独立显卡水平。更重要的是,与之搭配的XDNA 2架构NPU,专为AI负载优化,50 TOPS的算力足以应对目前主流的多模态大模型推理需求。CPU、GPU与NPU在统一内存架构下协同工作,避免了传统异构计算中的资源冲突与带宽瓶颈,实现了能效比的最大化。
行业影响:移动端AI生态的重构契机
此次AMD与联想在BW2026的合作发布,不仅是两款新品的亮相,更是对整个PC行业的一次战略指引。它证明了在移动设备上实现高精度AI推理的可行性,同时也展示了无需独立显卡即可满足高性能图形与AI运算的技术潜力。
对于内容创作者而言,这意味着工作流可以更加灵活,不再受限于固定工位或昂贵的工作站。对于游戏玩家,轻便的机身与强大的算力释放,使得“随时随地享受3A大作”成为现实。随着天禧AI等本地AI生态的完善,PC设备将从单纯的硬件载体,进化为具备感知、思考与执行能力的智能终端。
在BW2026展会的现场,观众可以通过千帧电竞区与锐龙AI PC体验区,亲身感受这些技术突破带来的流畅体验。随着7月10日至12日展期的进行,这款基于锐龙AI Max+系列的新品矩阵,正逐步向市场释放信号:移动计算的新篇章,已随着端侧算力的觉醒而正式开启。
