AI数据暴涨百倍:从标注工到研发核心,揭秘万亿级隐形冠军
在人工智能产业的宏大叙事中,算力与大模型往往占据聚光灯的中心,但一个更为隐秘却极具爆发力的细分赛道正在悄然重塑行业格局——AI训练数据。2026年的数据显示,这一领域不仅迎来了爆发式增长,更诞生了数家年收入突破十亿美元的商业巨头。这并非偶然,而是技术演进与市场需求双重共振的必然结果。
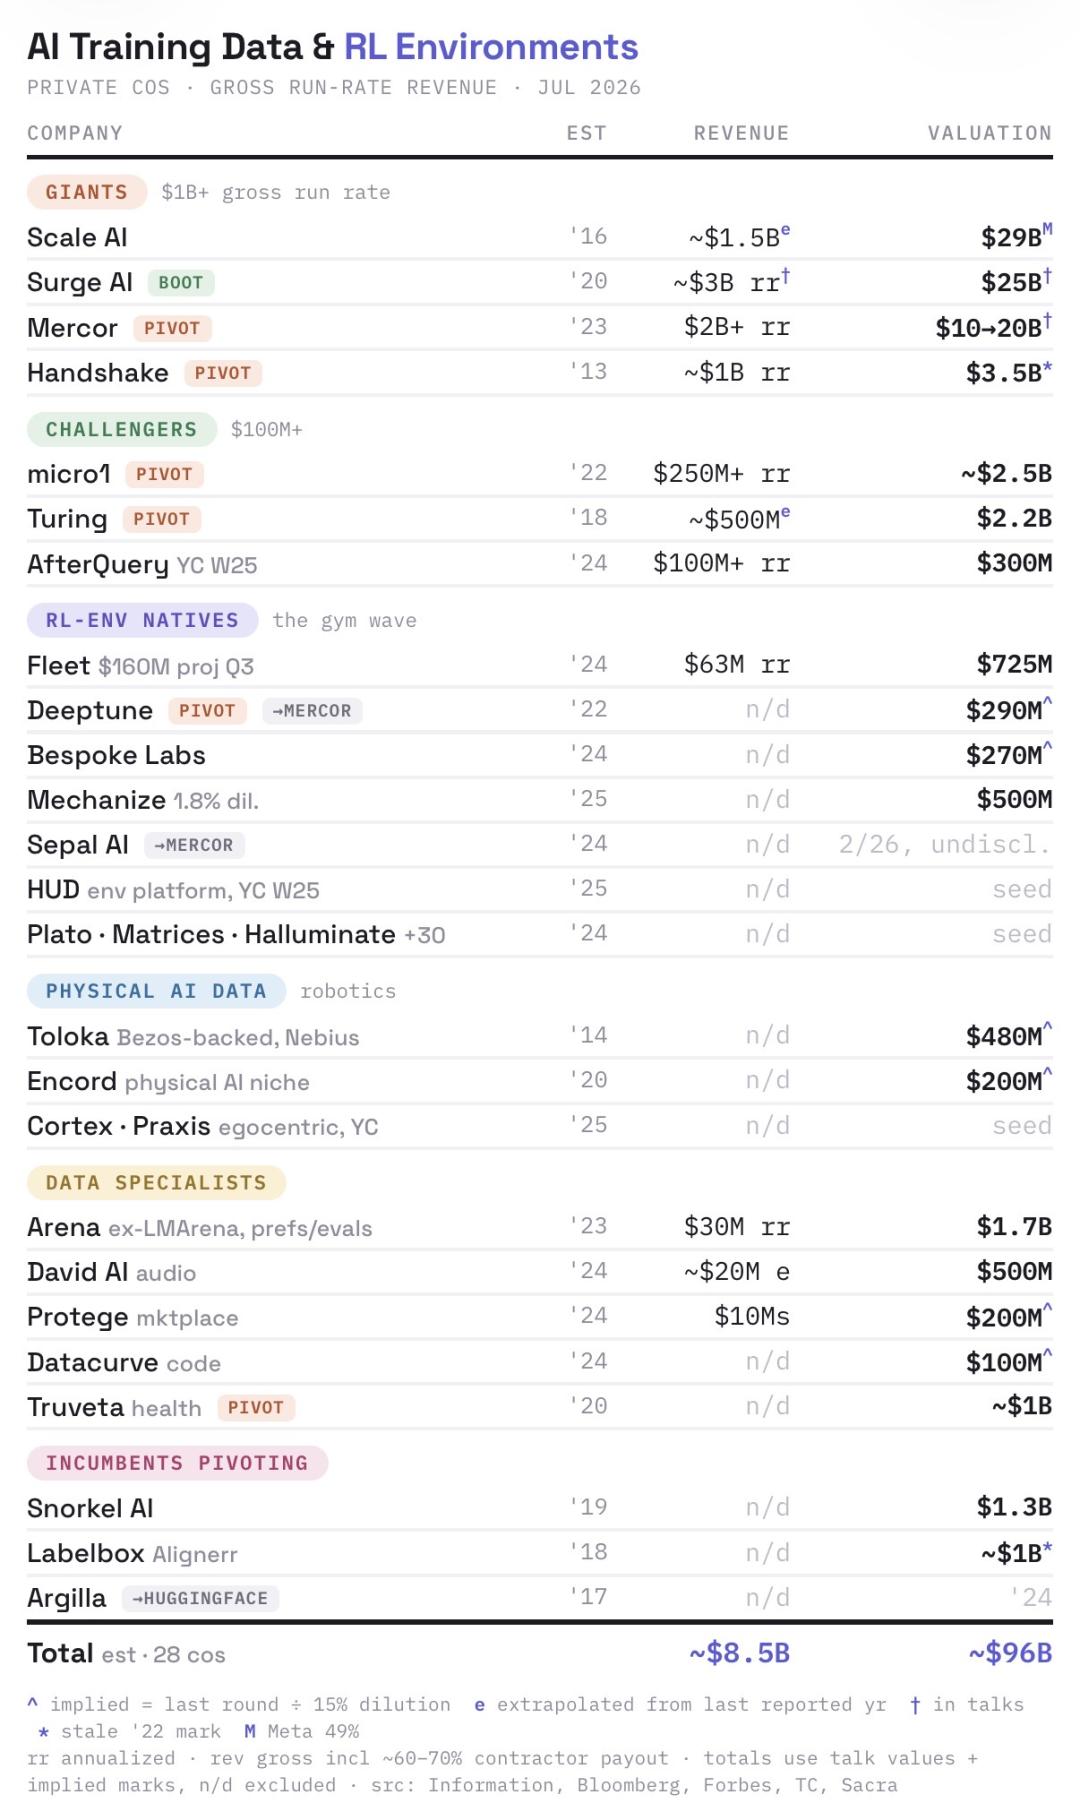
回顾Menlo Ventures发布的AI训练数据公司全景图,28家初创公司合计年收入约85亿美元,估值逼近千亿美元大关。仅从收入规模判断,AI数据已稳固占据继算力和大模型之后的AI产业第三大细分赛道位置。更令人震惊的是其增长斜率。以Mercor为例,2025年9月其年化收入尚为5亿美元,至2026年6月已突破20亿美元,短短九个月内规模翻了两番。而Handshake的增速更为夸张,从切入AI数据业务到年化收入逼近11亿美元,仅用时一年,实现了100倍的增长。这种爆发力在传统的科技行业中极为罕见,它标志着AI数据已从一个边缘的辅助环节,跃升为驱动模型进化的核心引擎。
这种爆发并非无源之水,其根本原因在于数据在大模型训练中的角色发生了本质性的范式转移。在过去,数据被视为一次性投入的原材料,类似于工业时代的钢铁或煤炭,项目制特征明显。实验室在启动大型训练前集中采购数据集,交付完成后便进入漫长的空窗期。然而,随着大模型迭代节奏的极速加快,数据已转变为持续消耗的燃料。
ChatG4的发布间隔从早期的数月缩短至数周,Anthropic等顶级实验室更是将迭代周期压缩至11天甚至更短。高频的迭代意味着模型能力缺口的发现频率激增,对新增、针对性高价值数据的需求从低频脉冲变为高频常态。供给端随之重构,Scale AI等头部玩家已将交付模式升级为API按需交付,客户发起任务后最快一小时即可获取生产级标签数据。这种实时响应能力,彻底打破了传统数据供应链的滞后性。
需求频次的提升只是第一重推手,单条数据的信息密度膨胀才是需求总量呈指数级增长的关键。以代码智能体为例,早期模型训练的基准数据集SWE-bench Verified仅覆盖少量Python仓库,任务多为微调式的代码修改。而最新的SWE-bench Pro数据集则将范围扩展至四种编程语言、41个代码仓库,单条样本的平均修改行数从11行激增至107行,跨越多个文件。这意味着单条训练样本的容量从几百个Token膨胀至数万个Token,包含了从需求理解到测试验证的完整逻辑链条。这种信息密度的提升,使得训练同等能力模型所需的数据总量被推高了一个数量级。
除了体量的膨胀,数据价值的重估也直接推动了价格上涨。传统的数据标注曾长期依赖众包工人,单条NLP文本标注价格低至0.02美元。但随着模型复杂度提升,基础标注员无法满足需求,行业迅速向专家标注时代过渡。Scale AI的STEM专家时薪高达30至50美元,Mercor的顶级专家时薪更是达到90至110美元。供给端从普通劳动力升级为博士、执业律师及行业专家,人力成本的上升自然传导至终端价格。然而,仅靠人力涨价无法解释行业高毛利率的扩张,更深层的逻辑在于数据公司与模型研发链条的深度融合。
现代AI数据公司已不再仅仅是劳动力外包商,而是深度介入模型研发、评测及工程服务的合作伙伴。以Scale AI为例,其商业模式已演变为“评测-缺口分析-数据生产-再评测”的闭环服务。通过精准识别模型在特定任务上的表现短板,定制高价值数据进行针对性训练,从而显著提升模型能力。这种深度参与使得数据公司赚取的是服务溢价而非单纯的标注费,Mercor的毛利率从早期的27%提升至35%-40%,Scale AI更是长期维持在50%以上,远超传统人力外包行业15%-20%的平均水平。当数据直接决定模型能力的上限,其定价权便随之水涨船高,行业天花板被彻底打开。
在价值重估的过程中,AI数据行业呈现出两大显著趋势:真实工作流数据取代人工标注成为稀缺品,以及强化学习(RL)环境成为新的采购重点。
Type 1数据,即从真实业务场景中直接捕获的数据,正逐渐取代Type 2人工设计数据成为主流。过去,行业倾向于使用可控、可规模化的Type 2数据,但随着模型基础能力增强,这类数据的边际收益正在递减。模型已学会“做题”,现在需要学习真实世界中的“工作流”。GitHub作为全球最大的Type 1数据宝库,其完整的代码提交记录包含了问题描述、修改方案、评审意见及测试结果,为代码模型的能力跃升提供了关键养分。
为了捕获这一稀缺资源,头部玩家纷纷布局真实工作流数据的采集与加工。Handshake通过与OpenAI合作,组织自由职业者上传原生的办公文档与工作成果,并启动“雇主数据计划”直接采购企业运营数据。Protege等新兴公司则聚焦医疗等高壁垒领域,通过前置合规审核、AI精筛高价值阳性样本及统一许可协议,将医疗数据的采购周期从数月压缩至30天。这种连接数据持有方与模型厂商的中间层基础设施,正在成为AI产业链中不可或缺的一环。
与此同时,RL环境的兴起标志着AI训练从静态数据集向动态交互环境的转变。智能体时代的核心能力要求模型从“回答问题”转向“完成任务”,而完成任务的能力无法仅通过静态数据习得,必须在模拟环境中通过试错与反馈来磨练。OpenAI自建浏览器环境训练ChatGPT Agent,Anthropic投入巨额资金搭建RL训练场,均为这一趋势的注脚。Mercor收购软件仿真公司Deeptune,复刻Excel、Salesforce等办公环境构建沙盒,正是为了捕捉这一新兴市场的红利。RL环境的高搭建成本与高交互性,使其成为仅次于数据标注的又一高价值业务板块。
底层逻辑的变迁也导致了头部玩家的战略分化。Scale AI正向下游延伸,试图成为政企AI应用的总包商,其企业级应用业务年收入已达2亿美元,预计将成为未来主要收入来源。Surge AI则坚持向上走,聚焦高端精品策略,不碰众包市场,仅服务于五大顶级实验室,专注于高难度的RLHF与安全评估,以极小团队实现了12亿美元的营收。
Mercor采取横向扩张策略,构建覆盖全球的专家网络,并通过收购进军RL环境,实现业务多元化。而Handshake则深耕管道生意,利用其长期积累的大学生与雇主资源,专注于真实工作流数据的搬运与整合,在Type 1数据稀缺的当下,掌握了最为关键的数据供给两端。
纵观全行业,单纯的数据标注正在快速贬值,沦为价值链中利润最薄的一环。所有参与者都在向价值链更深处迁移,从提供原材料转向提供解决方案、评测服务及交互环境。这一轮AI竞赛的逻辑与上一代互联网巨头相似,数据再次成为决定能力边界的核心要素。但不同的是,数据已从巨头的副产品演变为独立的、奔向千亿美元规模的生意。
对于投资者与行业观察者而言,AI数据赛道的爆发并非短期风口,而是技术演进至深水区后的结构性机会。随着模型对高质量、高实时性、高交互性数据需求的持续释放,这一赛道仍将保持强劲的增长动力。掌握真实工作流数据源、拥有专家网络优势或具备RL环境构建能力的企业,将在未来的AI生态中占据更为稳固的位置。这场由数据驱动的变革,正在重新定义智能时代的竞争规则。