27B模型如何塞进手机?PrismML重构AI进化的“智能密度”新范式
从规模崇拜到密度革命:AI进化的新十字路口
过去几年,人工智能领域的注意力几乎完全被Scaling Law(缩放定律)所占据。无论是语言大模型、多模态模型,还是正在崛起的物理AI,行业共识似乎是:更多的参数、更大的数据量、更强的算力,直接等同于更智能的表现。这种范式在过去确实推动了能力的指数级跃升,但也带来了沉重的代价。
这种对规模的无限追求,正在触碰物理世界的边界。强大的模型被锁定在拥有庞大数据中心、专用基础设施和巨额能源消耗的高墙之内。对于手机、笔记本、自动驾驶汽车、工业机器人甚至企业本地服务器而言,延迟、硬件性能限制、能耗瓶颈以及隐私安全风险,构成了难以逾越的障碍。在这些场景下,我们需要的不仅仅是“最聪明”的大脑,而是能在有限空间内高效、实时、安全运行的“本地智慧”。
正是基于这一结构性痛点,PrismML应运而生。这是一家由加州理工学院(Caltech)教授Babak Hassibi创立的初创公司,其核心愿景并非继续盲目扩大模型规模,而是致力于提升模型的“智能密度”(Intelligence Density)。简而言之,就是在单位部署体积、有限内存和极低能耗下,释放尽可能多的智能潜能。
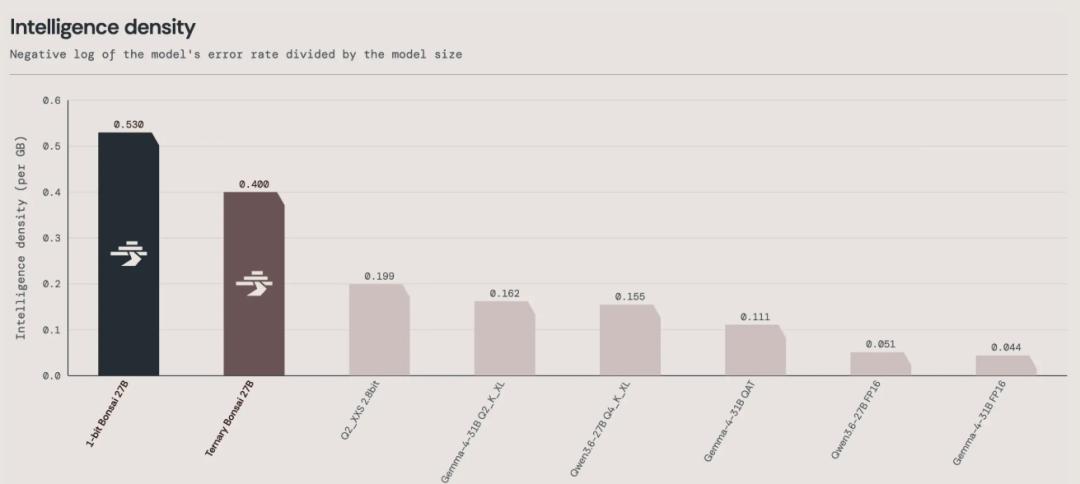
PrismML近期推出的成果令人瞩目:他们成功将拥有270亿参数的Bonsai 27B模型“塞进”了手机,并在保持性能近乎无损的同时,实现了极致的效率优化。这标志着AI的发展重心,正从单纯的规模扩张转向对智能本身的压缩、重构与高效分发。
学术底蕴与产业视角的融合:PrismML的团队基因
PrismML的成功并非偶然,其创始团队在理论基础与工程落地之间建立了罕见的平衡。CEO Babak Hassibi不仅是加州理工学院电气工程、计算与数学科学教授,更是信息论、信号处理及机器学习领域的资深专家。早在1990年代,他便参与了神经网络剪枝方法Optimal Brain Surgeon的研究,该方法通过二阶信息识别并移除模型中的冗余参数。这一早期的理论积累,为后来PrismML在极端压缩模型上的突破奠定了坚实基础。
除了Hassibi,核心成员Sahin Lale和Omead Pooladzandi分别专注于动态系统、强化学习以及二阶优化和数据高效训练。他们此前曾在Neural Propulsion Systems等公司共同探索算法、芯片与硬件系统的结合。而战略副总裁Reza Sadri则带来了数据库、高性能存储及机器学习基础设施的深厚产业经验,曾负责Instacart的ML基础设施团队。
这种兼具学术前瞻性与工程实战能力的团队配置,使得PrismML能够跳出传统大模型优化的窠臼。传统优化往往局限于后量化或微调,而PrismML选择从底层网络架构入手,对嵌入层、注意力机制、多层感知机(MLP)及输出层进行端到端的二值/三值重构。加州理工学院及Google在算力上的支持,进一步加速了这一技术从实验室走向商业可用的进程。
底层重构:1-bit与3-bit权重的技术突破
PrismML的核心技术壁垒在于其对模型权重的彻底重构。在传统的模型压缩中,常见做法是4-bit或8-bit精度训练后的量化,或者混合精度策略,即保留部分高精度层以维持性能。然而,PrismML采取了一种更为激进且彻底的路径:将整个语言网络改造为二值(1-bit)或三值(3-bit)权重。
在二值模型中,每个权重仅表示正、负两种状态。通过每128个权重共享一个FP16缩放系数,实际平均占用空间降至约1.125 bit。三值模型在此基础上增加了零状态,平均占用约1.71 bit。这种设计并非简单的截断,而是通过专用推理内核,在运行时直接读取压缩格式,无需重新展开为FP16。这一创新直接减少了模型体积、内存带宽压力以及推理过程中的数据移动开销。
为了衡量这一技术的实际效果,PrismML提出了“智能密度”这一新概念。它不再单纯以参数规模论英雄,而是评估模型在每GB内存中能承载的有效智能。这种评估体系更贴合端侧设备和边缘计算的实际需求。
性能实证:Bonsai系列的落地能力
PrismML的技术路线已在一系列模型中得到了验证。2026年3月,全球首批具备商业可行性的1-bit大语言模型——1-bit Bonsai 8B发布。该模型在嵌入层、注意力层、MLP层及语言模型头均采用1-bit设计,实现了端到端原生1-bit运行。
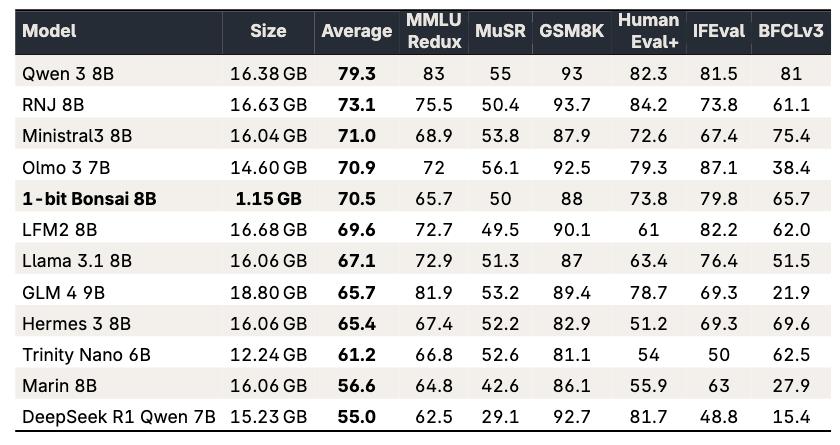
对比Llama 3 8B,Bonsai 8B的体积缩小了14倍,仅为1.15 GB,足以轻松装入iPhone 17 Pro。尽管体积大幅缩减,但其性能却相差无几,推理速度提升了8倍,能效提高了4-5倍。在搭载M4 Pro芯片的Mac上,其推理速度达到131 tokens/秒;使用RTX 4090显卡时可达368 tokens/秒;即使在iPhone 17 Pro Max上,也能保持约44 tokens/秒的流畅体验。
随后推出的Bonsai 27B,基于Qwen3.6 27B打造,成为同等能力级别中首款可在手机端运行的模型。27B参数的模型通常被视为复杂任务的门槛,能够支持多步推理、结构化工具调用、视觉任务以及长期连贯的“计算机操作”智能体循环。Bonsai 27B的1-bit版本在GeForce RTX 5090上推理速度高达163 tokens/秒,在搭载M5 Max芯片的Mac上也能达到87 tokens/秒。
这一突破的意义在于,它打破了“大模型必须依赖云端”的刻板印象。模型现在可以根据任务复杂度灵活分配资源,既能在云端处理极端复杂的推理,也能在本地快速响应日常需求。
混合部署架构:重塑AI应用的设计空间
Bonsai 8B和27B的出现,解锁了一种全新的系统架构——混合部署。在这种架构下,非极限且对隐私敏感的任务被路由给能力过硬的本地模型,而云端前沿模型则保留给最困难的步骤或需要最新知识库的任务。
这种混合部署带来了显著的经济与体验优势。首先,单任务成本呈断崖式下降,因为大量日常交互无需消耗昂贵的云端算力。其次,数据隐私得到极大增强,敏感信息无需离开设备即可完成处理。最后,响应速度显著提升,本地推理消除了网络延迟,使得实时交互成为可能。
对于应用层而言,这意味着更宽广的设计空间。全天候运行的端侧智能体、实时响应的服务机器人、安全可靠的企业级Copilot,以及专为离线或受限环境设计的AI原生产品,都将因本地大模型的普及而成为现实。特别是在带宽受限、功耗敏感或合规要求严格的场景中,本地化AI将成为首选方案。
展望:智能密度定义未来AI竞争格局
AI模型的进化正在经历一场深刻的范式转移。过去,竞争焦点在于谁拥有更多的参数和算力;未来,竞争将转向谁能以更小的资源代价,将更强的智能带入更广阔的现实世界。
这种从“规模”到“智能密度”的转变,不仅关乎技术效率,更关乎AI的可及性与实用性。当模型能够适应多样化的硬件环境,并在单位算力和能耗下释放最大潜力时,AI将真正从云端的“象牙塔”走向边缘的“烟火气”。
PrismML的实践表明,通过底层的架构创新与极致的压缩技术,我们完全可以在不牺牲核心能力的前提下,大幅降低AI的部署门槛。这不仅是对Scaling Law的一种补充,更是对其边界的一次重要拓展。
随着Bonsai系列等高效模型的普及,我们可以预见,未来的AI生态将是云端与边缘协同共生的。云端负责处理极致的复杂推理与知识更新,边缘端则负责实时交互、隐私保护与个性化服务。这种分布式的智能架构,将重新定义AI产品的边界,让智能真正无处不在。
在这个新纪元前夕,那些能够率先掌握“智能密度”技术的公司与研究者,或许将主导下一轮AI应用的爆发。而对于用户和企业而言,这意味着更低的成本、更高的隐私安全以及更无缝的智能体验。AI不再是遥不可及的黑盒,而是触手可及、随时在线的贴身助手。