K3开源震撼全球:中国AI如何以极致工程破局闭源垄断?
算力神话的祛魅与重构
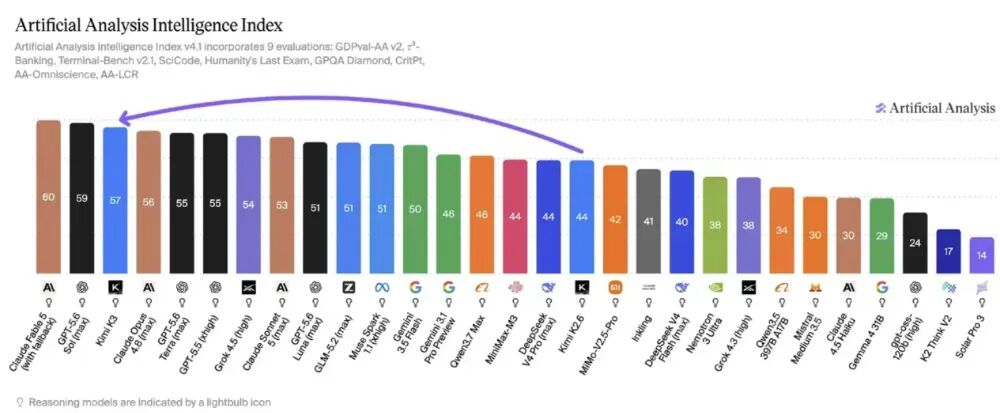
中国人工智能产业正在经历一场深刻的范式转移。这种转变并非单纯的技术迭代,而是底层逻辑的重构:从依赖应用层套壳的“轻资产”模式,向深耕物理算力与算法优化的“重硬核”模式跃迁。在这一进程中,DeepSeek的成功率先打破了“算力不足则发展受限”的刻板印象,而Kimi发布的2.8万亿参数开源模型K3,则更像是一枚投入平静湖面的巨石,激起了全球科技圈与资本市场的剧烈震荡。
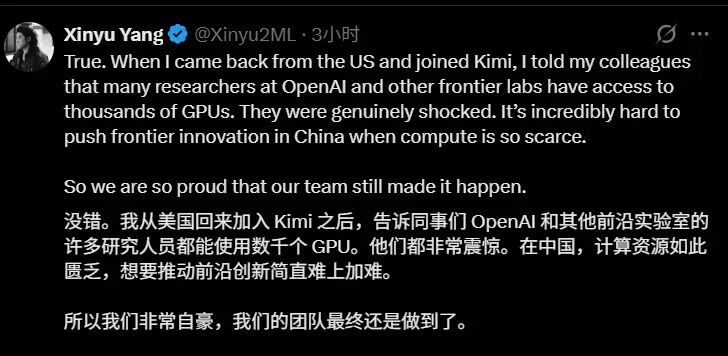
硅谷的研究者们感到困惑:在算力获取受限、用户付费习惯尚未完全养成的背景下,中国团队如何实现了这种程度的技术突破?华尔街的投资人则面临认知失调:在美股市场耗资数千亿美元、投入海量人力,而在中国,仅需300亿左右的投入便能构建起同等竞争力的技术底座?这不仅是开源社区在技术排行榜上的一次胜利,更是对硅谷长期以来构建的“高算力壁垒+高定价权”全球AI叙事的正面冲击。
这场变革的核心,在于中国AI企业无法复制欧美巨头“暴力堆砌H100显卡”的路线,转而走向了极限工程优化的道路。通过算法架构的精妙设计与基础设施的深度重构,中国厂商证明了在资源约束条件下,依然可以逼近甚至达到顶级模型的性能水平。这标志着全球AI竞争进入了一个新的阶段:拼的不再是单纯的算力规模,而是算力利用效率与工程落地能力的极致博弈。
算法亮剑:击穿闭源API的“收租”模式
过去一年多,OpenAI、Anthropic等头部企业凭借海量算力构建了极高的闭源API护城河。这种模式本质上是一种基于技术排他性的“全球收租”计划。通过设立极高的资金门槛与复杂的算力集群工程壁垒,这些巨头在技术顶层建立了一个密不透风的黑盒。在这个商业闭环中,全球广大的中小型企业、垂直行业开发者以及二次创业的软件团队,被迫沦为闭源API接口下游的“数字打工仔”。
高昂的单位Token调用成本、完全不透明的底层权重结构,以及随时可能因上游模型版本迭代而遭遇的降维打击,成为了压在开发者头顶的三座大山。这种商业模式不仅阻碍了AI技术的真正普惠,更扼杀了应用层大量的微创新可能。当基础能力被垄断且价格高昂时,基于AI的微创新往往因ROI(投资回报率)过低而无法存活。
面对这一困局,中国AI产业选择了截然不同的破局之路。以K3为例,其2.8万亿参数的体量若采用传统稠密模型,每次推理需激活所有参数,这在算力受限环境下是无法承受的负担。然而,K3通过高度优化的混合专家(MoE)架构,引入了动态路由机制。在处理具体推理任务时,模型仅需激活全网中极小比例的相关专家网络。这种架构创新使得在同等甚至更优的推理表现下,模型的显存占用与动态计算开销被降低了数个数量级。原本只有顶级财团才能运行的庞然大物,如今可以在有限规模的算力集群上高效运转。
这种对算法架构的极致瘦身,是中国AI在“资源受限”条件下诞生的独特智慧。它证明了通过架构创新,可以有效抵消硬件算力的短板。与此同时,中国AI产业在高熵高质量数据清洗与合成数据飞轮领域的理解,已从初期的粗放爬取迈入了精密制造阶段。通过精细化筛选与合成,模型在有限的数据规模下获得了更高的知识密度,从而提升了学习效率与泛化能力。
基础设施下沉:推理成本的物理极限压缩
在大模型的全生命周期中,训练仅是一次性的固定成本,而上线后的推理部署才是无休止的消耗战。中国Infra(基础设施)玩家如硅基流动、无问芯穹等,正通过重构底层推理引擎,将大模型的落地成本打到物理极限。
这一过程涉及对现有技术栈的深度优化与改造。广泛普及的vLLM投机采样、PagedAttention显存管理机制,以及对低比特量化技术的无损落地,成为降低推理成本的关键手段。这些技术优化不仅提升了吞吐量,更极大地降低了延迟,使得大模型能够在边缘设备或中小规模服务器上高效部署。
更值得强调的是,国产Infra厂商通过深度重构底层软件栈,实现了不同品牌、不同代际计算芯片的池化调度。这种异构集群调度能力,使得企业能够榨干每一滴闲置算力,避免了对单一硬件供应商的依赖。通过将算力资源像水电一样灵活调度,国产厂商硬生生地将大模型的单次推理成本压缩到了极致。
这种成本优势的积累,正在从应用端倒逼闭源巨头让出高昂的溢价空间。当一个来自中国的开源模型能以极低完成相同工作时,全球大模型产业的付费底座发生了不可逆转的倾斜。开发者不再愿意为不必要的“品牌溢价”买单,而是转向追求更高的性价比与更透明的技术服务。这种市场机制的转变,正在瓦解欧美巨头依靠信息不对称建立的定价权。
认知突围:从“快思考”到“慢思考”的范式转换
K3的发布只是反击的序章。真正决定这场科技战终局的,是国产模型在认知智力层面的突破。在大模型发展的早期,全球技术赛场简化为一场关于预训练参数规模的单向竞赛。然而,随着Scaling Law在纯无监督预训练阶段触及高质量人类语料枯竭及算力转换效率的拐点,行业共识正迅速转向。
真正的认知智力突破,不再来源于盲目扩充通用数据的参数体量,而是决胜于强化学习与针对复杂问题的推理时间扩展。这意味着模型能力必须从基于直觉的“快思考”模式,向深入剖析、多步推演的“慢思考”深水区挺进。
在K3发布后的一个月,中国AI迎来了史诗级的火力覆盖。阿里发布的Qwen3.8、DeepSeek在R系列架构上对推理成本的颠覆性下探,以及智谱GLM、MiniMax在长序列逻辑上的持续演进,共同标志着国产大模型已撕掉“套壳”标签,堂堂正正地站在全球前沿技术角力的最前线。
尽管在超长视频生成、原生多模态底层架构上,中美之间仍存在客观的时间代差,但在极度考验强化学习与合成数据质量的推理平权赛道,中国头部独角兽如月之暗面、百川智能、阶跃星辰等正在迅速缩小差距。在这些领域,底层扩散架构与大规模多模态预训练依赖庞大的基础算力,代差难以通过软件优化抹平。然而,在商业化最迫切的逻辑验证赛道,绝对算力的垄断正在失效。
“慢思考”模型的核心在于具备反思能力与自我纠错机制。当遇到复杂问题时,模型不再立刻给出似是而非的预测,而是在后台自行拆解步骤、验证对错、推翻重来。这种机制通过蒙特卡洛搜索树等算法优化,极大地提升了长链条逻辑推理的准确性。一旦这些企业在高级推理能力上取得结构性突破,并将单位Token成本打穿,B端Agent商业化落地的最大阻碍将被彻底扫除。
长久以来,海外闭源巨头的护城河在于高端复杂的长链条逻辑推理能力,并借此收取高昂费用。一旦中国大模型能够将此类智力服务的消耗成本压缩至海外对手的十分之一甚至百分之一,欧美巨头在高级认知智力上仅存的高昂溢价将被彻底碾碎。这种平权化是全球B端Agent爆发的唯一前提。复杂的业务流自动化需要系统进行多步骤规划、工具调用与试错回调,如果推理成本居高不下且出错率高,企业部署AI的投资回报率必为负数。中国AI企业通过打穿高阶推理成本,等于为全球企业级数字员工铺设了一条廉价且无限供给的高速公路。
底层重构:全栈国产化的“结硬寨”战役
然而,没有物理底座的支撑,绝顶的算法奇迹终究是空中楼阁。国内绝大多数AI企业的繁荣,现阶段仍离不开海外芯片与国产算力的混合支撑。在底层硬件集群构建上,头部企业依赖于存量合规海外高端GPU与国产半导体算卡混合部署的过渡态异构架构。
在极端的外部技术封锁与层层加码的出口管制背景下,当既有的海外存量硬件寿终正寝,当向下一代百亿级、十万卡级别集群调度需求无可回避时,如果本土产业链无法完成真正物理底座的彻底替代,中国AI产业的整栋摩天大楼将始终面临被一键抽走基石的致命风险。这是一场没有退路、更没有捷径可走的跨世纪战役。
在大模型系统中,HBM(高带宽内存)和底层软件生态是真正的阿喀琉斯之踵。重构HBM与先进封装链条的艰辛,丝毫不亚于在荒漠深处徒手重建特高压电网。我们面对的是从先进半导体材料、纳米级封装工艺,到内存颗粒堆叠过程中的极端良率爬坡、严重的散热控制,直到集群互联通信协议的高速无损传输。
这最难的一步,恰恰是最没有捷径的一步。长鑫存储在HBM量产与良率上的死磕,以及华为昇腾、壁仞、燧原等国产GPU在各自独立软件栈如CANN上一行行调算子、做生态适配的血泪攻坚,揭示了底层重构的残酷真相。我们面对的不是一个现成的国产CUDA,而是一套需要从荒漠中徒手建立的特高压电网。
英伟达的坚不可摧并非仅靠芯片,而是二十年来近数百万开发者通过行行代码写就的CUDA闭源软件体系。面对这堵高墙,中国异质芯片产业高度分散。国内的系统架构师和底层工程师必须抛弃舒适区,深入硬件指令集底层,手把手重新手写算子、深度定制内存分配架构、一行行调优分布式通信原语。将报错频繁的本土软硬件栈,一步步打磨到工业水准,这是一个需要全行业共同忍受数年寂寞的生死天险。
所有在这个领域流下的血与汗,都有着极其深刻的时代底色。各大国产GPU独角兽企业在生态适配上的日夜攻坚,本质上是在替中国的整个互联网与数字经济底座,彻底拔除埋藏数十年的卡脖子暗雷。随着国产半导体在HBM良率上的逐步稳定,以及国产异构芯片在基础软件栈上的长期汇聚,中国AI底座在物理层面实现安全循环的拐点必将到来。
结语:韧性重构全球AI版图
上层的工程极限压缩、中层的推理平权突围、底层的硬件血泪攻坚,这三者构成了中国AI最真实的产业切面。在这场科技角力中,中国科技产业最迷人的地方不在于编织宏大叙事,而在于极其强悍的韧性。
哪怕开局受制于人,我们也能在极端的约束条件下,一砖一瓦拼凑出属于自己的算力底座。这种韧性不仅体现在技术的突破上,更体现在对产业链自主可控的坚定信念上。资本市场的目光,也终将穿透浮躁的应用层泡沫,向这批真正啃硬骨头的硬核卖水人致敬。
中国AI的崛起,不是简单的替代,而是通过不同的技术路径与工程智慧,为全球AI产业提供了另一种可能性:在资源受限的环境中,通过极致的效率优化与生态共建,依然可以实现高级智能的普惠与繁荣。这或许才是K3及后续国产模型对全球AI格局最深远的影响。