机器人记忆革命:RoboTTT如何实现8K长上下文与实时自我进化
在具身智能的演进历程中,记忆能力的缺失一直是制约机器人执行长程复杂任务的核心瓶颈。传统的机器人策略模型往往受限于极短的上下文窗口,导致其在执行多步骤操作时容易“遗忘”前序状态,难以形成连贯的行为逻辑。然而,随着大语言模型在自然语言处理领域展现出惊人的长文本理解能力,业界开始思考:机器人是否也能拥有类似的长期记忆?近期,英伟达高级研究科学家 Jim Fan 与斯坦福大学教授李飞飞团队合作,提出了一种名为 RoboTTT 的创新框架,试图通过测试时训练(Test-Time-Training, TTT)技术,彻底重塑机器人的时空认知能力。
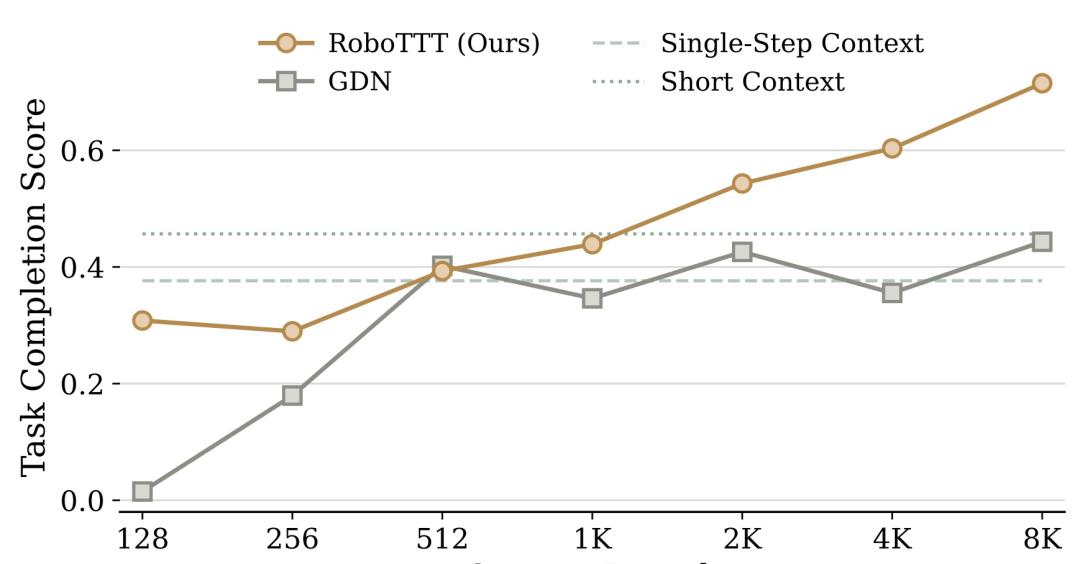
RoboTTT 的核心突破在于将视觉运动上下文的长度扩展了三个数量级,达到了惊人的 8K 时间步。这一尺度相当于机器人拥有了约 5 分钟的连续“肌肉记忆”,使其能够在不增加推理延迟的前提下,处理远超以往规模的时序信息。这种能力的提升并非简单的参数堆叠,而是源于对模型架构与训练范式的根本性重构。研究表明,当预训练上下文从 1K 扩展至 8K 时,同一模型的性能提升了 62%,这有力地证明了上下文长度正在成为机器人基础模型新的 Scaling 方向。正如 Jim Fan 所言,百万级上下文的机器人时代或许已不再遥远。
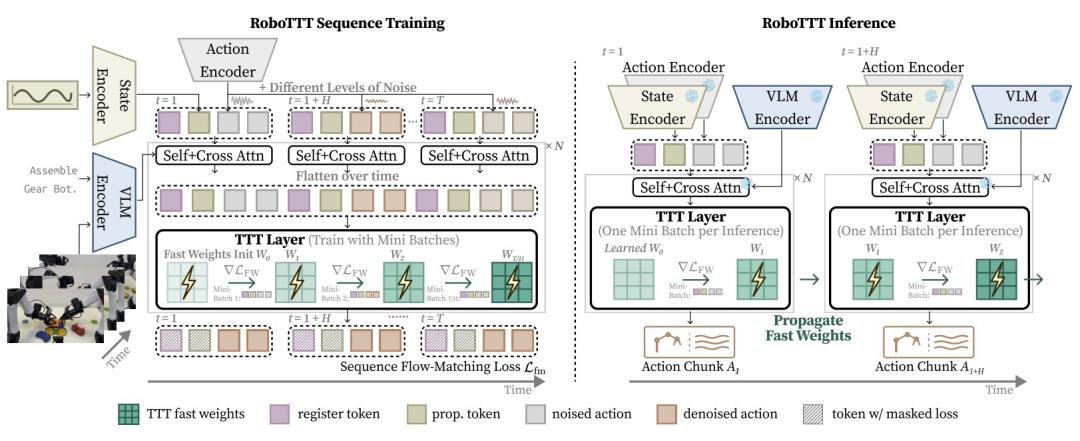
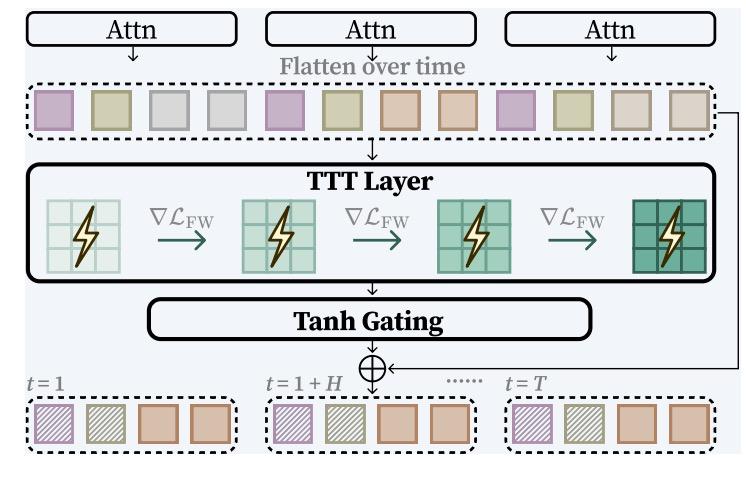
要理解 RoboTTT 的技术本质,首先需要剖析其独特的模型架构设计。该框架由视觉-语言模型骨干网络与带有 TTT 层的 DiT 动作头组成。在传统注意力机制处理单时间步内信息的基础上,RoboTTT 引入了 TTT 层专门负责跨时间维度的信息流转。为了平衡计算效率与信息保留,模型并未将所有视觉-语言 Token 直接输入 TTT 层,而是巧妙地利用少量 Register Token 在时间轴上传递关键信息。此外,为了保护预训练获得的通用能力,TTT 的输出经过 Tanh Gating 机制处理后,再与注意力输出融合。这种设计既保证了历史信息的持续写入,又避免了因过度更新而导致的灾难性遗忘。
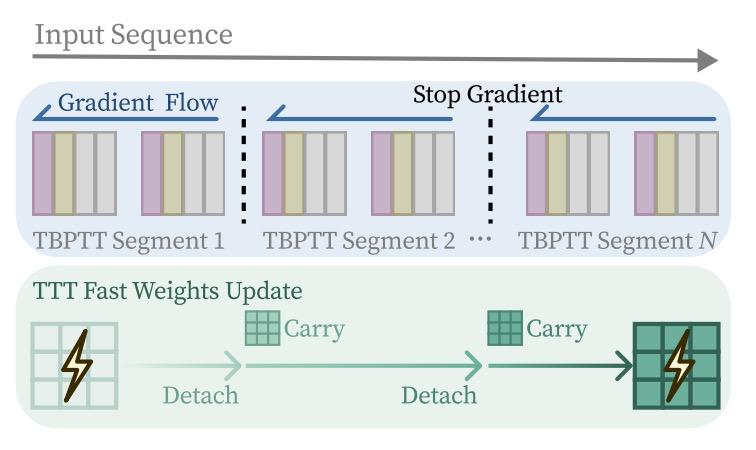
在训练策略上,RoboTTT 采用了序列动作强制与截断反向传播算法相结合的方案。面对长达 8K 的时间步,直接进行全序列反向传播会导致显存爆炸。因此,研究团队将长序列切分为若干片段,仅在片段内部计算梯度,但允许快速权重在片段间持续传递。这种机制使得 TTT 能够贯穿整个序列,同时将显存开销控制在可控范围内。同时,序列动作强制通过为每个动作块独立采样噪声水平,稳定了 Flow-Matching 训练过程,确保了模型在长序列生成中的稳定性与多样性。
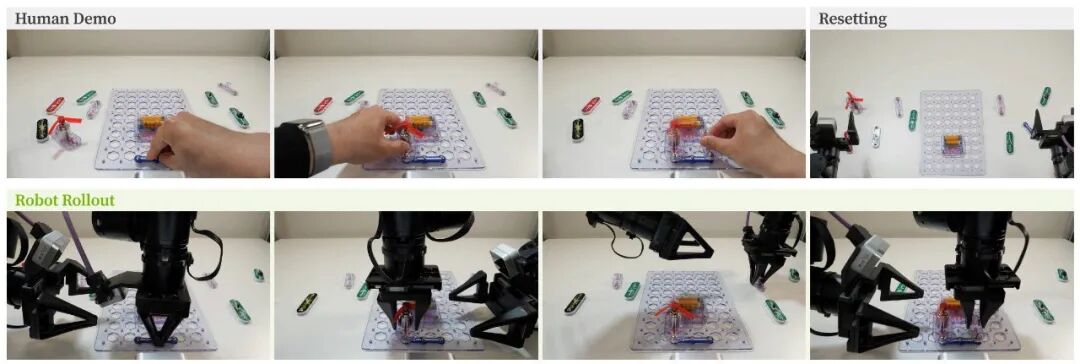
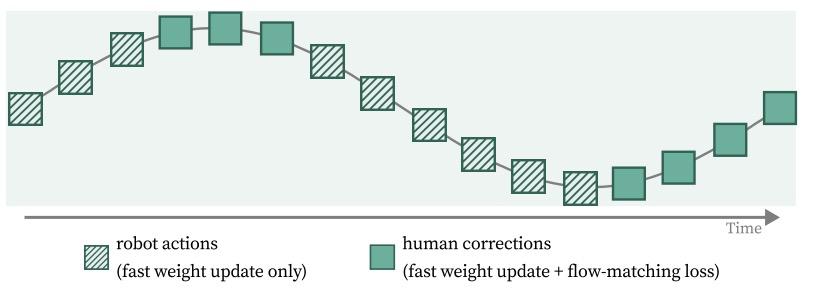
更为精妙的是 RoboTTT 对长上下文约束的处理机制。模型区分了“上下文时间步”与“损失计算时间步”。在某些场景下,部分时间步仅作为上下文输入,用于更新快速权重,而不参与动作损失的计算。这一机制衍生出两种强大的学习能力:视频模仿与 DAgger 蒸馏。在视频模仿中,人类演示视频作为纯上下文输入,模型通过更新快速权重来适应未见过的任务配置,从而实现一次性模仿。而在 DAgger 蒸馏中,完整的机器人轨迹(包括失败尝试)都被纳入上下文,但损失函数仅针对人类纠正后的动作计算。这意味着模型能够从自身的错误中学习,将修正策略隐式地写入快速权重,形成一种在线的自我改进机制。
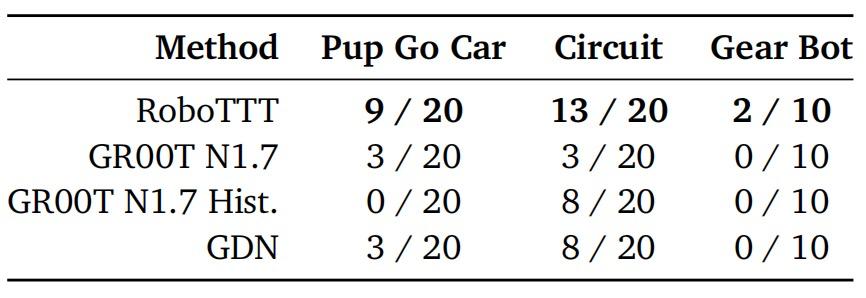
实验数据充分验证了 RoboTTT 的优越性。在三个高难度的长程双臂装配任务中,RoboTTT 的平均任务完成分数达到 79%,显著优于现有的 SOTA 基线模型 GR00T N1.7 以及采用 Gated DeltaNet 的 GDN 模型。特别是在平均耗时 5 分钟、包含 10 个阶段的“齿轮机器人”任务中,RoboTTT 是唯一能够完整完成任务的方法。相比之下,简单拼接历史观测帧的传统方法不仅未能提升性能,反而因噪声干扰导致得分下降。这证明 RoboTTT 并非简单地“记住”过去,而是真正理解了任务进度与状态依赖关系。
在细粒度操作层面,RoboTTT 展现出了极强的鲁棒性与恢复能力。当电钻未对准螺丝或电路组件插入受阻时,模型能够基于长期的上下文记忆识别当前所处的阶段,并重新调整姿态进行尝试,而不是盲目重复错误动作。在涉及物理扰动的测试中,当人为移除已安装的部件时,RoboTTT 能够迅速感知环境变化,并根据之前的操作记忆返回现场重新安装。数据显示,在车顶移除场景下,其恢复率高达 75%,远超基线模型的 50%。这种即时恢复能力得益于 DAgger 蒸馏带来的隐式纠错算法,使机器人具备了类似生物的本能反应。
此外,RoboTTT 在 One-Shot 模仿任务中的表现同样令人印象深刻。在电路装配任务中,仅凭一段人类演示视频作为上下文,机器人就能准确判断并执行未见过的电路配置组装,成功率达到 60%。而对比模型 GDN 在此类零样本泛化任务中几乎完全失效。这一结果揭示了长上下文对于提升机器人泛化能力的关键作用:它允许模型在推理阶段动态吸收新信息,而非仅仅依赖静态的训练分布。
尽管 RoboTTT 取得了显著进展,但其局限性也不容忽视。首先,扩展训练上下文长度必然带来训练成本的激增。虽然推理阶段的成本保持恒定,但长序列训练对算力资源提出了更高要求。未来,探索更高效的 TTT 训练技术,如 TNT 等,将是降低门槛的关键。其次,TTT 层的目标函数仍有优化空间,目前的方法主要借鉴自视觉领域,针对机器人动力学特性的专用目标函数尚待开发。最后,RoboTTT 尚未覆盖所有部署中的失败模式,结合强化学习直接优化任务成功率,可能是进一步提升其实用性的有效途径。
从更宏观的视角来看,RoboTTT 的出现标志着具身智能研究范式的转变。过去,我们过于关注模型参数的规模与静态知识的积累,而忽视了推理时的动态适应能力。RoboTTT 证明了,通过测试时训练让模型在运行中不断微调自身状态,可以极大地提升其对复杂环境的适应性。这种“边做边学”的能力,正是通用机器人迈向真实世界应用所必需的核心素质。
随着上下文长度的不断扩展,机器人将不再是被动的指令执行者,而是具备长期记忆与自我反思能力的智能体。它们能够记住几分钟前的操作细节,理解因果链条,并在遇到意外时自主修正。这种能力的跃升,将为家庭服务、工业制造乃至医疗护理等领域带来深远影响。未来,当机器人能够像人类一样,通过观察一次演示就掌握新技能,并在错误中不断进化时,我们离真正的通用人工智能又近了一步。RoboTTT 不仅是一个技术模型,更是通往这一未来的重要路标,它提示我们:在具身智能的 Scaling 定律中,时间与记忆的维度,值得被重新定义。