动作即Token:眸深智能如何以端侧具身大脑重构机器人产业格局
在人工智能从数字世界向物理世界跨越的关键节点,具身智能(Embodied AI)正经历着从概念验证到规模化落地的剧烈阵痛期。传统的技术路径往往受限于对海量真机数据的重度依赖,以及高昂的端侧算力成本,导致机器人难以在复杂多变的真实环境中实现通用化部署。然而,一家成立于2025年初的初创企业——眸深智能,正通过一种颠覆性的技术范式,试图解开这一死结。其核心逻辑在于重新定义机器人的“语言”,将连续复杂的肢体动作转化为可被大模型理解和生成的离散Token,从而构建起一个真正懂动作、能进化的原生具身大脑。
这一技术路线的根本性突破,源于对动作本质的重新解构。在传统视觉-语言-动作(VLA)模型中,动作往往被视为一种连续的、难以量化的信号,导致生成的行为僵硬且缺乏多样性。眸深智能团队早在2022年便提出了隐空间动作扩散模型(MLD),首次将动作映射到隐空间,利用扩散模型从噪声中还原自然连贯的人体姿态。这相当于让AI学会了“无师自通”,不再需要逐帧教导机器人如何移动,而是通过去噪过程理解运动的物理规律。随后发布的MotionGPT进一步将人体姿态拆解为约3000个“动作基元”,类比于汉字的基本笔画。这种离散化处理使得机器人能够像大语言模型预测下一个单词一样,预测下一个动作Token,从而具备了强大的零样本泛化能力。即使面对从未见过的指令,机器人也能通过重组已有的动作词汇库来理解并执行任务。
随着技术的迭代,眸深智能在2026年推出了STI-WM(时空一体世界动作模型)。这一模型标志着具身智能从单纯的感知决策向物理交互深度的迈进。STI-WM实现了空间结构、时间演化、物理一致性与执行鲁棒性的四维统一,彻底摆脱了对海量标注真机数据的依赖。其训练配方极具创新性:80%的数据来源于互联网视频,10%来自动捕数据,仅10%用于真机闭环对齐。通过从海量无标注视频中学习物理规律,再用少量高精度数据校准生物力学特征,该模型将真机数据的需求降低了90%,同时将动作准确度提升至99%。这种数据效率的提升,不仅大幅降低了训练成本,更解决了长时序任务中常见的误差累积问题,为机器人在真实世界中的长期稳定运行奠定了基础。
除了模型架构的创新,端侧部署能力的突破是眸深智能能够实现商业化的另一大支柱。具身智能的最终战场在端侧,这意味着模型必须在有限的算力资源下实现低延迟、高精度的推理。眸深智能团队凭借核心成员在海思、英特尔、英伟达等芯片巨头的深厚背景,构建了国内罕见的算子级适配能力。通过模型蒸馏、冗余参数压缩以及Token剪枝等技术,他们将千亿参数级的模型压缩至百亿级别,参数量降低约75%,端侧推理延迟从200毫秒骤降至10毫秒。更重要的是,这种压缩并未牺牲性能,部分任务的精度甚至提升了3%-6%。这一成果不仅获得了IJCAI 2025全球最佳论文奖,更直接推动了端侧推理成本从20万元降至1万元,使机器人大脑的续航时间提升了10倍。
在硬件生态的选择上,眸深智能坚定地走向了国产算力适配的道路。面对全球供应链的不确定性以及英伟达芯片的高昂成本,团队同步适配了海思昇腾310/910、地平线、燧原S60等国产芯片平台。这种软硬协同的策略不仅解决了供应链安全问题,更通过底层的算子优化提升了资本效率。相较于传统方案需要上万张显卡进行训练,眸深智能通过优化算法,仅需千卡级集群即可完成同等规模的模型训练,大幅降低了研发门槛。这种基于国产算力原生开发的技术栈,确保了从训练到推理全流程的自主可控,为未来大规模部署扫清了障碍。
商业化落地方面,眸深智能已展现出强劲的增长势头。2026年上半年,公司营收已达数千万元,估值在短短半年内增长超十倍。其客户群体覆盖了工业检测、物业服务、环卫清洁等多个高频刚需场景。例如,在与某港股上市物业公司及A股环卫龙头的合作中,眸深智能的大脑已成功交付并投入实际运营。这些场景对机器人的稳定性、成本控制及环境适应能力有着极高要求,而眸深智能的低成本端侧方案恰好契合了这一需求。此外,公司正在推进与头部连锁零售集团及白色家电工厂的合作,探索人形机器人在更复杂服务场景中的应用潜力。
值得注意的是,眸深智能提出的T²MB(Task*Task Motion Brain)机制,赋予了机器人离线自进化的能力。在传统模式下,机器人发现Bug或需要升级时往往需要返厂或联网更新,这不仅效率低下,还存在数据隐私风险。T²MB允许机器人在端侧通过本地交互持续优化性能,任务执行准确度最高提升25%。这种边缘侧的自我迭代能力,使得机器人能够适应不同用户的使用习惯和环境变化,真正实现了“越用越聪明”。这一特性对于需要长期独立运行的服务机器人而言,具有极高的实用价值。
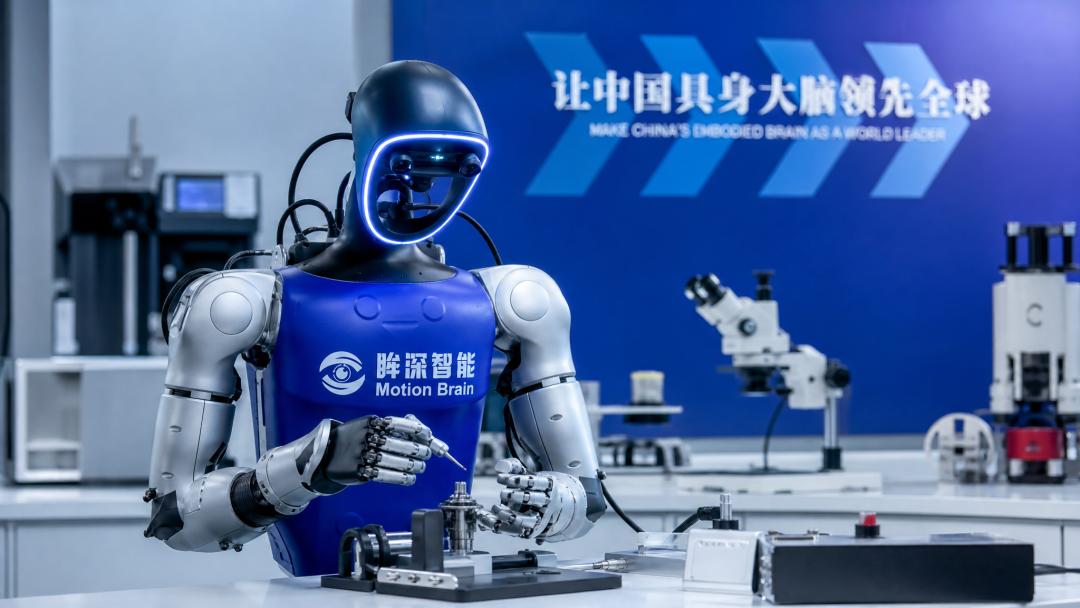
从行业竞争格局来看,具身智能领域正呈现出明显的分化趋势。一部分企业侧重于记忆增强或底层芯片架构,而眸深智能则聚焦于执行层的动作生成与泛化。创始人穆泽林认为,回归第一性原理,具身智能的核心在于解决“执行”问题。通过动作Token的泛化能力,机器人可以将已学到的技能迁移到新任务中,例如从拿矿泉水瓶迁移到拿手机,只需少量后训练即可达到较高准确度。这种务实的技术路线,避免了在短期内难以突破的基础科学问题上过度消耗资源,而是专注于解决工程化落地的痛点。
未来,具身智能产业有望形成类似汽车行业的分工体系。本体制造商将专注于机械结构、负载能力及特定场景的硬件优化,而通用大脑供应商则提供核心的智能控制能力。眸深智能的目标是成为那个“超级通用大脑”,通过标准化的接口适配不同的机器人本体,如复旦自研的“光华1号”、宇树G1以及上海人形机器人创新中心的“青龙”等。这种模块化、标准化的合作模式,将极大加速具身智能产品的迭代速度,降低整体产业链的研发成本。
尽管前景广阔,但挑战依然存在。随着模型处理的多模态信号日益丰富,包括触觉、3D点云等,端侧算力需求将持续攀升。目前主流芯片的200TOPS算力可能很快遭遇瓶颈,未来可能需要1000-2000TOPS的算力支持。眸深智能选择与芯片公司深度合作而非自行造芯,是一种更为理性的战略选择。通过软硬化协同优化,最大化现有硬件的性能潜力,同时等待下一代专用芯片的成熟,这种策略既保证了当前的市场竞争力,也为未来的技术升级预留了空间。
综上所述,眸深智能通过动作Token化、数据训练范式革新以及国产芯片深度适配,构建了一套高效、低成本且具备自进化能力的具身智能解决方案。这不仅为机器人行业提供了一条可行的商业化路径,也为中国在全球具身智能竞争中争取到了重要的话语权。随着技术的不断成熟和应用场景的拓展,这一“原生通用大脑”有望真正走进千家万户,重塑我们与物理世界的交互方式。