AI重写生命代码:诺奖得主打造超越进化的基因剪刀
突破进化瓶颈:当算法介入生命底层逻辑
长期以来,人类对生命工具的获取依赖于一种近乎盲目的“淘金”模式。胰岛素源自犬类胰腺,Cas9酶发现于酸奶厂的细菌培养物中,肉毒毒素则源于一次食物中毒事件。这些改变医学史的工具,无一不是大自然偶然馈赠的礼物,而非人类理性设计的产物。这种依赖运气的发现机制,限制了我们对生命分子进行定制化改造的能力。然而,随着人工智能深度介入生物学研究,这一局面正在发生根本性逆转。
传统蛋白质工程面临着一个令人绝望的数学难题。以常见的Cas9蛋白为例,其长度通常超过1000个氨基酸。由于每个位置可能有20种不同的氨基酸选择,理论上的序列组合空间高达20的1000次方。这个数字不仅远超可观测宇宙中的原子总数,也远远超出了人类实验试错的极限。在过去的十几年里,科学家试图通过定点突变来优化天然酶的性能,但往往陷入“牵一发而动全身”的困境:稍微修改几个关键位点,整个蛋白结构就会崩塌,功能彻底丧失。因此,以往的改良工作大多局限于1%至2序列的微调,难以触及性能提升的本质。
双轨并行:从结构预测到功能生成的跨越
2026年7月,两项重磅研究同时揭示了AI在蛋白设计领域的巨大潜力,它们代表了两种截然不同但殊途同归的技术路径。第一条路径由2020年诺贝尔化学奖得主Jennifer Doudna领衔,其团队聚焦于一类名为TnpB的微型核酸酶。TnpB被认为是Cas12酶的进化祖先,具有体积小、结构紧凑的优势。Doudna团队的目标非常明确:测试AI能在多大程度上改写天然序列,同时保留其切割DNA的功能。
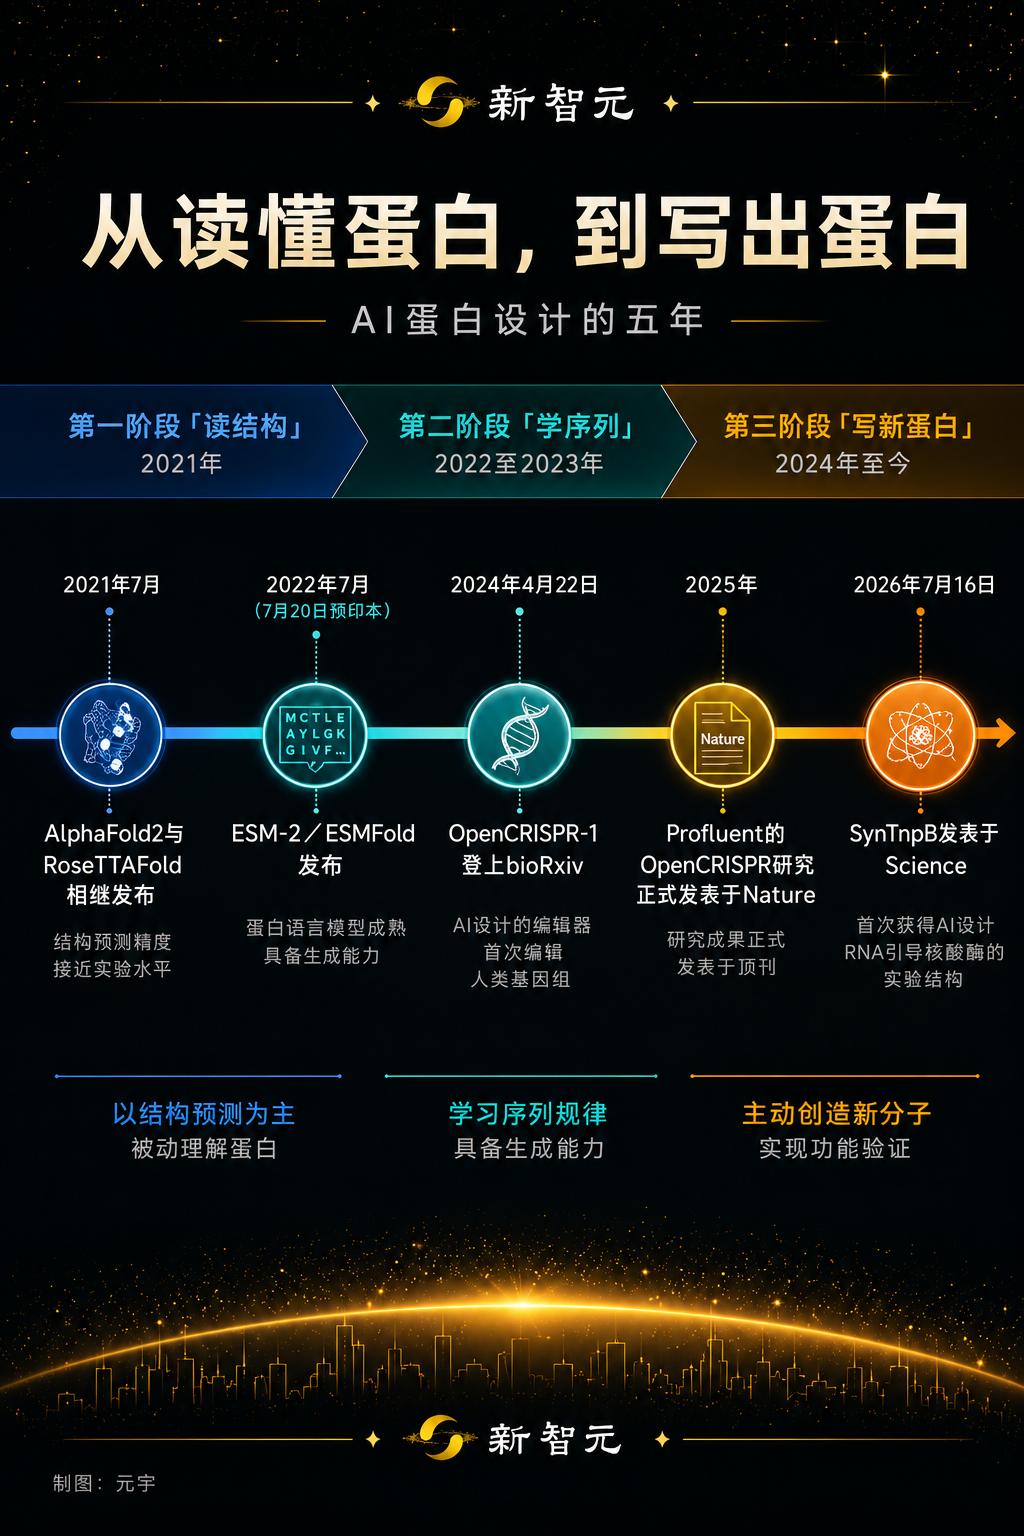
该团队采用了一种创新的两步走策略。首先,利用先进的结构预测模型,将目标蛋白的三维折叠形态作为约束条件,反向推导能够形成该结构的氨基酸序列。这一步解决了“长得像”的问题,确保生成的蛋白在物理结构上是稳定的。然而,结构稳定并不等同于功能活跃。因此,第二步引入了基于海量实验数据训练的进化约束模型。该模型学习了自然界中蛋白质各部件之间复杂的相互作用规律,识别出哪些区域是维持功能的“死穴”,哪些区域是可以自由变异的“沙盒”。
通过这种组合拳,AI成功生成了数千种全新的TnpB序列。实验结果显示,这些合成酶在细菌、植物乃至人类细胞中均表现出高效的基因编辑能力。更令人震惊的是,部分合成版本的序列与天然版本相比,差异幅度高达30%。这意味着AI不仅在修补自然,更是在重新编写自然的代码,且新代码在活体系统中运行良好。
极致精准:OpenCRISPR-1的性能颠覆
与此同时,生物技术公司Profluent采取了更为激进的“从零生成”策略。他们并未局限于对现有天然酶的修饰,而是构建了一个包含510万个CRISPR-Cas蛋白的庞大数据库,涵盖了26TB的基因组和宏基因组数据。利用高性能蛋白质语言模型,他们在这一广阔的设计空间中进行了大规模采样,生成的序列多样性达到了自然界已知水平的4.8倍。
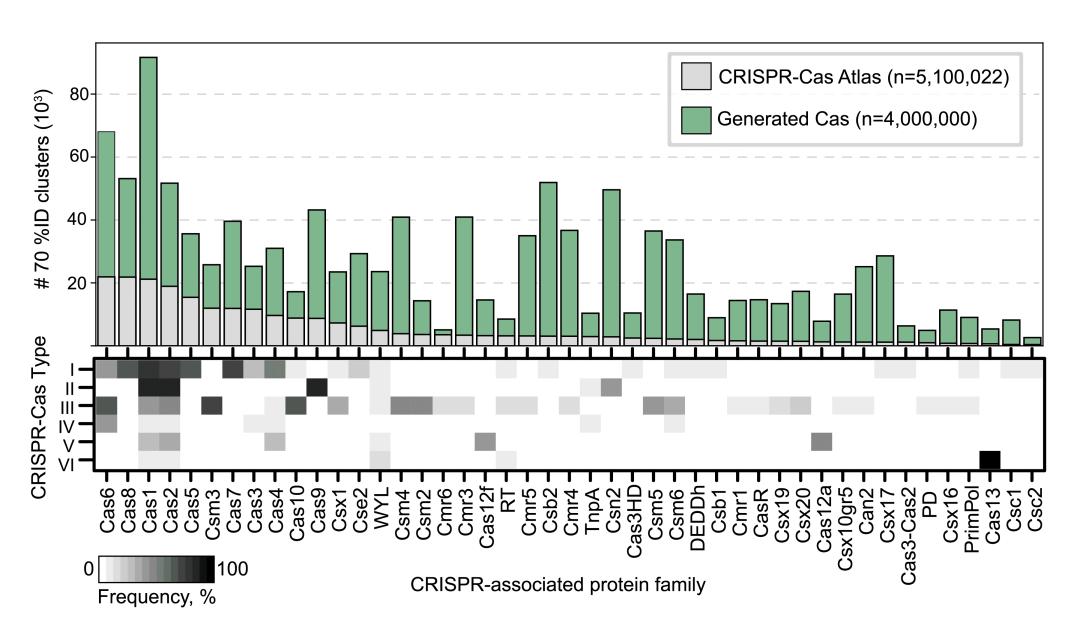
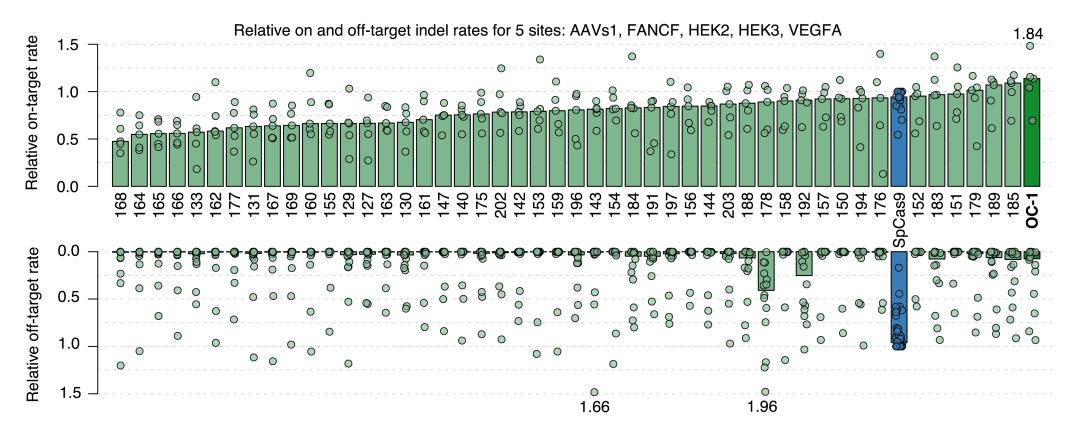
在经过严格筛选后,一款名为OpenCRISPR-1的新型核酸酶脱颖而出。这款酶与主流的SpCas9相比,拥有403个氨基酸突变,与数据库中任何天然蛋白也有至少182个突变的距离。可以说,这是一把在地球生物圈中从未存在过的“剪刀”。功能验证数据表明,OpenCRISPR-1在人类细胞中的靶向编辑效率达到55.7%,高于SpCas9的48.3%。更为关键的是,其脱靶编辑率仅为0.32%,相较于SpCas9的6.1%,降幅约为95%。
脱靶效应一直是基因编辑临床应用的最大障碍之一。非预期的基因切割可能导致致癌突变或其他严重副作用。OpenCRISPR-1在保持高效切割的同时,极大地提升了特异性,这主要归功于AI对蛋白-DNA相互作用界面的精细优化。它学会了更严格地识别目标序列,对相似但不完全匹配的非目标序列视而不见。这种精度的提升,并非来自简单的参数调整,而是源于对蛋白质语言深层语法的理解与重构。
范式转移:从阅读生命到书写生命
这两项研究的共同意义在于,它们标志着生物学研究范式的根本性转移。过去,AlphaFold等工具主要解决的是“预测”问题,即根据序列推断结构,帮助科学家理解自然界的既有分子。而现在的蛋白质语言模型,已经迈入了“生成”阶段。它们不再仅仅是观察者,而是成为了创作者。就像大型语言模型通过学习人类文本的语法,能够写出从未存在过的文章一样,AI通过学习生物分子的“语法”,能够设计出具有特定功能的全新分子。
这种能力的获得,使得科学家可以从 desired function(期望功能)出发,反向设计 molecular structure(分子结构)。我们不再需要等待大自然在漫长的进化岁月中偶然产生某种有用的酶,而是可以根据临床需求,定制出更小、更准、免疫原性更低、甚至能识别非标准碱基的编辑工具。苏黎世大学分子生物学家Soeren Lienkamp指出,CRISPR技术让编辑DNA变得普及,而AI蛋白设计则让创造全新性质的蛋白质成为可能。这是一种从“发现自然”到“创造自然”的跃迁。
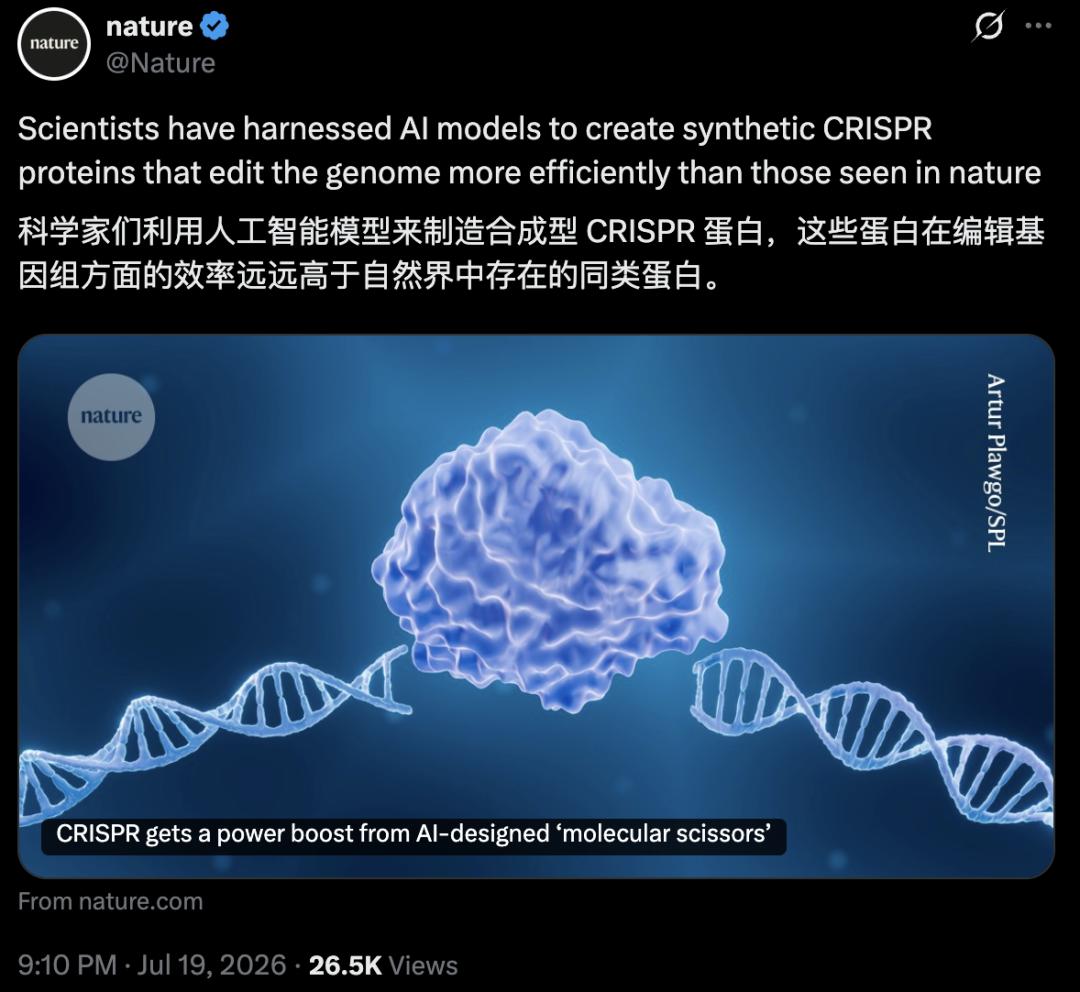
值得注意的是,AI的高效并非凭空而来,它建立在数十年实验室积累的高质量数据基础之上。Doudna强调,尽管AI模型运行速度极快,几小时内即可遍历进化需数十亿年才能探索的空间,但其背后的训练数据依然来源于传统的湿实验。如果没有过去几十年生物学家对分子机制的深刻理解和对大量蛋白数据的标注,AI模型将成为无源之水。因此,未来的生物学将是“干实验”(计算模拟)与“湿实验”(实体验证)深度融合的学科。
现实挑战与伦理边界
尽管实验室数据令人振奋,但我们必须保持清醒的理性。目前提到的所有成果,包括OpenCRISPR-1和Doudna团队的合成TnpB,均止步于细胞实验阶段。从培养皿到人体,中间隔着动物实验、临床试验、药物审批等漫长且充满不确定性的鸿沟。每一个环节都可能因为免疫反应、递送效率或长期安全性问题而宣告失败。此外,独立第三方对Profluent数据的复现仍需时间,科学界的共识形成需要严谨的验证过程。
更深层次的担忧来自于生物安全与伦理。当设计蛋白的门槛大幅降低,制造潜在生物武器的风险也随之增加。AI生成的蛋白是在活细胞中运行的,一旦释放,其影响是不可逆的。这与软件代码不同,代码出错可以回滚,而生物系统的错误可能导致生态灾难或公共卫生危机。因此,如何在推动技术创新的同时,建立严格的监管框架和伦理准则,是全球科学界和政策制定者面临的紧迫任务。
此外,AI黑箱问题依然存在。虽然我们知道AI设计的蛋白有效,但往往难以完全解释其背后的具体分子机制。这种“知其然不知其所以然”的状态,在涉及人体健康的医疗应用中是一个巨大的隐患。未来,可解释性AI在生物学中的应用将成为研究重点,以确保每一把“基因剪刀”的安全性和可控性。
结语:人机协作的新生物学时代
人工智能并没有完全取代进化,也没有完全取代科学家。它更像是一个强大的加速器,将人类从繁琐的试错工作中解放出来,让我们能够专注于更高维度的策略设计和机制解读。Doudna和Profluent的成果证明,当人类的生物学直觉与机器的计算能力相结合时,我们能够突破进化的局限,创造出服务于人类健康的全新工具。
这场变革才刚刚开始。随着算法的迭代和数据量的积累,未来我们可能会看到更多针对特定疾病定制的基因编辑疗法,甚至是通过设计全新酶系来解决塑料污染、碳捕获等全球性环境问题。在这个过程中,保持对生命的敬畏,坚守科学的严谨,将是我们在探索未知领域时最坚实的锚点。我们正站在一个新时代的门槛上,手中握着的不再是偶然捡到的石器,而是经过精密设计的激光手术刀。