世界模型物理推理瓶颈:Apple-π基准揭示SOTA仅0.473分,通用模拟尚远
在人工智能的宏大叙事中,构建能够理解并模拟现实世界的“世界模型”被视为通向通用人工智能(AGI)的关键路径。从Sora到Genie,再到Cosmos和V-JEPA,这些前沿视频生成模型共同指向一个诱人的假设:只要摄入足够多的视频数据,模型便能自发涌现出对物理世界的“直觉”,进而像人类一样理解重力、碰撞与惯性。然而,这种基于统计关联的“直觉”是否等同于对物理定律的真正掌握?近期,南洋理工大学S-Lab团队及其合作者通过首个以物理定律为核心的评估基准Apple-π,给出了一个冷静甚至略显残酷的答案:当前的视频生成模型距离可靠的通用世界模拟器仍有巨大鸿沟,其物理推理能力远未成熟。
从“看起来正确”到“物理上正确”的鸿沟
长期以来,视频生成模型的评估主要依赖于人类的主观审美或简单的视觉一致性指标。这种评估方式存在一个根本性的缺陷:它无法区分模型是真正理解了物体运动的物理因果,还是仅仅通过海量数据学习到了某种视觉上的“套路”。例如,一个球从高处落下,模型可能生成了符合视觉习惯的抛物线,但这并不意味着它理解了重力加速度g=9.8m/s²,也不意味着它能预测如果改变初始速度或质量,轨迹会发生何种变化。
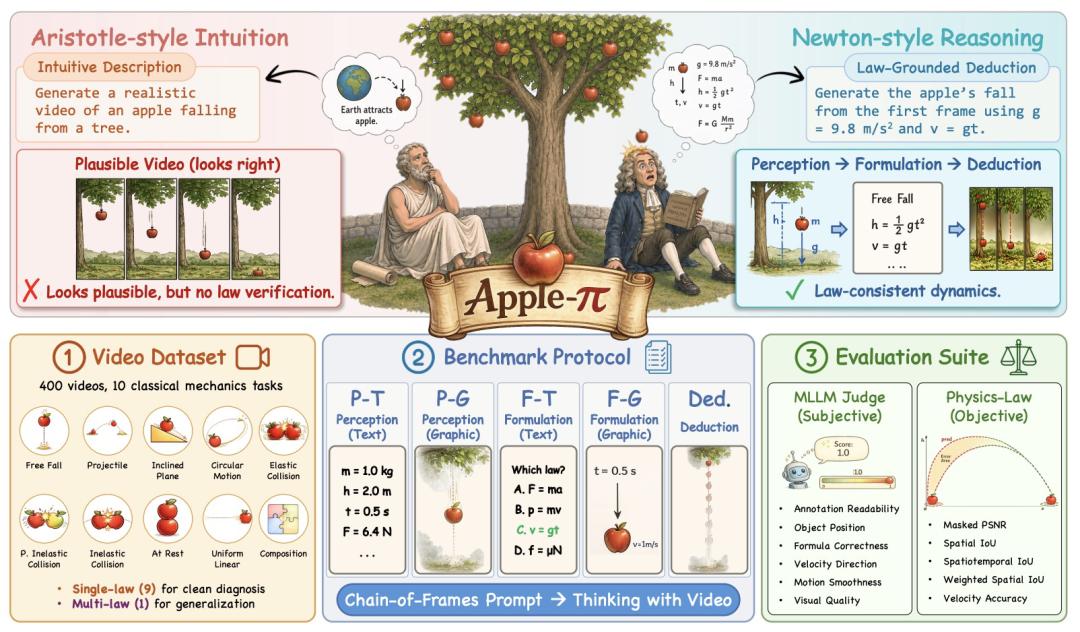
这种“亚里士多德式”的直觉与“牛顿式”的定律思维之间存在本质区别。前者依赖表象的相似性,后者依赖内在规律的推导。Apple-π基准的提出,正是为了填补这一评估空白。它不再满足于模型生成“看起来合理”的视频,而是要求模型具备感知物理量、表述支配定律、推导符合定律后续运动的能力,并能精准定位推理失败的具体环节。这一转变标志着视频模型评估从“视觉保真度”向“物理一致性”的范式转移。
Apple-π基准:拆解物理推理的黑盒
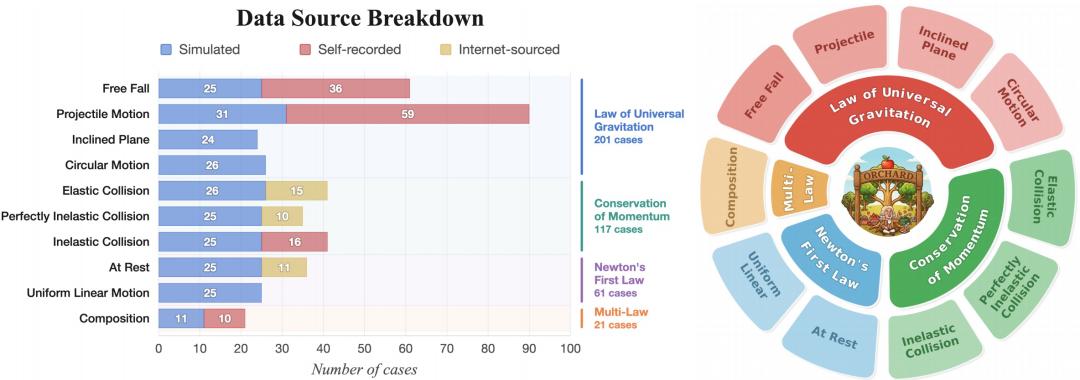
Apple-π基准的设计极具针对性,其核心数据集Orchard包含了400个经典力学视频。这些视频并非随意采集,而是先确定物理定律和初始条件,再反向生成或筛选对应视频。这种设计确保了测试用例的物理严谨性。任务被细分为单一定律和多定律组合两类,覆盖了重力驱动、碰撞动量守恒、惯性运动以及多段运动衔接等复杂场景,旨在考察模型能否在动态过程中持续更新物体的位置和速度状态。
在评估协议上,Apple-π将复杂的物理推理过程拆解为感知、表述和推导三个子轨道。感知任务要求模型复刻画面中的数字标注或定位物体;表述任务要求模型从候选公式中选择正确的物理方程并代入变量,或预测特定时刻的物体位置;推导任务则最具挑战性,要求模型基于首帧初始条件生成完整的运动视频。这种分层评估机制,使得研究人员能够清晰地看到模型在哪个环节出现了断裂。
评估套件采用了混合评分机制,结合了多模态大模型(MLLM)的主观合理性评分和基于物体掩码、轨迹真值的物理客观指标。这种主客观结合的方式,既考虑了生成内容的视觉质量,又量化了运动过程是否符合物理规律,从而避免了单一指标带来的偏差。
数据背后的真相:SOTA模型得分仅0.473
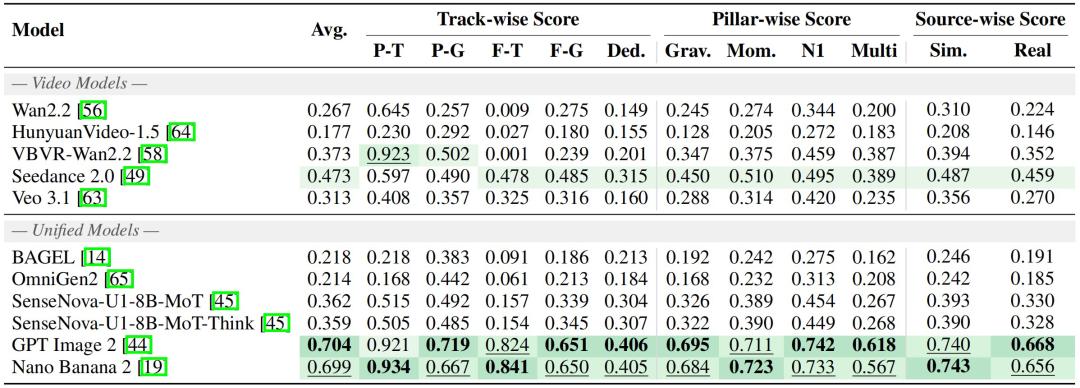
研究团队在Apple-π基准上对11个代表性模型进行了全面评估,结果令人深思。数据显示,尽管视频预训练、推理监督和统一理解架构在一定程度上改善了模型的感知和表述能力,但在核心的物理推导环节,所有模型的表现都极为有限。即使是目前最先进的专有模型,其整体得分也仅为0.473。这一分数不仅远低于人类水平,甚至低于随机猜测的期望值,表明模型在物理推理上存在系统性缺陷。
具体而言,专有模型的表现整体优于基础开源模型,这暗示了大规模、高质量视频训练确实能蒸馏出一些有用的物理先验。经过视频推理微调的VBVR-Wan2.2模型表现更具竞争力,而GPT Image 2和Nano Banana 2等模型在显式理解和可控视觉生成方面的优势,使其在标注读取和物体定位上表现突出。然而,这些优势并未转化为物理推导能力的显著提升。
深入分析错误分布发现,模型的失败并非仅发生在最终生成阶段,更多体现在中段的物理推理环节。即使部分模型能够准确读取标注并定位物体,它们在物理规则选择、状态更新以及后续运动预测上仍表现出明显的不足。这表明,当前模型更多依赖表层视觉模式匹配,尚未建立起稳定的物理状态建模能力。它们是在“模仿”运动,而非“计算”运动。
局限性与未来方向:通往通用模拟的漫长道路
尽管Apple-π在评估物理推理方面取得了突破,但其局限性也不容忽视。首先,测试范围主要聚焦于经典刚体力学,如重力、碰撞和牛顿第一定律,并未涵盖流体动力学、热力学、电磁学、断裂力学、颗粒介质、生物运动或量子现象等更复杂的物理场景。其次,数据中的动态物体仅限于球体、立方体等简单几何体,且使用单一固定相机,未考察多视角一致性或新视角生成能力。
此外,Apple-π的输入设置依赖第一帧标注来固定场景与物理量的对应关系,这意味着它主要考察模型在已知视觉场景下的推理能力,而非从文本构造完整物理场景的能力。在评估方式上,MLLM裁判的主观判断仍存在偏差,而基于掩码和像素的客观指标则受到分割质量、画面差异和标注噪声的影响。时间归一化问题也是一个技术难点,视频生成服务返回的固定长度视频容器可能与请求的物理时长不匹配,从而影响评估结果的准确性。
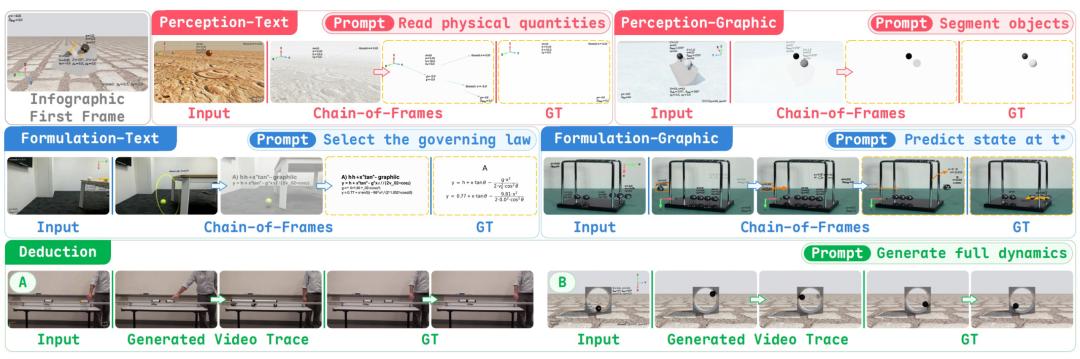
这些局限性揭示了构建通用世界模型的巨大挑战。要实现真正的物理理解,未来的研究需要在多个维度进行突破。首先,需要赋予视频世界模型更强的场景理解能力,使其能够从非结构化数据中提取抽象的物理概念。其次,需要构建更丰富的物理推理数据集,涵盖更多样的物理现象和复杂的交互场景。最后,专门面向推理的后训练策略至关重要,通过强化学习或思维链技术,引导模型显式地进行物理计算和逻辑推导,而非仅仅依赖隐式的视觉关联。
结语:理性看待AI的物理能力
Apple-π基准的研究结果提醒我们,尽管AI在视觉生成领域取得了令人瞩目的进展,但在物理世界的深层理解上,我们仍处于早期阶段。模型生成的逼真视频,往往是统计规律与视觉美学的结合,而非物理定律的体现。属于世界模型的“ChatGPT时刻”依然遥远,这需要我们在算法架构、数据质量和训练范式上进行根本性的创新。
对于行业而言,这一发现具有重要的指导意义。在自动驾驶、机器人控制、物理仿真等对物理一致性要求极高的领域,直接依赖当前视频生成模型可能存在风险。我们需要开发专门的物理引擎或混合架构,将数据驱动的方法与基于规则的物理模型相结合,以确保系统的安全性和可靠性。
未来,随着多模态大模型与物理仿真技术的深度融合,世界模型有望逐步突破当前的瓶颈。但在此之前,保持理性的批判性思维,深入理解模型的局限性,是推动人工智能向更高阶认知能力迈进的必要前提。只有当模型真正学会像物理学家一样思考,而非仅仅像艺术家一样模仿,我们才可能迎来通用人工智能的真正曙光。