响应0.7秒登榜首?Grok 2.0如何颠覆语音智能体竞争格局
在人工智能语音交互领域,延迟一直是阻碍“拟人化”体验的核心瓶颈。长期以来,语音模型往往受限于推理链路的串行处理模式,导致用户在对话中不得不忍受明显的停顿感。然而,2026年7月30日,SpaceX AI发布的Grok Voice Think Fast 2.0模型,试图通过技术架构的重构,彻底打破这一限制。这一新模型不仅在权威评测中登顶智能体性能榜单,更以0.7秒的首音频响应时间,重新定义了实时语音交互的标准。
01. 性能突破:从“听得见”到“像真人”
Grok Voice Think Fast 2.0的核心竞争力,首先体现在其对“智能体”属性的强化。在AI发展初期,语音模型主要解决的是语音转文字(STT)和文字转语音(TTS)的准确性问题。但随着大语言模型能力的溢出,行业重心已转向语音作为入口的复杂任务处理能力。
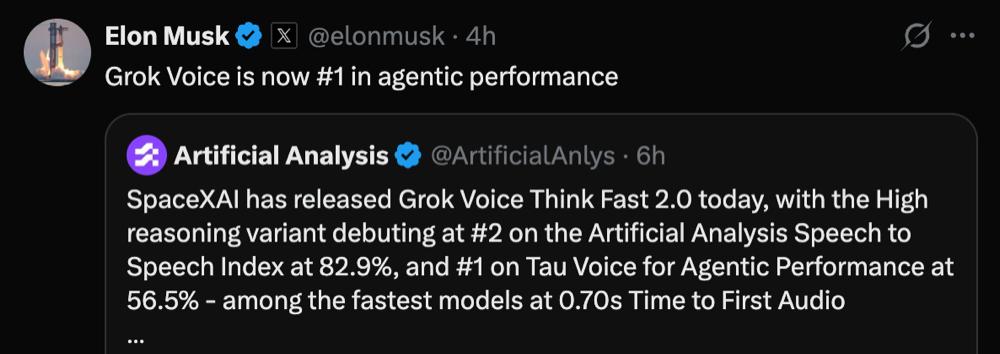
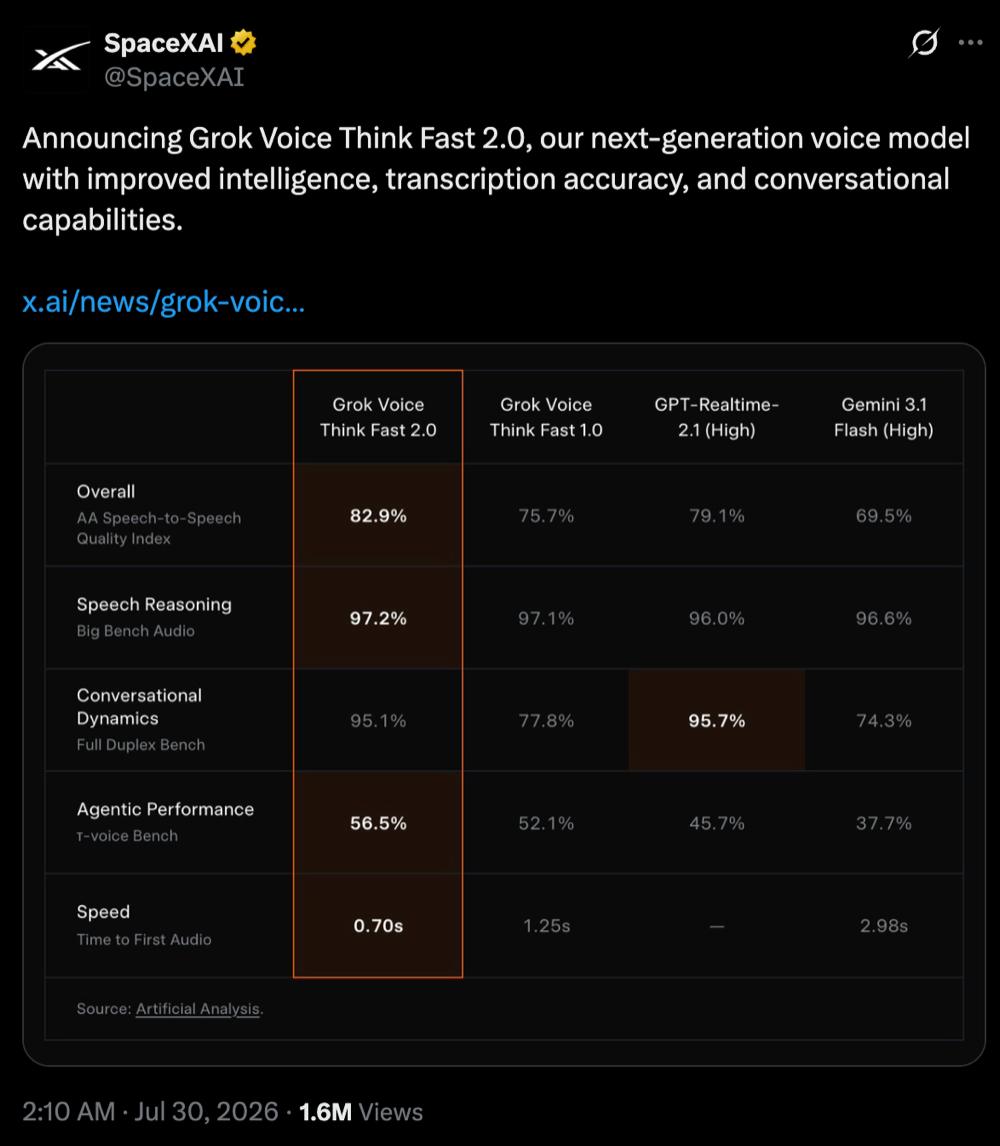
根据权威评测机构Artificial Analysis公布的数据,Grok Voice Think Fast 2.0在衡量语音到语音综合能力的Speech-to-Speech Index中得分高达82.9%,位列榜单第二,仅略低于千问Qwen Audio 3.0。但在更具挑战性的Tau Voice基准测试中,该模型以56.5%的得分强势登顶。这一基准测试专门用于评估模型在多轮对话中的智能表现,包括意图理解、上下文记忆以及工具调用能力。
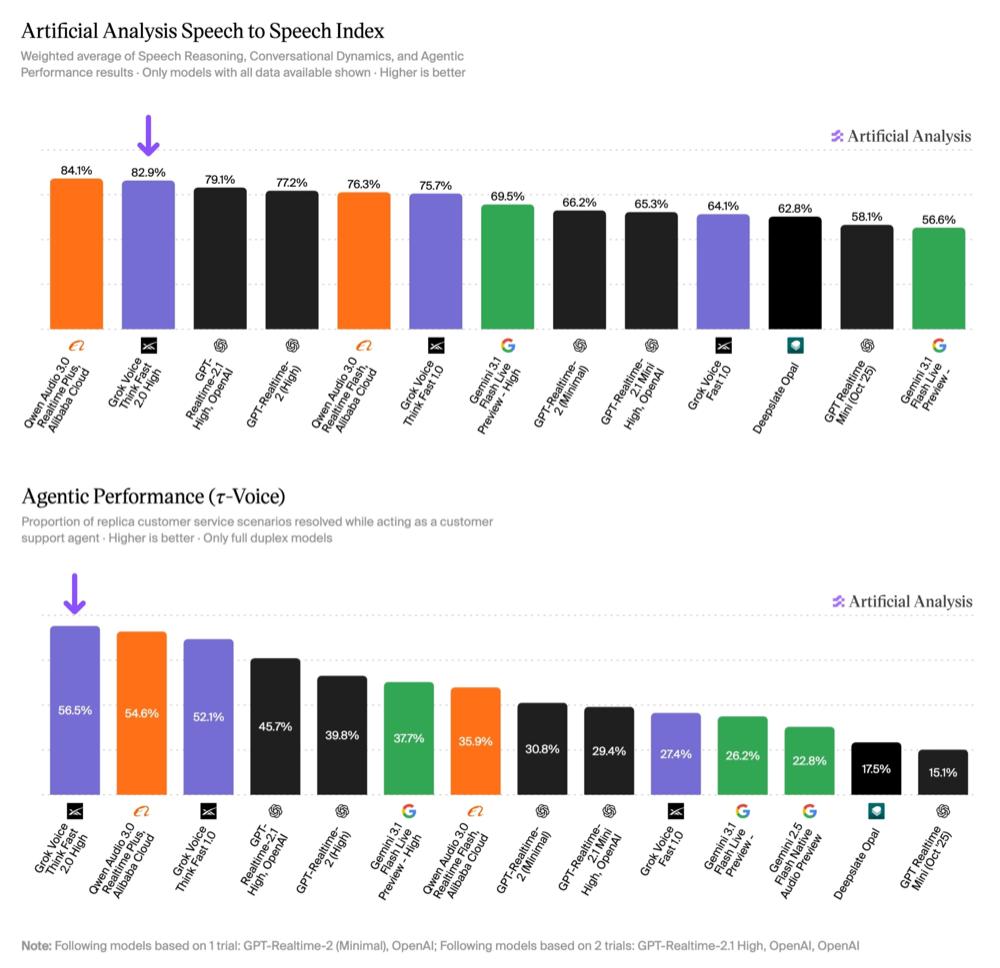
这一排名的意义在于,它标志着竞争焦点的转移。早期的竞争集中在语音合成的自然度和识别准确率上,而现在的竞争则聚焦于模型是否能像人类一样,在对话中实时思考、推理并执行操作。Grok Voice Think Fast 2.0的登顶,表明其在理解用户意图并即时反馈方面,已超越了OpenAI、Google及阿里等头部厂商的同类产品。
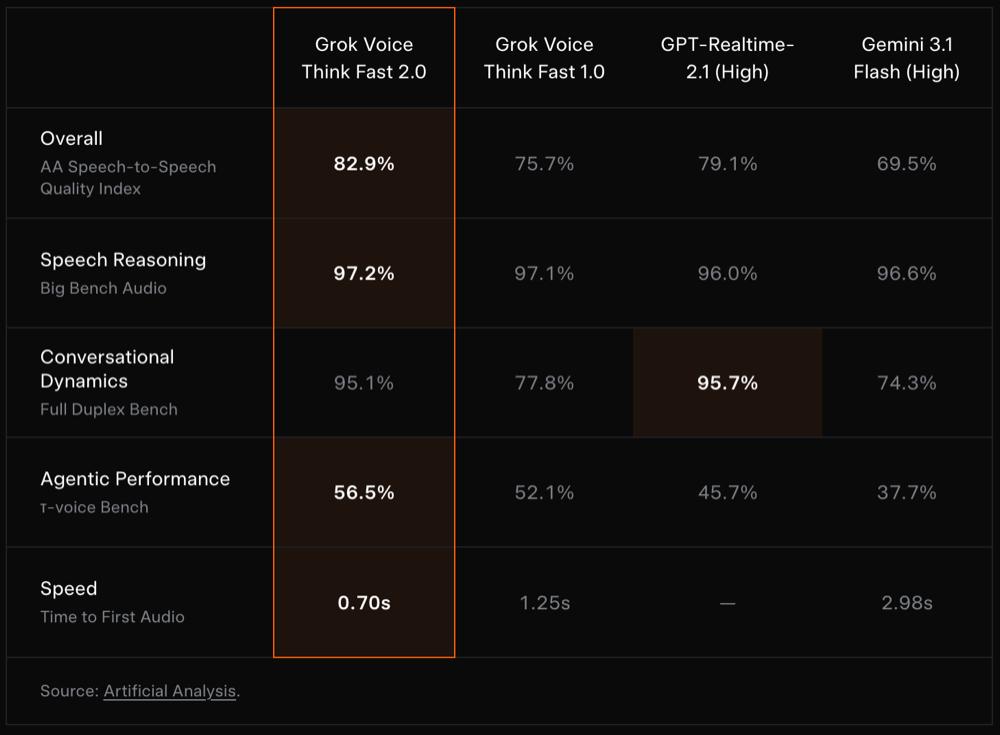
除了智能性,响应速度是另一大杀手锏。该模型的平均首音频响应时间仅为0.70秒。在语音交互中,超过1秒的延迟往往会被用户感知为“卡顿”或“不专注”。作为对比,榜单前列的GPT-Realtime-2.1 High响应时间约为1.21秒,而Grok的前代版本Think Fast 1.0也需1.25秒。0.70秒的速度意味着,在正常的对话节奏中,用户几乎感觉不到等待,这种“无感延迟”是提升用户体验的关键。
02. 技术重构:“边说边推理”的架构革新
Grok Voice Think Fast 2.0之所以能实现如此低的延迟,核心在于其底层推理架构的创新。传统语音模型通常采用串行工作流:先完成语音识别,再将文本输入大语言模型进行完整推理,最后生成语音回复。这种模式在处理长逻辑链任务时,必然产生较长的等待时间。
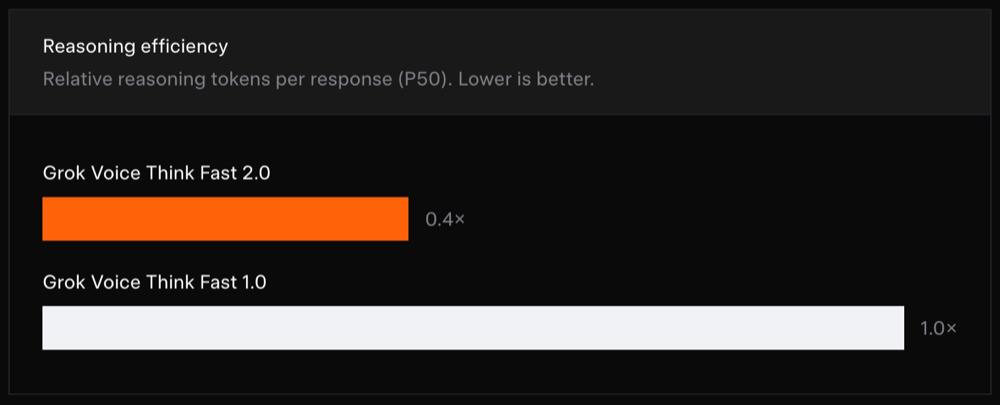
Think Fast 2.0引入了流式推理机制,支持“边说边推理”。模型在接收用户语音输入的同时,并行启动推理过程。这意味着,当用户话音未落时,模型已经开始思考回复内容。更关键的是,研发团队优化了推理Token的利用效率。数据显示,Think Fast 2.0的中位数推理Token消耗仅为上一代模型的约40%。
这一优化带来了直接的工程价值:工具调用可以在模型生成第一句话结束前就开始执行。例如,当用户要求“查询明天的天气并预定机票”时,模型可以在口头回复“正在为您查询天气”的同时,后台已提前调用天气API。这种异步并行处理极大缩短了端到端的响应时间,使得语音智能体能够胜任高复杂度的业务场景。
此外,对话风格的调整也提升了交互的自然度。通过大规模强化学习数据的训练,模型学会了更接近人类交流的语用习惯。它倾向于使用短句,避免冗长重复,并在一次对话中只聚焦一个问题。这种设计不仅降低了模型的计算负载,也让用户更容易跟上对话节奏,避免了“信息过载”带来的认知疲劳。
03. 场景验证:开发者实测与真实环境挑战
技术参数的提升最终需要落地到具体场景中。多位开发者在发布后的实测反馈,验证了Grok Voice Think Fast 2.0在实际应用中的潜力。
Helionova AI的CEO Nick White在其实测中将模型集成至客户服务场景。他模拟了一名愤怒的客户投诉维修人员迟到的对话。在整个多轮交互中,模型不仅准确捕捉了用户的情绪变化,还能根据客服的回应实时调整态度,情节推进流畅,几乎没有出现逻辑断层或明显停顿。这种在高压、高情绪语境下的稳定表现,对于自动化客服系统而言至关重要。
另一位开发者在终端工具GrokTerm中进行了指令响应测试。面对“切换赛博朋克主题”、“切回原主题”、“切换屏幕布局”等一系列快速连续指令,模型均能迅速识别并执行操作。这表明,Grok Voice在快速指令处理方面具备极高的鲁棒性,适合需要高频交互的操作型场景。
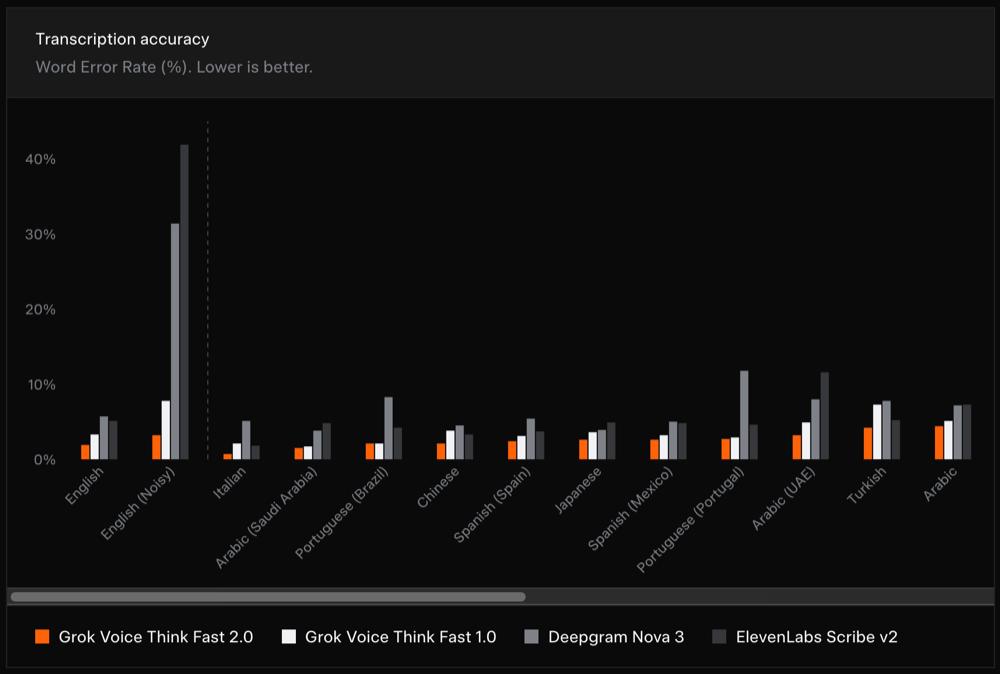
在语音识别方面,新模型也展现了显著的进步。在覆盖24种语言的测试集中,其转写准确率相比前代提升约1.4倍,相比Deepgram Nova 3等专用识别模型提升1.5至2倍。更重要的是,在背景噪声大、电话线路压缩等真实恶劣环境下,其识别误差降低了约10倍。这一数据表明,Grok Voice不仅在理想实验室环境下表现优异,在实际生产环境中也具备极高的可用性,这对于企业级应用落地是一个重要的里程碑。
04. 商业考量:性价比重塑市场格局
除了技术性能,定价策略也是影响技术普及的关键因素。Grok Voice Think Fast 2.0的定价为每分钟0.08美元,折合每小时输入音频成本约为4.80美元。虽然相比前代的3.00美元/分钟有所上涨,但与OpenAI的GPT-Realtime-2.1 High相比,其成本仅为后者的约45%。
在AI应用开发中,语音交互往往涉及大量的实时流式处理,成本敏感度高。对于开发有声剧生成、多角色对话模拟、实时电话助手等应用的企业而言,大幅降低的单次调用成本意味着可以承载更高的并发量和更长的对话时长。这种极具竞争力的定价,使得Grok Voice成为OpenAI和Google Gemini之外,极具吸引力的替代选择。
评论区中,不少开发者表达了对新模型的期待。有人希望利用其多角色生成能力创作有声内容,有人则表示终于有了不再单一依赖Gemini的备选方案。这种多元化的需求反馈,预示着语音智能体市场将从“技术竞赛”走向“应用繁荣”。
05. 行业展望:语音智能体的下一个阶段
SpaceX AI此次发布Grok Voice Think Fast 2.0,不仅是单点技术的突破,更是对整个语音AI行业方向的确认。随着默认模型在8月5日完成全面升级,更多企业和开发者将有机会在其实际业务中验证这一性能。
当前,语音模型的竞争已进入“智能体时代”。单纯的语音合成或识别已不再是护城河,真正的壁垒在于模型能否理解复杂语境、执行精准工具调用,并在极低延迟下完成多轮逻辑交互。Grok Voice Think Fast 2.0在Tau Voice基准测试中的领先,以及其在推理效率上的优化,表明SpaceX AI正在构建一个更自主、更高效的语音交互基础设施。
未来,随着“边说边推理”架构的普及和推理成本的进一步降低,我们可以预见更多实时语音智能体将涌入市场。从个性化的私人助理到全天候的客服专家,语音交互将从“命令式”向“协作式”转变。在这一进程中,低延迟、高智能且高性价比的模型,将成为推动这一变革的核心动力。
对于开发者而言,Grok Voice Think Fast 2.0的出现提供了一个新的技术选项。它既保留了高性能的推理能力,又提供了极具竞争力的成本优势。在激烈的市场竞争中,这种平衡能力或许正是其能够迅速登顶榜单的关键。随着更多应用场景的落地,语音智能体的边界将被进一步拓展,一个更加自然、高效的语音交互世界正在加速到来。