Anthropic天价和解背后的文明隐忧:AI训练能否逾越版权红线?
巨额和解背后的合规警钟
在人工智能飞速发展的今天,数据被视为新的石油,而版权纠纷则成为了阻碍开采的复杂法律迷宫。2026年7月,随着Anthropic与其版权方长达近两年的诉讼达成15亿美元的和解协议,这场堪称AI历史上最昂贵的版权案终于落下帷幕。这一数字令人咋舌,甚至超过了Anthropic在2023至2025年间累计约50亿美元的总营收。
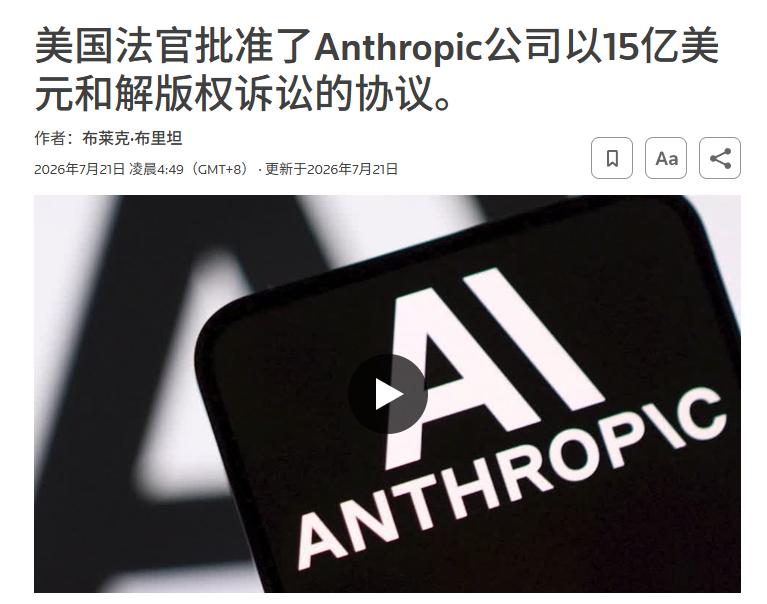
这不仅仅是一笔天文数字的赔偿,更是一个强烈的信号:资本对AI模型的狂热追逐,必须开始敬畏知识产权的红线。作为以“对齐”和“人类福祉”为核心理念的AI公司,Anthropic此次面临的危机,不仅关乎财务损失,更关乎其品牌根基的道德合法性。法院的果断判决打破了以往科技巨头在版权问题上往往通过长期拉锯战拖延时间的惯例,明确传递出“先赔偿、后发展”的监管导向。
从The Pile到Books3:被遗忘的违规源头
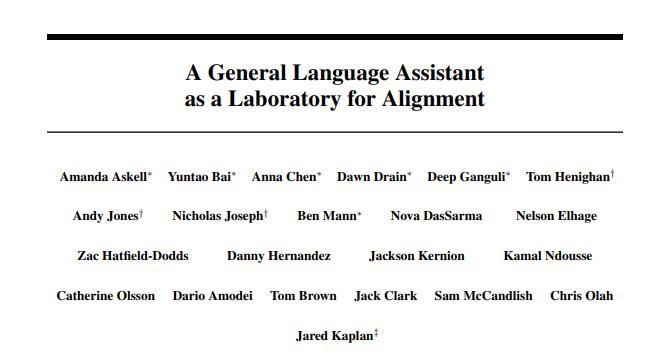
追溯这场危机的根源,需要将时间拨回至2021年底。当时,Anthropic发布了一篇关于早期大模型训练数据的学术论文,其中引用的The Pile数据集成为了争议的导火索。该数据集包含一个名为Books3的子集,其中汇集了近20万本未经授权的电子书。在AI模型的训练早期,这类数据集因其内容丰富且易于获取,被多家主流模型广泛采用。
然而,随着商业竞争的加剧,数据合规性逐渐凸显。2024年,媒体对AI企业使用The Pile进行商业模型训练的调查,迫使Anthropic公开承认其商业模型Claude确实使用了包含侵权内容的训练数据。这一承认直接引爆了版权方的怒火。原告方认为,Anthropic非法使用其作品训练出能够产生商业价值的模型,却未给予创作者任何补偿,这在道德和法律层面均难以接受。
更深层次的调查发现,Books3仅是冰山一角。通过法律程序的深入挖掘,原告揭示了Anthropic内部数据收集过程中存在的更大规模违规行为,包括从LibGen等盗版网站获取的数百万本受版权保护的书籍。这些数据的非法获取,构成了这起集体诉讼的核心证据,也揭示了AI数据清洗环节中普遍存在的“法不责众”侥幸心理。
破坏性扫描:法律漏洞还是道德陷阱?
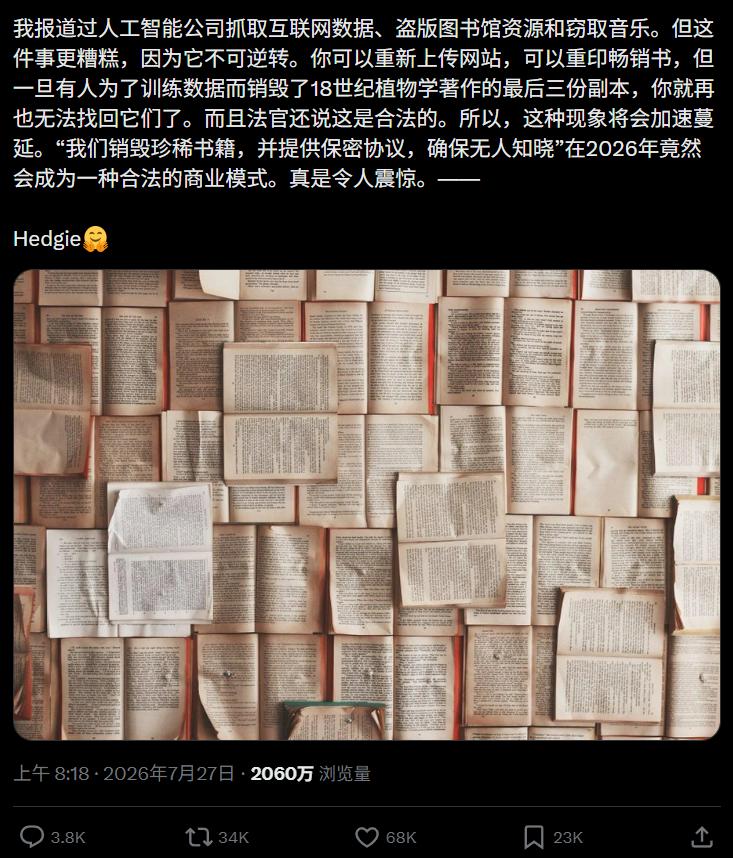
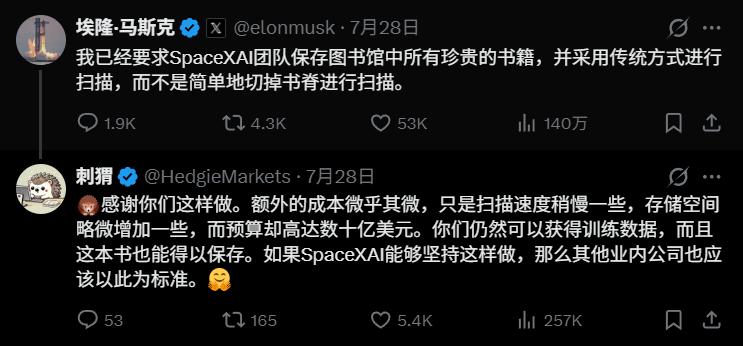
在案件审理过程中,Anthropic提出的一项操作引发了广泛争议,即“破坏性扫描”。2024年,面对版权风险的压力,Anthropic采取了一种极端的合规策略:购买实体纸质书籍,通过机器进行去皮切页的破坏性扫描,随后立即销毁原书,仅保留数字扫描数据用于内部模型训练。
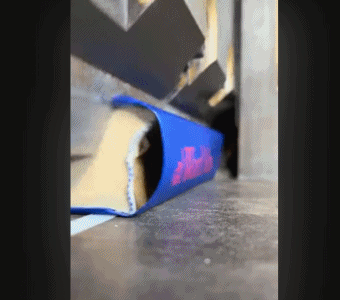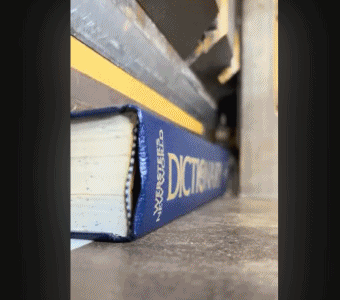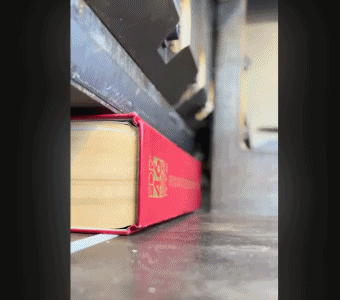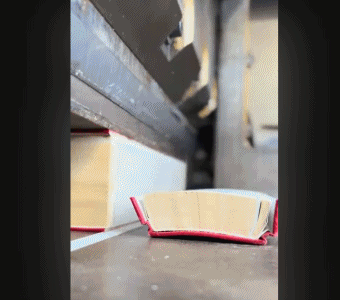
这一操作在法律上利用了美国的“首次销售原则”。根据该原则,合法购买作品的拥有者有权处置该特定副本,包括将其用于其他用途或销毁。Anthropic辩称,由于他们没有制作新的物理副本,且原书已被销毁,因此这一行为并未侵犯版权法中的复制权。
然而,这一法律辩护在道德层面遭遇了严厉抨击。许多学者和公众指出,这种为了规避法律风险而采取的极端手段,实质上是一种“懂法但不守法”的投机行为。更令人担忧的是,被扫描销毁的书籍中,可能包含稀有的孤本、绝版书或具有极高艺术价值的文献。这些书籍一旦销毁,可能在物理世界上彻底消失,成为人类文明记忆的永久缺失。
相比之下,Google Books项目提供了另一种范式。Google在扫描图书时保留了原件,建立了完整的数字图书馆,并被法院认定为合理使用。Anthropic选择成本更低、更彻底的破坏性扫描,虽然符合法律字面意义,却暴露了其对知识共享精神的漠视,以及在利润驱动下对文化遗产保护的无视。
法律博弈中的利益分配与行业示范
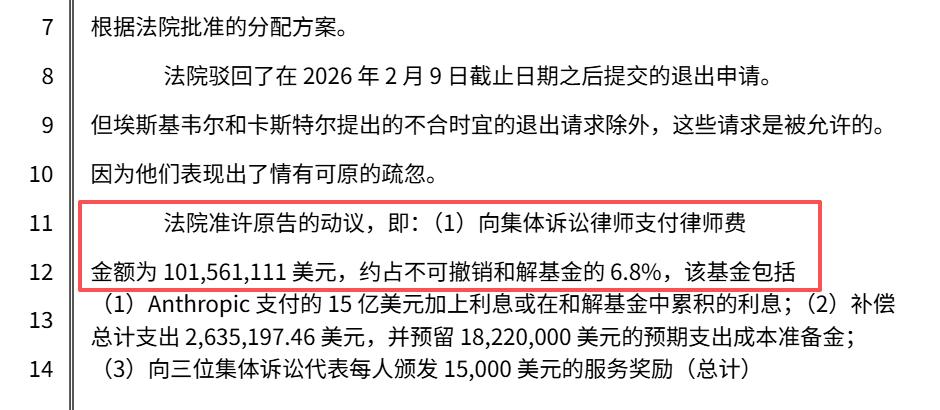
尽管Anthropic支付了巨额和解金,但案件的最终结果也反映了法律诉讼中的利益分配机制。据统计,91.3%的被侵权作品已参与申领,每本可获得3000美元的和解金。然而,律师团队从中抽取了高达1亿美元的佣金,这一比例引发了公众对“律师致富、创作者微利”现象的讨论。
从行业角度看,此案的确立具有深远的示范效应。它终结了AI公司在版权问题上“先斩后奏”或“模糊处理”的空间。法院的判决表明,监管机构不再容忍以技术创新为名行侵权之实的行为。对于尚未决断的同类案件,这一判决提供了明确的参考坐标:即版权方有权获得实质性赔偿,且科技公司需为其数据获取方式的合法性承担最终责任。
此外,该案还揭示了AI竞赛中一个被忽视的维度:数据的伦理成本。在追求模型性能提升的同时,如何确保数据来源的合法性与道德性,已成为决定AI企业能否长期存活的关键因素。Anthropic的案例警示所有AI开发者,合规不再是事后的补救措施,而是产品研发初期必须纳入的核心考量。
平衡创新与权益:未来的挑战
Anthropic的和解并未终结AI与版权的争论,反而开启了更复杂的对话。随着生成式AI技术的普及,如何界定“训练使用”与“侵权使用”的边界,依然是法律界和学术界争论的焦点。如果AI生成的内容在风格或表达上高度复刻真人作品,是否构成侵权?责任主体应归于模型开发者、数据提供商,还是用户?
这些问题没有简单的答案,但Anthropic的教训提示我们,解决方案不能仅依赖法律条文的技术性规避,更需要行业共识的建立。AI企业应主动建立透明的数据溯源机制,与创作者社区建立公平的利益分享模型,而非试图通过技术手段绕开版权保护。
同时,社会也需要重新审视“知识垄断”的概念。在数字化时代,知识的共享与保护并非零和博弈。真正的文明进步,应当是在保护创作者权益的基础上,促进知识的广泛传播与创新利用。Anthropic一边呼吁控制AI风险,一边大肆扫书毁书训模型的行为,恰恰反映了当前AI产业在价值观层面的撕裂。
结语:回归良心的技术竞赛
在这场没有终点的AI竞赛中,Anthropic或许赢得了法律层面的暂时喘息,却输掉了公众信任的长远账本。相比于宏大叙事中的“人类长期福祉”或“超级智能安全”,解决具体的版权纠纷、尊重每一位创作者的劳动成果,才是更紧迫、更现实的伦理命题。
技术不应是焚书的烈火,而应是照亮文明的火炬。当AI企业能够放下对数据的贪婪掠夺,转而寻求与人类知识体系的和谐共生时,真正的智能革命才会到来。否则,任何建立在掠夺之上的技术大厦,都将在版权的大棒下摇摇欲坠。未来的AI发展,必须在创新与尊重之间找到新的平衡点,这不仅是法律的要求,更是文明延续的底线。