AI巨头“焚书”取料引争议,马斯克呼吁无损扫描背后的版权博弈
在人工智能技术呈指数级爆发的当下,数据已取代石油,成为驱动大模型进化的核心燃料。然而,随着互联网上由AI生成的内容如潮水般泛滥,那些经过人工精心打磨、逻辑严密且未被算法“污染”的高质量文本,正迅速沦为稀缺资源。这种供需关系的剧烈倒转,不仅重塑了AI企业的采购策略,更将出版业推向了舆论的风口浪尖。近期,关于AI巨头“焚书”以获取训练语料的报道,引发了全球范围内的伦理与法律大讨论。
据独立媒体404 MediaX披露,部分人工智能公司正在采取一种极端的数据获取方式:批量购买2022年前出版的珍稀书籍。之所以锁定这一时间节点,是因为业界普遍认为,2022年之前出版的图书主要包含人类创作内容,而此后则混杂了大量AI生成文本。为了提取这些“干净语料”,企业利用液压切割机切除书脊,对书页进行高速扫描,随后将实体书粉碎销毁。这一被称为“巴拿马计划”的行动,由Anthropic主导,旨在确保训练数据的纯净度,防止数据回流市场后被二次污染。
尽管这一做法在商业逻辑上看似高效,但在公众眼中却显得冷酷且极具破坏性。据报道,Anthropic已销毁数百万册实体书,其中不乏存世量极少的绝版古籍。这种对物理载体的毁灭性处理,触动了文化保护主义者的敏感神经。然而,从法律层面来看,美国联邦法院近期的一项判决为这一行为提供了某种程度的合法性背书。法院认定,“合法购买纸质书再加以破坏性扫描”属于“合理使用”范畴。这一判例虽然解决了当下的法律争议,却未能平息道德层面的质疑,反而加剧了科技巨头与传统出版业之间的对立情绪。
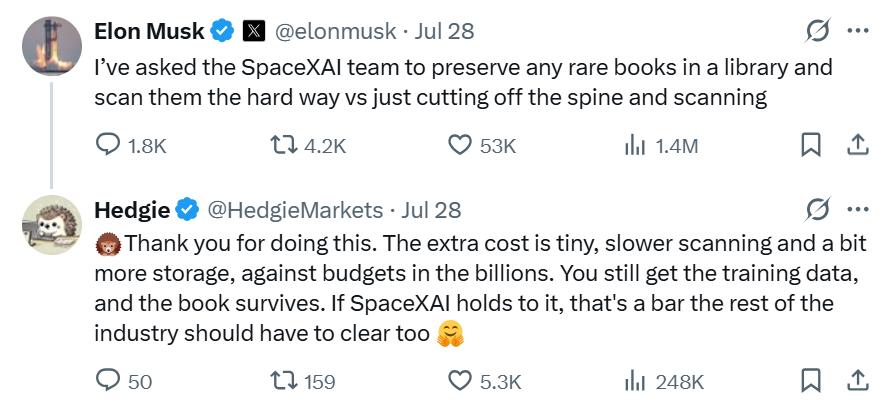
舆论的发酵迅速蔓延至社交媒体平台。在X平台上,账号Hedgie转述了此事后,埃隆·马斯克做出了回应。他明确表示,已要求SpaceX AI团队采取不同的策略:保存图书馆中所有珍贵书籍,并采用无损扫描方式获取数据。马斯克强调,虽然无损扫描的速度较慢,但能够避免对书籍造成物理破坏。这一表态被解读为对行业标准的重新定义。Hedgie随即回应称,如果SpaceX AI能坚持这一高标准,其他公司也应效仿。马斯克的介入,不仅提升了该话题的热度,更暗示了AI行业内部对于数据获取伦理的分歧。
事实上,书籍作为AI训练语料的重要来源,其地位日益凸显。ISBNdb等图书数据库服务商已转型为AI企业的“图书数据供应商”,提供大批量采购服务。与此同时,Anthropic与Better World Books等二手书平台的合作,进一步打通了从实体书到数字语料的转化链条。这种转变标志着AI数据获取从“网络抓取”向“实体资源挖掘”的延伸,也反映出高质量人工创作内容的不可替代性。
然而,这种单方面的数据攫取并未得到内容创作者的广泛认可。海外出版传媒集团与AI企业之间的法律纠纷频发,成为行业常态。7月22日,新闻集团向加州奥克兰联邦法院提起反诉,指控Brave Software未经授权大规模抓取并转售《华尔街日报》《纽约邮报》等旗下媒体的文章内容,用于AI模型训练。这一诉讼不仅涉及搜索引擎的合规性,更触及了媒体内容在AI时代的版权归属问题。
无独有偶,7月14日,一群主要出版商对谷歌提起诉讼,指控其非法使用数百万本受版权保护的书籍构建Gemini人工智能模型。出版商方称这是“历史上最严重的侵犯版权行为之一”。谷歌内部人士则透露,若将出版商提供的文本用于Google Play图书,公司可能面临高达1000亿美元的潜在罚款。这些巨额索赔不仅反映了版权方对AI侵权行为的零容忍态度,也揭示了AI企业在数据合规方面面临的巨大财务风险。
面对激烈的法律冲突,出版业并未处于被动挨打的地位。相反,随着AI对优质语料需求的激增,出版企业的核心资产价值正在被重新评估。中信证券研报指出,预计2026年文化IP数字化运营有望为出版业带来约700亿元的增量空间。大模型训练需要海量的优质语料数据,而出版企业所拥有的内容资产,恰恰提供了丰富且高质量的语言素材。这种供需关系的契合,为出版业的数字化转型提供了新的契机。
中泰证券进一步分析认为,相关出版公司的内容版权归属较为清晰,且在垂直领域具有明显的优势。这使得出版企业有望跨越互联网、AI等多个技术周期,成为持续发展的底层核心资产。在AI时代,版权不再仅仅是法律保护的符号,更是具有极高商业价值的数字资产。出版企业可以通过授权、合作等方式,将内容资产转化为AI训练语料,从而在新一轮的技术变革中分得一杯羹。
然而,这一转型过程并非坦途。如何在保护版权与促进技术创新之间找到平衡点,是行业面临的最大挑战。马斯克的“无损扫描”提议,虽然提供了一种折中方案,但在实际操作中仍面临效率与成本的考量。对于AI企业而言,如何在确保数据质量的同时,尊重内容创作者的权益,建立可持续的数据获取机制,将是决定其长期竞争力的关键。
从更宏观的视角来看,AI与出版业的博弈,实质上是数字时代知识生产与传播模式的重构。纸质书籍作为知识的物理载体,其价值不仅在于内容本身,更在于其承载的文化意义与历史价值。AI技术的介入,既带来了数据获取的便利,也引发了对文化传承的担忧。如何在技术效率与文化保护之间寻求平衡,需要政府、企业、学术界及公众的共同努力。
未来,随着相关法律法规的完善与技术标准的建立,AI数据获取有望走向规范化。版权授权、数据交易等市场化机制将逐步成熟,为AI企业提供合法、合规且高质量的数据来源。同时,出版业也将借助AI技术,实现内容的数字化升级与多元化运营,拓展新的商业模式。
在这场关于数据与版权的博弈中,没有绝对的赢家。AI企业需要尊重内容创作者的劳动成果,出版业也需要拥抱技术变革,探索新的价值实现路径。唯有通过合作与对话,才能构建一个健康、可持续的数字内容生态,让AI技术真正服务于人类知识的传承与创新。
值得注意的是,随着AI生成内容的普及,区分“人工创作”与“机器生成”将成为数据清洗的重要环节。2022年作为一个时间节点,虽然具有一定的参考意义,但并非绝对标准。未来的数据标注与筛选技术,将更加注重内容的原创性与质量,而非仅仅依赖出版年份。这将推动AI企业在数据获取上更加注重精细化与专业化,从而提升模型的整体性能。
综上所述,AI巨头“焚书”取料事件,不仅是技术与伦理的冲突,更是数字时代版权制度的一次压力测试。它提醒我们,在追求技术突破的同时,不能忽视对知识产权的尊重与保护。只有通过建立公平、透明的数据交易机制,才能实现AI技术与内容产业的共赢发展。