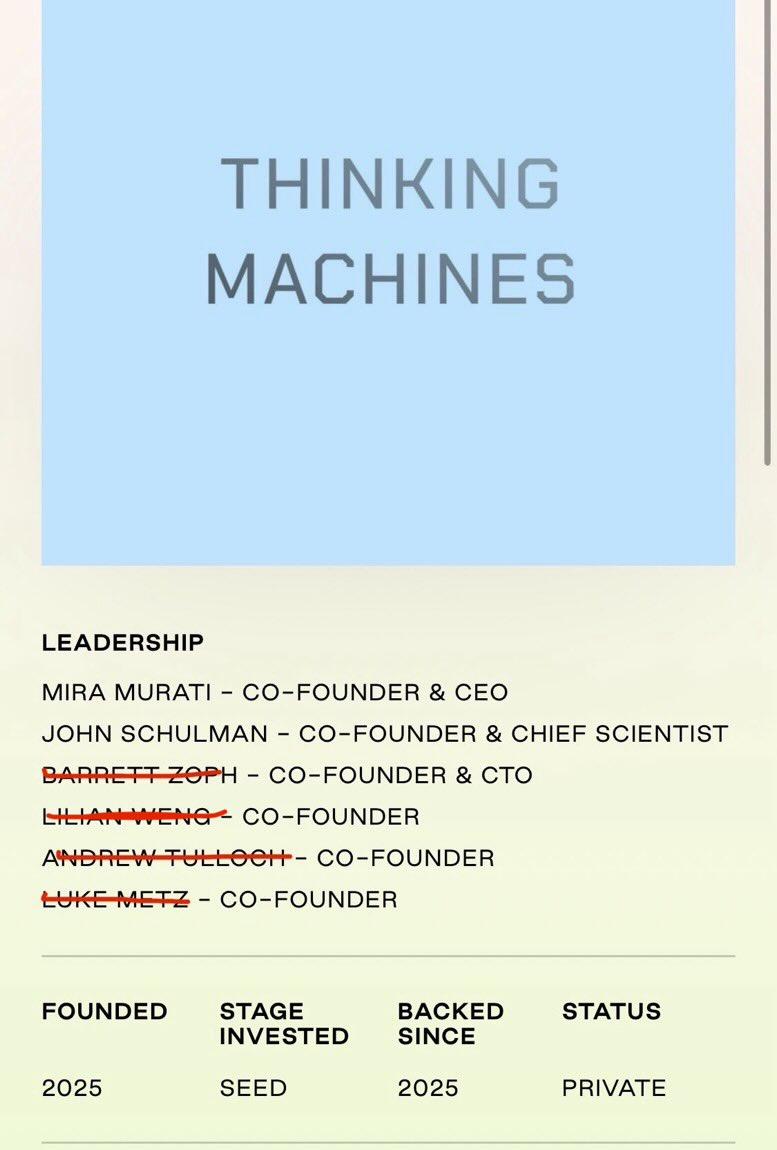
核心高管回流OpenAI,Thinking Machines为何加速开源Inkling-Small?
人才流动与模型迭代的悖论:Thinking Machines的战略转身
在人工智能行业的宏大叙事中,人才流动往往被视为技术路线变迁的风向标。近期,Thinking Machines(TM)经历了一场剧烈的人事震荡:联合创始人翁荔宣布离职并回归OpenAI,加入其主导的“递归自我提升”(RSI)项目。与此同时,Barret Zoph和Luke Metz也早已重返OpenAI阵营。然而,令人瞩目的是,在核心创始团队仅剩Mira Murati和John Schulman两人的情况下,Thinking Machines并未陷入停滞,反而在短短半个月内连续发布了两款重磅开源模型:初代Inkling及紧随其后的Inkling-Small。
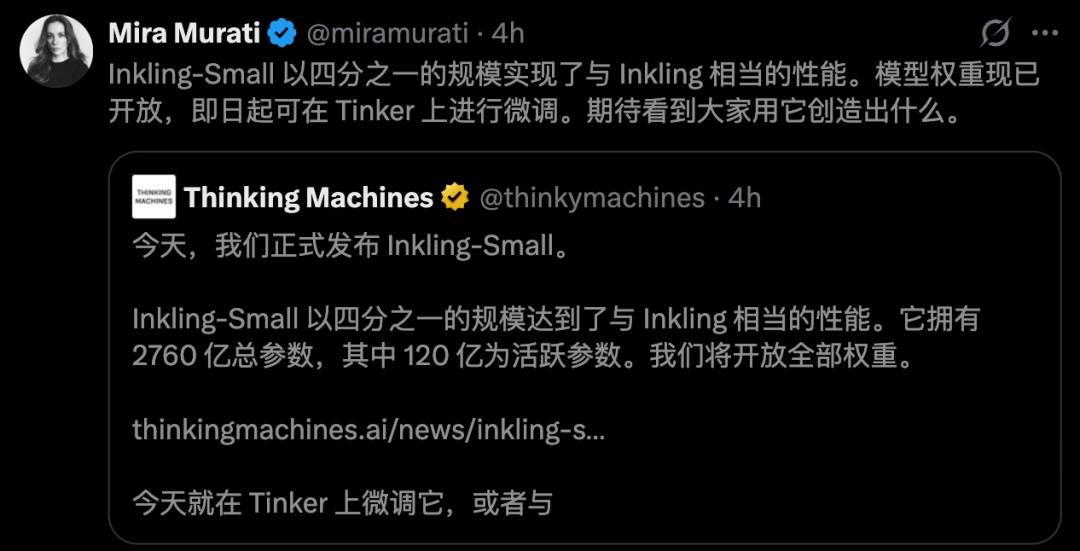
这种“人走茶未凉,模型反而快”的现象,折射出当前AI行业从依赖个人英雄主义向工业化、标准化研发体系转型的深刻趋势。Thinking Machines通过Inkling-Small的发布,不仅展示了其技术储备的厚度,更传递出一个明确信号:即便在团队动荡期,其研发管线依然具备强大的自我造血能力和持续产出能力。这不仅是对其技术架构稳健性的验证,也是对开源社区的一次强力背书。
Inkling-Small的技术突破:以少胜多的MoE架构艺术
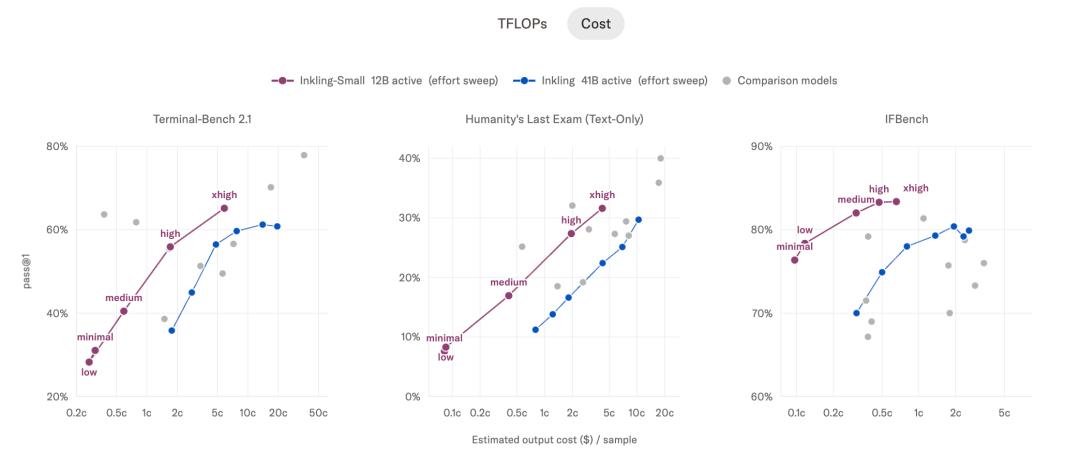
Inkling-Small的发布并非简单的版本迭代,而是一次在参数效率上的重大突破。该模型采用混合专家(MoE)架构,总参数量为2760亿,但单次推理仅激活120亿参数。相较于初代Inkling的975B总参数,Inkling-Small的体量缩减至四分之一,却在多项核心基准测试中实现了对“万亿大哥”的性能反超。
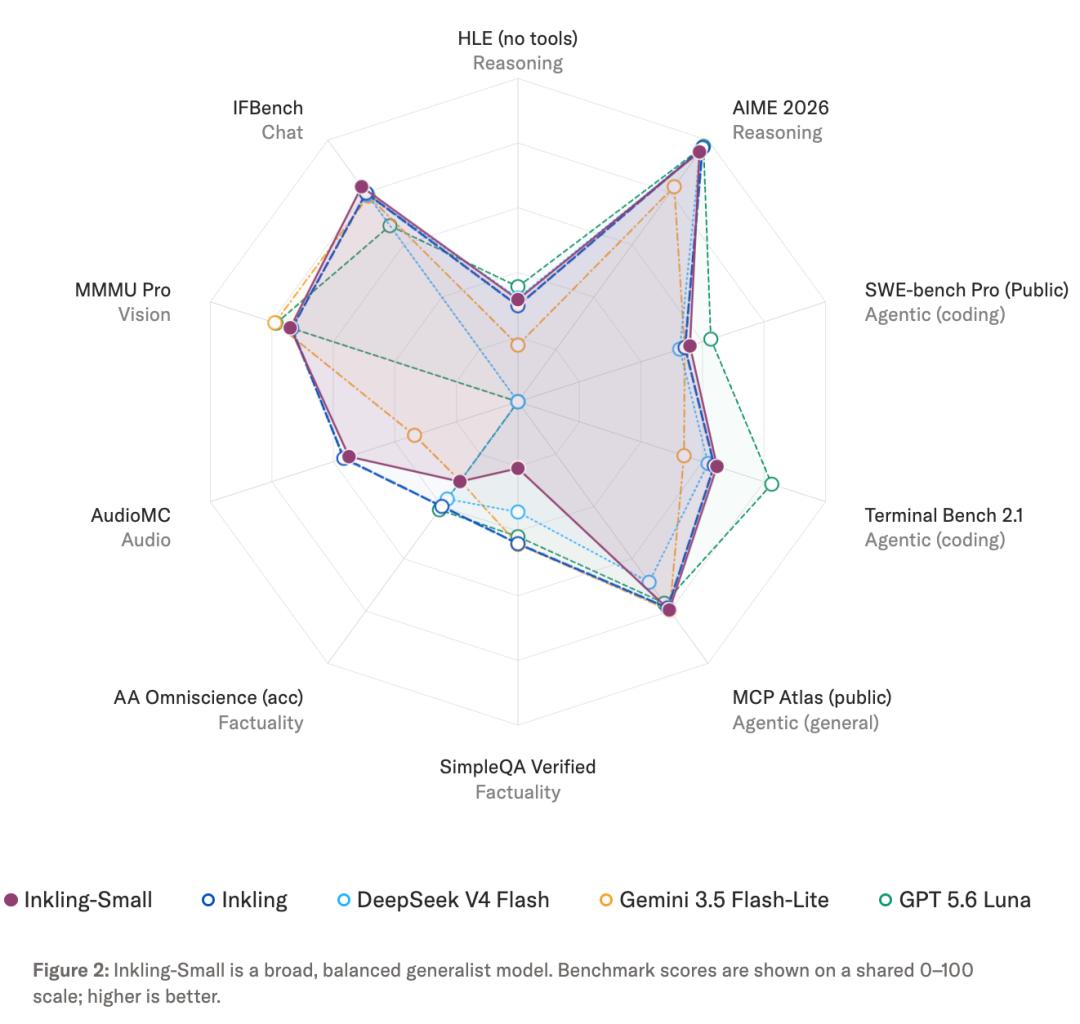
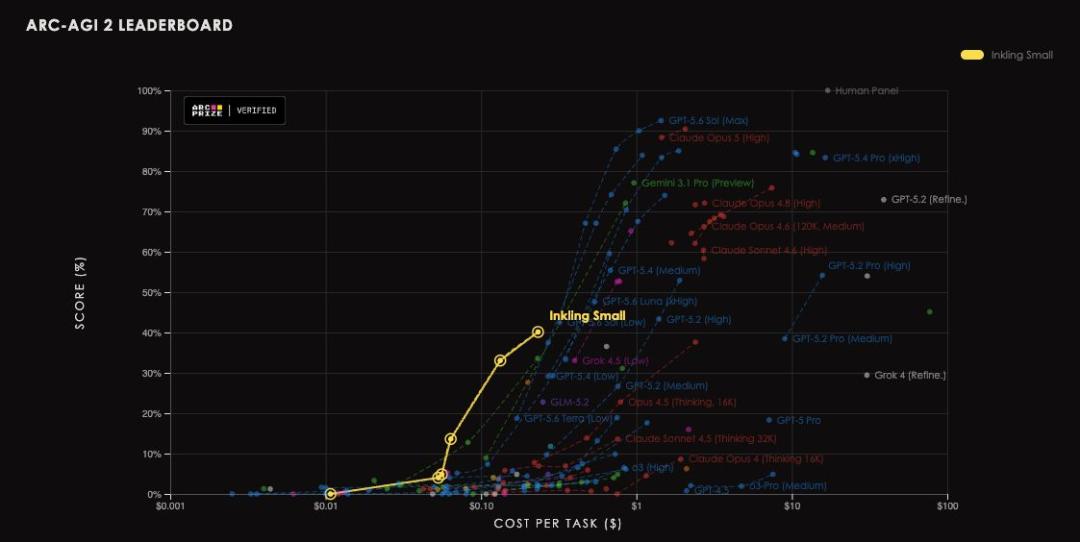
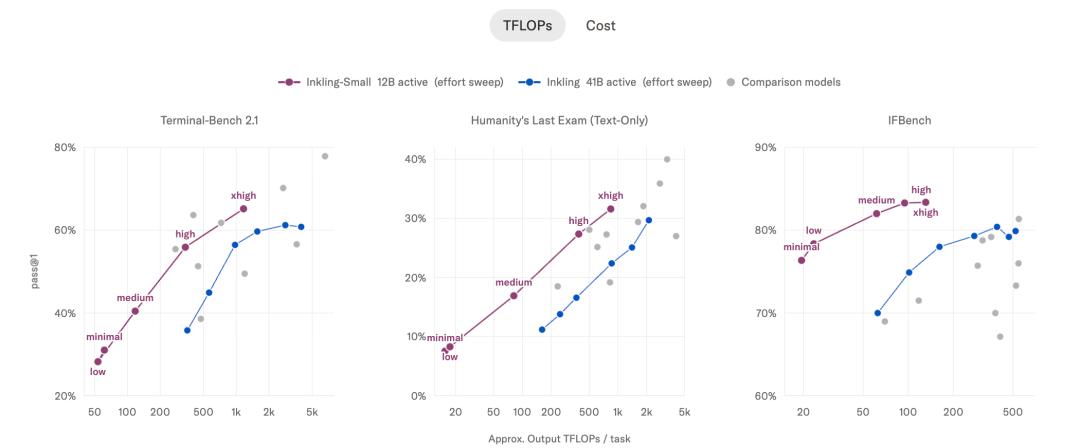
在ARC-AGI-2、HLE、Terminal-Bench及IFBench等权威评测中,Inkling-Small展现了卓越的推理能力和多模态理解能力。特别是在数学推理、智能体编码以及长上下文处理方面,其每FLOP(浮点运算)换来的性能指标均优于初代Inkling。这意味着,在相同的计算资源下,Inkling-Small能够提供更高质量的输出,极大地提升了算力利用效率。
多模态能力的均衡表现也是其亮点之一。在图表理解、视觉推理、语音理解及长音频推理等任务中,Inkling-Small的表现接近原版Inkling,但推理成本显著降低。这种“小体积、大能量”的特性,使其成为当前开源社区中极具竞争力的选择,尤其适合对推理延迟和成本敏感的应用场景。
后训练策略揭秘:On-policy蒸馏与强化学习的协同效应
Inkling-Small之所以能以较小的体量实现性能反超,关键在于其精心设计的后训练策略。官方公开的技术细节显示,训练过程主要依赖两个核心步骤:On-policy蒸馏和智能体编码强化学习。
首先,团队利用初代Inkling作为教师模型,进行On-policy蒸馏,生成一个高质量的预览检查点。这一过程不仅保留了教师模型的知识分布,还通过动态采样策略,使学生在训练过程中能够更有效地学习复杂推理路径。其次,从该检查点出发,团队进行了为期两周的智能体编码强化学习训练。这一阶段重点优化模型在代码生成、调试及复杂任务规划方面的能力,通过奖励模型引导模型探索更优的解决方案。
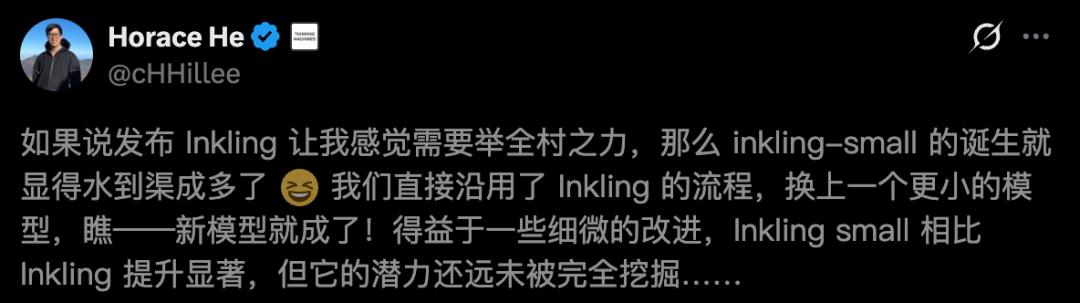
这种“蒸馏+强化学习”的组合拳,成功实现了“学生超越老师”的效果。它不仅验证了Thinking Machines在模型压缩和知识迁移方面的技术实力,也为后续模型的快速迭代提供了一条可复制的产线。正如PyTorch核心开发者Horace He所言,Inkling-Small的成功并非偶然,而是建立在前期充分踩坑和经验积累基础上的必然结果。
降低门槛:12B激活参数引发的开发者生态变革
对于广大开发者和中小型企业而言,Inkling-Small的最大价值在于其显著降低的部署门槛。初代Inkling要求至少2TB聚合显存,即便采用NVFP4量化,也需要600GB起步,这几乎将绝大多数独立开发者和中小团队拒之门外。
相比之下,Inkling-Small的12B激活参数使其能够在更常见的硬件配置上运行。实测数据显示,在8张B200 GPU、TP8并行、NVFP4量化及Batch Size为1的环境下,使用SGLang框架运行Inkling-Small,开启DSpark加速后解码速度可达648 tok/s,即使不开启加速也能达到288 tok/s。这一性能表现使得中等规模的团队也能轻松进行模型微调、LoRA适配及全参数训练,真正实现了大模型技术的民主化。
LMSYS(Large Model System Organization)指出,276B总参数配12B激活参数是强化学习的“甜点位”,既保证了模型的表达能力,又兼顾了训练和推理的效率。这一配置使得模型定制不再是大厂的专属特权,而是成为开发者生态中普遍可用的工具。这种开放性和可及性,将极大地激发创新活力,推动AI应用在不同垂直领域的落地。
行业启示:从封闭竞争到开源协作的范式转移
Thinking Machines的历程为AI行业提供了一个独特的观察样本。尽管核心创始团队成员陆续回归OpenAI,但Thinking Machines并未因此衰落,反而通过开源策略加速了技术扩散。这一现象表明,AI行业的竞争焦点正从封闭的模型权重争夺,转向开源生态的构建与开发者社区的培育。
开源不仅是技术共享的手段,更是建立行业标准、吸引人才和积累反馈的重要途径。Inkling-Small的发布,使得全球开发者能够基于这一高质量基座模型进行二次开发,从而加速了AI技术在医疗、金融、教育等垂直领域的应用落地。这种开放协作的模式,有望打破大厂垄断,促进技术创新的多元化发展。
此外,Thinking Machines在团队动荡期依然保持高强度的模型迭代,也反映了AI研发体系的成熟。现代大模型训练已不再是单纯依赖少数天才科学家的灵光一现,而是依靠标准化的数据流水线、高效的训练框架和严谨的评估体系。这种工业化能力,使得企业能够在人员变动的情况下,依然保持技术输出的稳定性。
结语:机器向前的车轮,不会因人事更迭而停止
回顾Thinking Machines的近期动态,我们看到的不仅是一款新模型的发布,更是AI行业演进方向的缩影。人才流动是常态,但技术进步的惯性却不可阻挡。Inkling-Small的成功,证明了在正确的技术路线和高效的研发体系下,即使面临核心人员流失,企业依然能够通过开源策略和技术创新,保持强大的竞争力。
对于整个行业而言,Thinking Machines的案例提醒我们,关注点应从单纯的人事变动转向技术本身的演进逻辑。MoE架构的效率优势、后训练策略的创新、以及开源生态的构建,将成为未来AI竞争的关键要素。随着模型门槛的降低和开发者生态的繁荣,我们有理由相信,AI技术将更加深入地融入社会生活的方方面面,推动生产力水平的整体跃升。
在这一进程中,Thinking Machines或许不再是那个由“OpenAI梦之队”领衔的明星公司,但它通过Inkling系列模型所展现的技术韧性和开放精神,无疑为AI行业的可持续发展提供了宝贵的实践经验。无论创始团队如何变迁,机器向前的车轮,只会越转越快,而开源与协作,将是驱动这一车轮持续前进的核心动力。