AI训练数据困局:为何Anthropic选择销毁百万册纸质书?
在人工智能大模型竞争进入白热化的2026年,数据质量的纯净度已成为决定模型智能上限的核心变量。当互联网上的公开文本逐渐被AI生成的内容所淹没,一种看似倒退却极具工业理性的行为正在科技巨头内部悄然上演:大规模购买纸质书,并通过物理销毁的方式将其转化为数字训练数据。这一现象以Anthropic公司的“巴拿马计划”为典型代表,不仅重塑了图书行业的供应链逻辑,更在法律层面引发了关于“复制”与“转换”的深刻辩论。
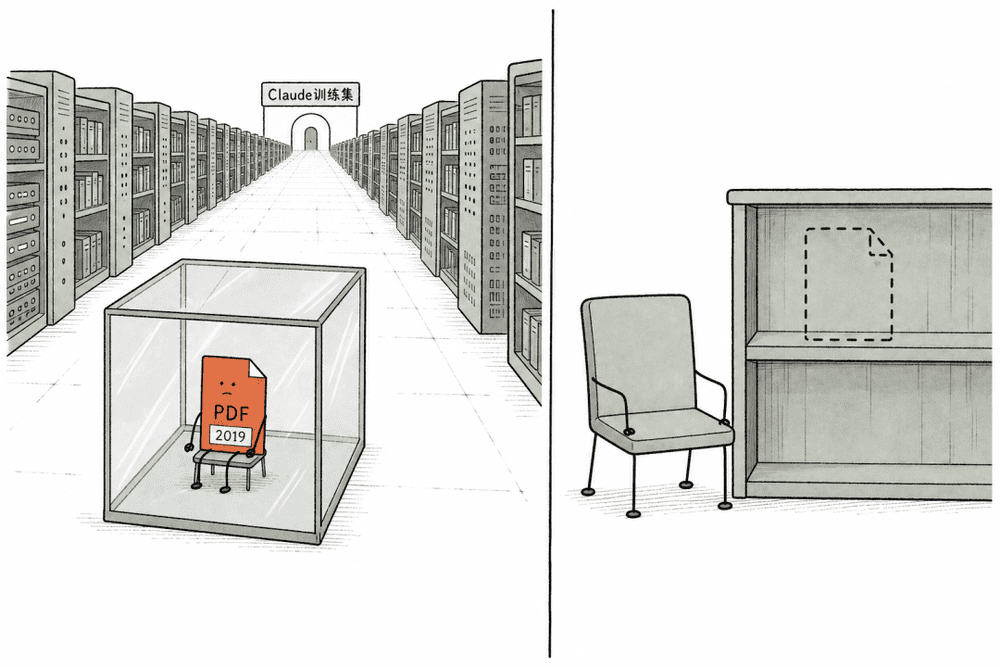
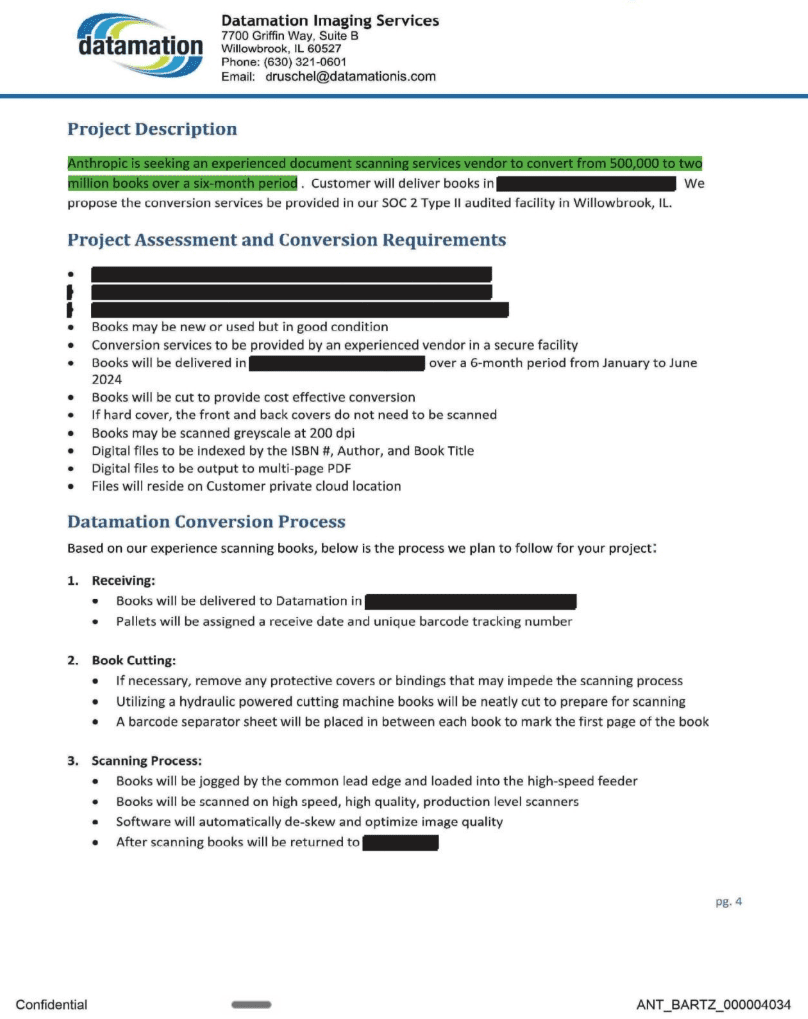
传统认知中,书籍的数字化往往伴随着对原物的尊重与保护。图书馆采用的非接触式扫描技术,利用V型托架和顶部相机逐页拍摄,旨在保留书籍的物理形态以便后续流通。然而,这种温和的方式在面对数百万册级别的训练数据需求时,显得效率低下且成本高昂。书脊处的弯曲、阴影以及人工翻页的时间成本,构成了规模化数据采集的巨大障碍。相比之下,工业级的破坏性扫描提供了一条截然不同的路径:通过液压裁切机直接切除书脊,将书籍分解为独立的散页,随后投入高速馈纸扫描仪进行双面连续扫描。
这种处理方式彻底改变了书籍的属性。在这一流程中,书籍不再首先被视为需要保存的文化载体,而是被还原为阻碍信息高速读取的物理装订结构。对于追求极致吞吐量的AI公司而言,时间与成本的压缩是项目可行性的前提。据披露,Anthropic聘请了曾参与Google Books项目的专家,花费数千万美元购入数百万本二手书,并通过供应商在极短时间内完成拆解与数字化。这种“先死后生”的模式,虽然在情感上令人难以接受,但在工业逻辑上却是实现海量高质量文本获取的最优解。
更为吊诡的是,这种物理上的毁灭行为,在法律层面反而成为了Anthropic的有力护盾。在针对AI公司使用受版权保护作品训练模型的诉讼中,法院并未简单地进行二元判定,而是深入考察了副本的生命周期。法官指出,当一家公司合法购买一本纸质书,并将其扫描为数字文件后,若随即销毁纸质原件,且该数字文件未对外传播或出售,那么在宏观视角下,这并非是从“一”到“二”的非法复制,而是从“纸质副本”到“数字副本”的一对一格式转换。
这一法律认定的核心在于“替代性”的缺失。由于纸质原件已不复存在,市场上并未因该行为而多出一个可供流通的副本,从而避免了对原作者潜在市场的直接侵蚀。与此同时,AI模型对文本的学习被视为具有高度转换性的使用目的,其旨在掌握语言规律与知识结构,而非提供原书的替代品。因此,最具破坏性的销毁环节,意外地满足了合理使用原则中关于“不影响原作品市场价值”的关键要件。与之形成鲜明对比的是,从盗版网站下载的电子书虽然未造成物理损害,却因来源非法且缺乏“一对一转换”的逻辑支撑,无法享受同等的法律保护,最终导致Anthropic不得不支付巨额和解金。
随着这一判例的确立,一条面向AI公司的实体书采购产业链迅速成型。数据服务商开始提供匿名批量采购服务,特别强调2022年之前出版的纸质书因其未经过AI内容污染,被视为更加“干净”的训练素材。绝版书、外文专著以及冷门学术著作的需求量异常激增,书商们发现,这些曾经沉寂在书架角落的书籍,如今正以大宗订单的形式流向未知的目的地。尽管无法确认每一本书的最终命运,但“巴拿马计划”已经验证了一条可复制的商业路径:在数字资源日益混杂的背景下,回归实体世界获取原始数据,成为一种新的战略选择。
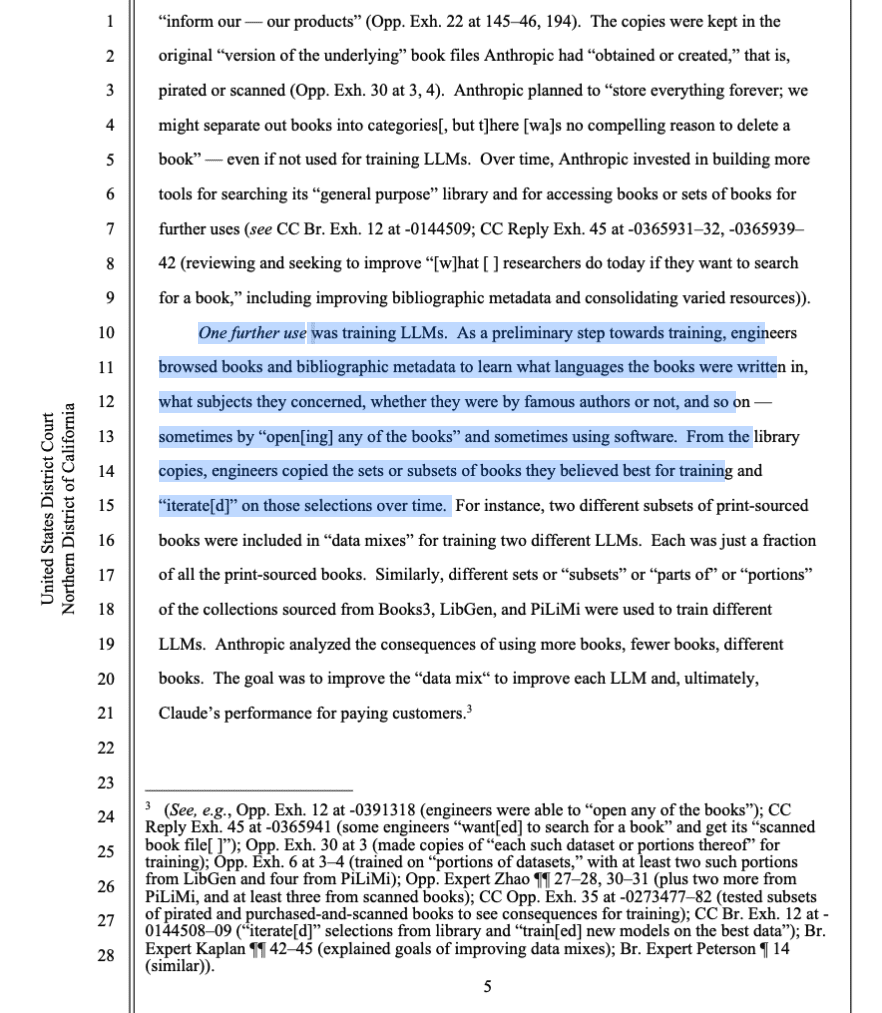
然而,这种模式也引发了关于知识保存伦理的深层忧虑。被扫描后的书籍数据并未全部进入模型训练阶段,而是被存入一个庞大的中央研究资料库中永久保存。这意味着,许多书籍付出了物理生命的代价,却可能从未真正被AI“阅读”或理解,仅仅作为档案被封存在服务器中。对于作者和读者而言,这是一种奇特的交换:文字获得了数字层面的永生,但承载其意义的物理实体却彻底消失。公共书架上那一本具体的书不复存在,取而代之的是企业私有云盘中一段沉默的代码。
从行业发展的角度来看,这种现象反映了AI训练数据获取从“粗放抓取”向“精耕细作”的转变。早期的大模型训练依赖于网络爬取,数据质量参差不齐且版权风险模糊。随着监管力度的加强和数据污染的加剧,拥有清晰版权链条、经过编辑校对的高质量纸质文本,成为了稀缺资源。Anthropic的做法虽然极端,却揭示了未来数据竞争的一个潜在方向:对高质量源头数据的控制权,将直接决定模型的智力水平与合规安全性。
此外,这也对出版业提出了新的挑战与机遇。一方面,二手书市场的价格波动可能影响普通读者的获取成本;另一方面,出版社或许可以探索与AI公司合作的新模式,例如授权特定版本的数字化扫描,或在出版合同中明确包含AI训练数据的授权条款。这不仅能为创作者带来新的收入来源,也能确保数据使用的透明性与合法性。
值得注意的是,尽管破坏性扫描在效率上具有优势,但其对环境的影响也不容忽视。数百万吨纸张的回收处理、化学胶水的分解以及物流过程中的碳排放,都是这一庞大工程背后的隐性成本。在追求算法进化的同时,如何实现绿色计算与可持续的数据获取,将是科技公司必须面对的下一道考题。
综上所述,Anthropic的“巴拿马计划”并非单纯的商业策略,而是技术、法律与伦理交织的复杂产物。它打破了我们对书籍数字化的传统想象,揭示了在AI时代,知识载体的物质性与信息性正在发生剧烈分离。对于从业者而言,理解这一趋势不仅有助于把握数据合规的红线,更能洞察未来内容生态的演变逻辑。在这个由代码重构的世界里,每一本被裁切的书籍,都在无声地诉说着技术进步的代价与辉煌。