国产大模型“性价比”陷阱:高价Token背后的算力困局
在硅谷人工智能领域,GPT-5.6、Fable 5以及Grok 4.5等前沿模型接连亮相,瞬间点燃了全球开发者社区的热情。尽管国内也涌现出如Kimi-K3等具备强劲竞争力的新锐模型,但在一线开发者群体中,国产大模型普遍面临着“叫好不叫座”的尴尬局面。
数据层面的反差极具说服力。根据OpenRouter在2026年6月下旬的数据显示,中国模型周调用量高达20.39万亿Token,远超美国模型的4.25万亿,连续九周领跑全球。然而,与国内庞大的调用量形成鲜明对比的是头部企业的财务表现。智谱2025年营收约7.24亿元,却背负超30亿元亏损;MiniMax营收约5.7亿元,同样面临巨额亏损。相比之下,Anthropic的年经常性收入(ARR)已突破600亿至700亿美元大关,主要得益于B2B API及AI编程场景的强劲驱动。
这种反差引出了一个核心命题:为何在Token调用量巨大的情况下,国产大模型难以在高价值的AI Coding场景中与国外顶尖产品抗衡?经过对多位一线开发者的深入调研,一个反直觉的事实逐渐浮出水面:在某些高强度应用场景下,国产大模型实际上并不便宜,甚至显得过于昂贵。
低价幻觉:Token单价背后的成本错位
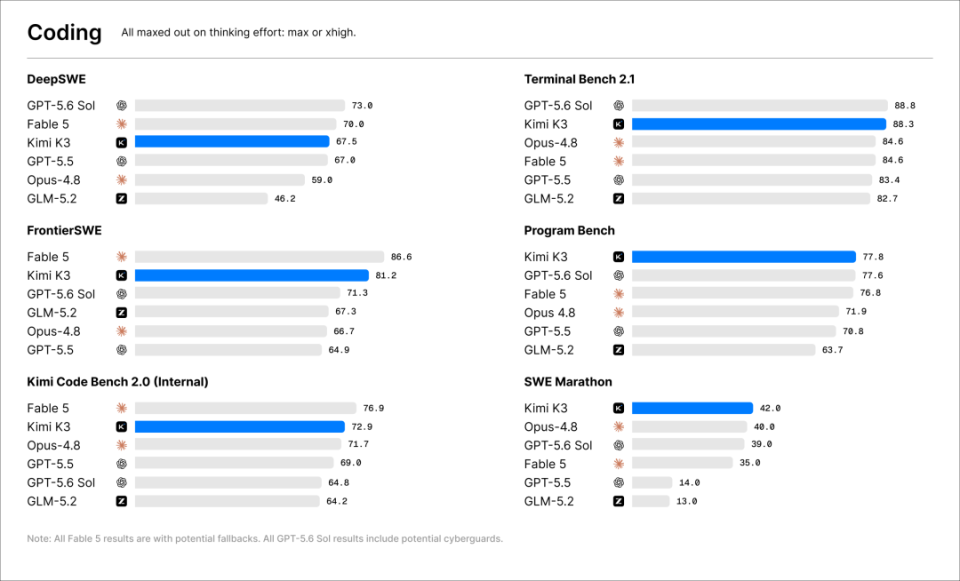
提及国产大模型,市场普遍贴上的标签是“低价”和“便宜”。仅从公开的API单价来看,GLM-5.2每百万Token输入/输出为1.4/4.4美元,DeepSeek-V4-Pro为0.435/0.87美元,相较于GPT-5.6 Sol(5/30美元)或Claude Fable 5(10/50美元),优势确实明显。然而,这种基于单次的比价逻辑,忽略了高强度编程场景下的边际成本效应。
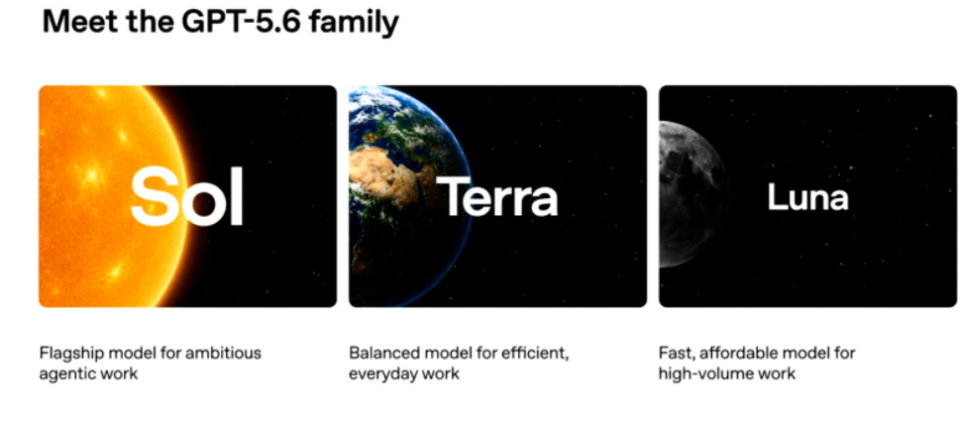
以AI科研工作者李光为例,其日均Token消耗量接近40亿。若使用GLM-5.2模型,即便利用缓存输入降低成本,单次计算的成本仍高达约1084美元(约合人民币7800元)。这一数字在持续性的开发工作中是不可承受的负担。相反,若采用OpenAI的Codex套餐,用户只需支付每月20美元(Plus)至200美元(Pro/Max)的固定费用,即可在额度内无限调用。对于周消耗300元人民币的小刘而言,这种包月模式极大地摊薄了单Token成本。
关键在于,Codex等套餐并非简单的“无限量”,而是通过设定高额度的阈值(如Pro档约20亿Token/周),将算力成本转化为固定的订阅收入。只要用户调用量未触及阈值,厂商即可利用算力余量覆盖固定成本。而国产模型缺乏类似的规模化套餐兜底,导致重度用户面临的是线性的、高昂的边际成本。
定价之痛:算力瓶颈下的“伪自助餐”
国产大模型在定价策略上陷入了一个尴尬的境地:看似提供自助餐式的套餐服务,实则按斤计费且限量供应。
国内主流模型如Kimi和GLM-5.2虽推出了编程专属套餐,但限制极多。Kimi Code分为四档,额度每周刷新;GLM-5.2的Coding Plan则严格限制每次Prompt的次数,且在高峰期需按3倍额度扣除。更为糟糕的是,由于算力资源的紧张,部分厂商不得不采取“饥饿营销”式的销售策略。智谱曾在2026年1月发布公告,因算力紧张将每日可售量砍至原来的20%,热门套餐需拼手速抢购,几分钟内售罄。
以阿里云Qoder为例,其企业版199元套餐包含3000 Credits。据运维工程师测试,重度开发者在3天内即可耗尽额度,若按极限用法,一天即可用完。这种“限量”体验直接导致至少二三十家企业客户选择放弃续费。
造成这一局面的根本原因在于算力的结构性短缺。2025年数据显示,中国数据中心数量为449个,美国为5427个;总算力方面,中国为1053 EFLOPS,美国为2400 EFLOPS。更重要的是,美国算力中高性能GPU占比极高,而中国算力中大量依赖华为昇腾、寒武纪等国产芯片,单卡性能与NVIDIA H100仍存在代差。
此外,大模型推理与云计算存在本质区别。传统云服务器(ECS)允许超卖,一台物理机的CPU利用率往往仅在10%左右,厂商可通过共享资源获利。但大模型推理是刚性需求,每生成一个Token均需消耗实打实的GPU算力和HBM显存,无法超卖。一旦用户24小时不间断调用,厂商的硬件、电费成本即为刚性支出。在算力成本高昂且亏损严重的背景下,国产厂商不敢轻易推出真正的“不限量”套餐,以免被高频用户击穿成本线。
黄金三角:性能、价格与稳定性的失衡
除了价格因素,性能与稳定性也是决定用户留存的关键。在开发者眼中,模型选择已演变为“性能—价格—稳定性”的黄金三角平衡。
在性能维度,GLM-5.2被视为首批达到Opus级别的国产模型,能够承接复杂的异步任务。然而,在长程代码生成、多轮调试等复杂场景中,其表现仍逊于GPT和Claude。例如,在某多级内容比对项目中,仅GPT模型成功完成且符合预期,而国产模型则出现逻辑断裂或格式错误。
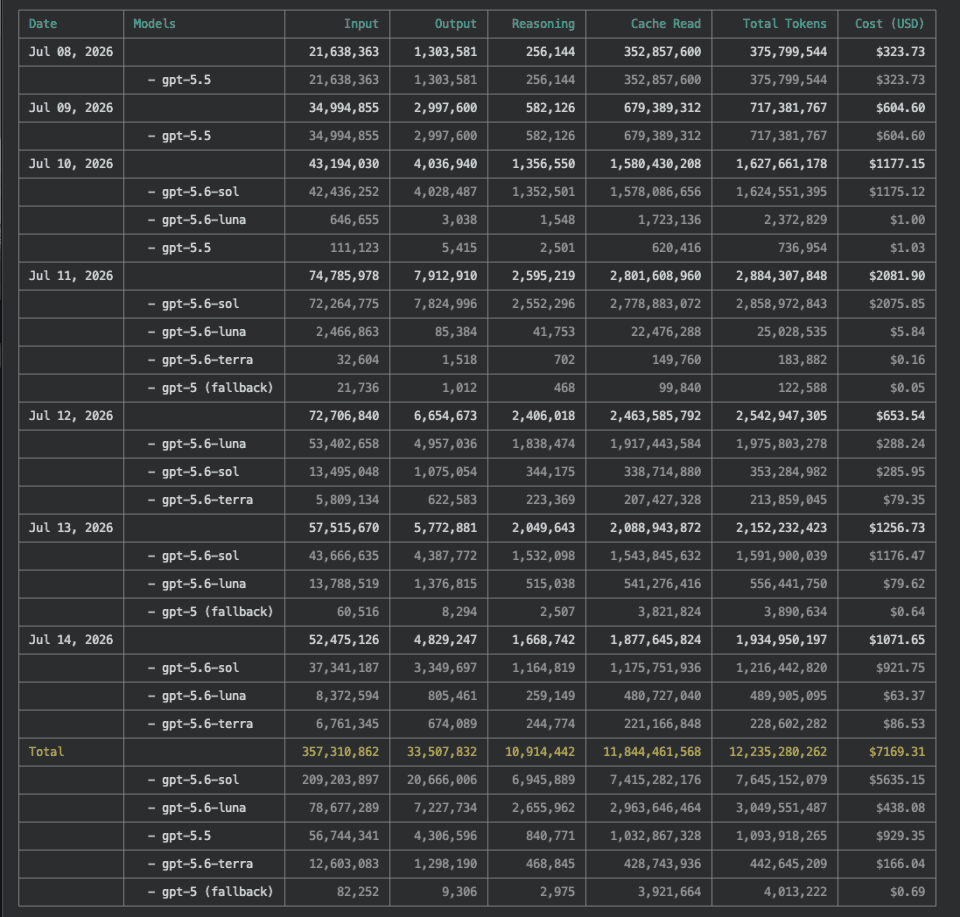
在稳定性维度,国产模型的问题尤为突出。缓存效率低、高峰期限流、API断连等现象频发。Kimi发布的K3模型虽在基准测试中位列全球第三,编程榜得分登顶,但用户反馈其API频繁断连,且套餐额度迅速耗尽。尽管K3的API价格低于GPT-5.6 Sol,但其实际使用体验因不稳定而大打折扣。
相比之下,Anthropic和OpenAI的成功在于其构建了高质量的商业闭环。Cursor、GitHub Copilot等客户每年为Anthropic贡献14亿美元收入,这些高净值企业客户不仅带来稳定收入,还提升了模型的迭代速度和服务质量,形成了正向反馈。
结语与展望
国产大模型在技术追赶的道路上取得了显著进展,但在商业化落地层面,仍受制于算力基座的短板。当前的“高价”并非源于品牌溢价,而是算力成本高昂、缺乏规模效应以及稳定性不足的综合结果。
未来,国产大模型要想真正赢得开发者市场,不能仅依赖单一的技术参数突破,而需在“技术、价格、稳定性”三个维度上形成合力。这要求厂商在算力投入上持续加码,优化推理效率,并设计出符合开发者习惯的、具备真正性价比的订阅模式。唯有当算力瓶颈被突破,边际成本显著下降时,国产大模型才能从“叫好不叫座”走向真正的商业化成功,撑起用户的续费预期与市场信任。
这一过程需要耐心,也需要产业链上下游的协同努力。在等待算力大规模量产和成本优化的窗口期,如何在现有约束下优化用户体验,将是国产模型厂商面临的最大挑战。