Claude Code token消耗高达30倍?揭秘Agent框架对成本的致命影响
算清“Harness税”:Agent框架的成本黑洞
在人工智能应用落地的最后一公里,开发者们往往陷入一种“唯模型论”的迷思:认为只要选择了最顶级的基座模型,就能获得最优的Agent表现。然而,近期一组来自Composio团队的对比实验数据,给这种观念泼了一盆冷水。实验结果显示,在完全相同的任务场景下,不同Agent框架(Harness)之间的Token消耗差距最高可达30倍。
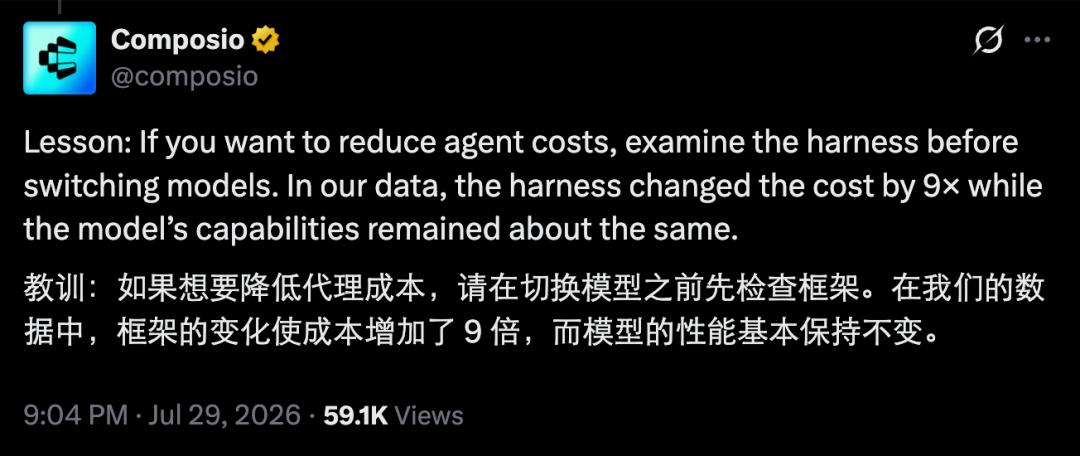
这一发现不仅挑战了我们对模型成本的认知,更揭示了一个被长期忽视的工程变量:框架层的设计直接决定了应用的经济可行性。当模型能力逐渐趋同,成为像水电煤一样的基础设施时,如何高效地“用电”,即如何优化框架层的逻辑,将成为竞争下半场的关键胜负手。
实验复盘:成功率相近,成本天壤之别
Composio团队设计的实验具有极高的控制变量意识。他们选取了Kimi K3这一特定模型,将其分别接入三个主流的Agent框架:Claude Code、Hermes以及Kimi Code。为了排除任务难度差异带来的干扰,团队精心挑选了28个完全相同的编程与推理任务进行全量测试。
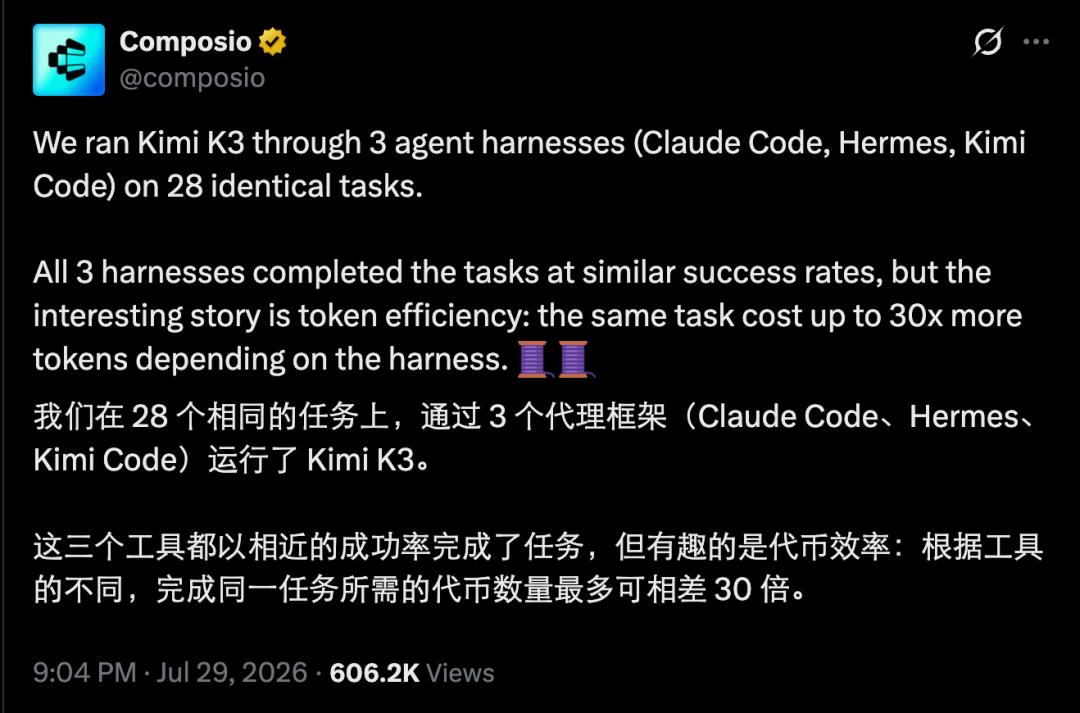
从任务完成的绝对成功率来看,三者差距微小:Kimi Code成功22项,Hermes成功21项,Claude Code成功20项。这一数据表明,在模型基础能力一定的情况下,框架并未显著削弱其解决问题的成功率。然而,一旦将视线转向资源消耗维度,惊人的差异便显现出来。
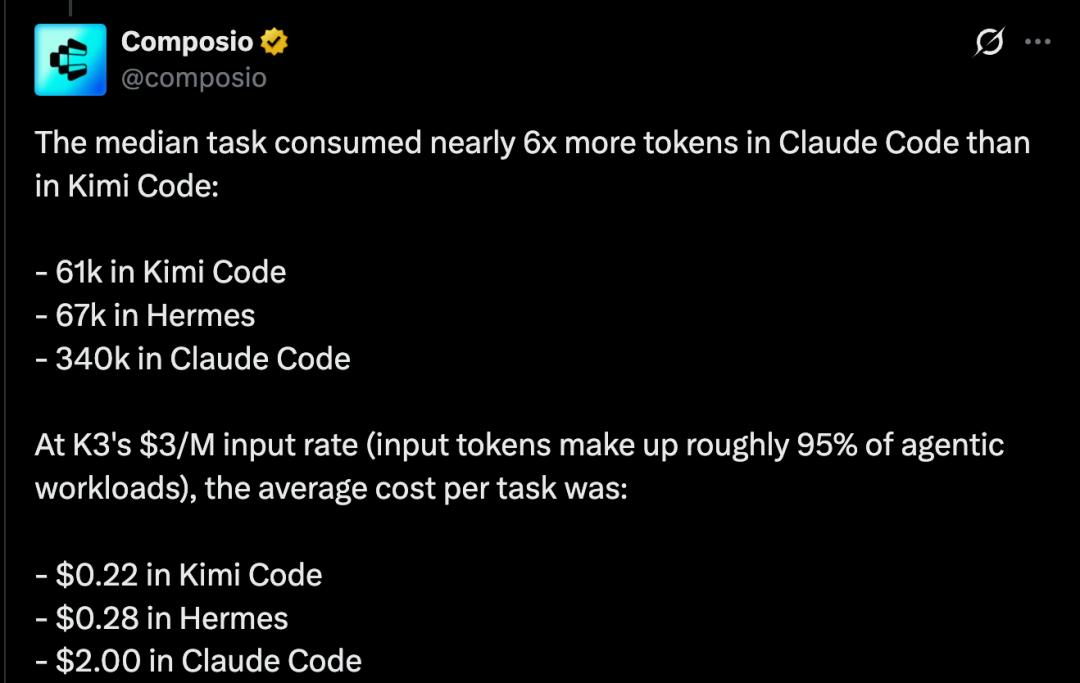
在中位数统计下,Kimi Code的平均Token消耗约为6.1万个,Hermes为6.7万个,而Claude Code则飙升至34万个。这意味着,处理同样的任务,Claude Code的Token用量是Kimi Code的近6倍。若按Kimi K3每百万输入Token 3美元的计费标准,并假设输入Token占总消耗的95%,单个任务的平均成本分别为:Kimi Code约0.22美元,Hermes约0.28美元,而Claude Code则高达2美元。
成本并非唯一痛点,速度同样受到框架逻辑的深刻影响。中位数耗时数据显示,Hermes最快,仅需179秒;Kimi Code为297秒;Claude Code最慢,达到348秒。这一结果打破了“最省钱即最快”的线性假设,表明框架优化是一个涉及多维度的系统工程。
深度解析:为何Claude Code如此“贪婪”?
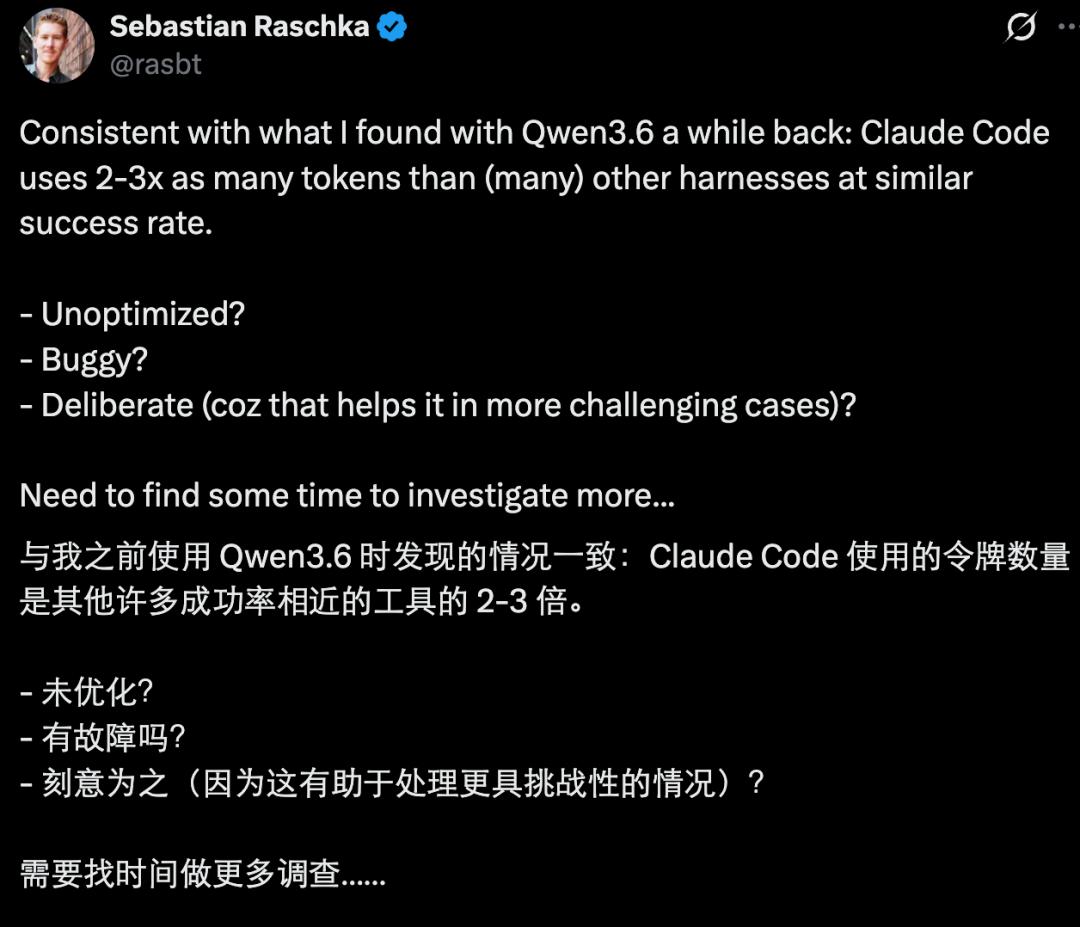
面对Claude Code极高的Token消耗,业界专家Sebastian Raschka提出了深刻质疑。他指出,这并非模型智能不足,而是框架在上下文管理上的低效。通过深入分析日志数据,他发现差异主要集中在输入Token端,而非输出内容。
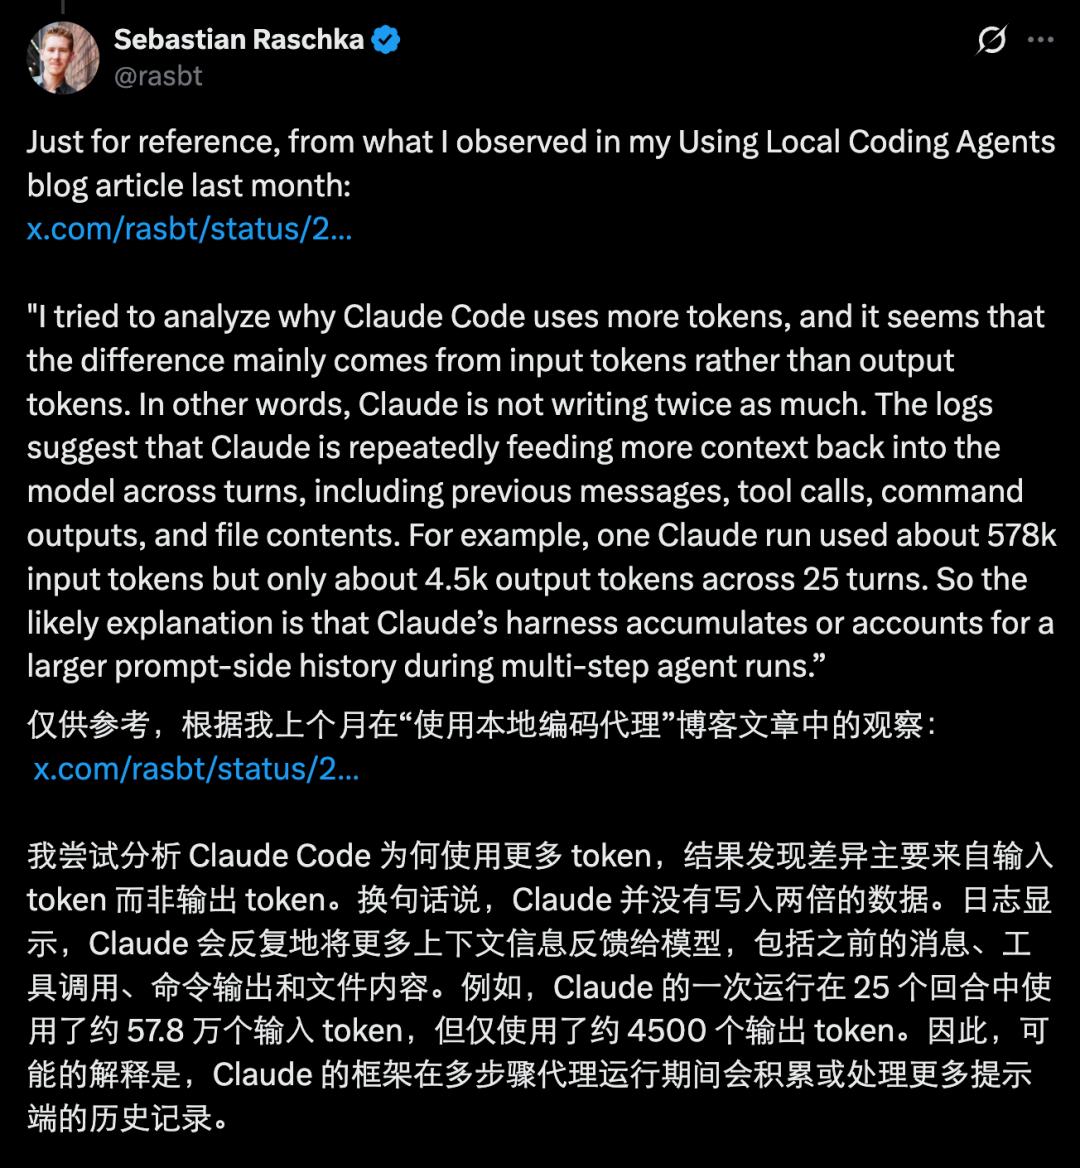
具体而言,Claude Code的Harness在多轮交互中,倾向于将更多的历史上下文、工具调用结果、终端命令输出甚至文件内容反复塞回Prompt中。在某次典型任务中,模型输出了仅4500个Token,但输入却高达57.8万个,跨越了25轮交互。这种“上下文累积”策略虽然旨在维持长期记忆,但在实际操作中往往引入了大量冗余噪声,导致模型在处理冗余信息时消耗了不成比例的算力。
相比之下,更优秀的Harness应当具备“上下文压缩”或“关键信息提取”能力,仅在必要时将最核心的状态信息传递给模型,从而大幅削减输入Token的体积。这种设计上的优劣,直接拉开了成本的天壤之别。
Writer实验:控制变量下的框架价值重估
为了进一步验证框架层的影响力,Writer公司发表了一项更为系统的企业级实验。该研究在22个企业任务和6个基础模型(包括Claude Sonnet 4.6、Gemini 3.1等)的固定条件下,仅替换编排层,将传统生产级智能体循环替换为Writer自家的Harness。
实验数据极具说服力:替换框架后,平均任务成本降低41%,中位延迟缩短44%,Token消耗量减少38%。更为关键的是,任务完成质量不仅没有下降,反而从0.78提升至0.81。这一结果证明,优化框架不仅可以省钱,还能提速,且不牺牲效果。
在性价比维度,每美元所能获得的质量提升高达82%,每百万Token能完成的任务数从54.9跃升至92.0。这一数据有力地支撑了“框架即产品”的论点:在模型能力过剩的今天,框架的工程效率已成为决定AI应用商业可行性的核心要素。
“框架即产品”:AI开发范式的转变
随着大模型API成本的透明化和标准化,AI开发的竞争重心正从“模型层”向“框架层”转移。过去,我们关注模型参数量、多模态能力或推理极限;现在,我们必须关注Prompt的构建效率、状态管理的精简度以及工具调用的逻辑闭环。
这种转变要求开发者重新审视Agent架构。简单的“循环调用”已无法满足高效能需求,取而代之的是基于状态压缩、上下文筛选和错误恢复机制的精密编排。正如Writer实验所示,即使使用相同的顶级模型,不同的框架也能带来截然不同的用户体验和成本结构。
未来展望:Benchmark中的“框架税”
鉴于框架对成本的巨大影响,行业有必要在现有的AI Benchmark体系中引入“Harness税”这一评估维度。传统的基准测试往往只关注准确率或延迟,却忽略了资源消耗的边际效应。特别是在涉及复杂工具调用和重试机制的场景下,框架设计的微小缺陷可能导致Token消耗呈指数级增长。
未来的Agent竞赛,上半场比拼的是“能不能做”,即模型的智力边界;下半场比拼的将是“做得多省”,即工程效率的极致优化。开发者需要从单纯的模型调用者,转变为框架架构的设计者。
对于企业而言,这意味着需要建立一套严格的框架评估体系,不仅测试模型能力,更要测试其在各种边缘场景下的Token消耗效率。对于开源社区而言,优化框架逻辑、分享低Token消耗的Prompt模板和状态管理策略,将成为新的价值高地。
结语
AI应用的落地不再仅仅是算法的胜利,更是工程学的较量。Claude Code与Kimi Code、Hermes之间的巨大成本差异,警示我们不要忽视框架层的优化潜力。在模型同质化趋势日益明显的未来,谁能更高效地管理上下文、精简交互逻辑,谁就能在成本与效率的钢丝上走得更远。
这一趋势提醒所有AI从业者:不要只盯着模型的Logo,更要看清背后的框架逻辑。毕竟,决定你账单厚度的,往往不是那颗昂贵的芯片,而是你如何聪明地使用它。