Agent成本差30倍?揭秘Claude Code的Token黑洞与Harness优化真相
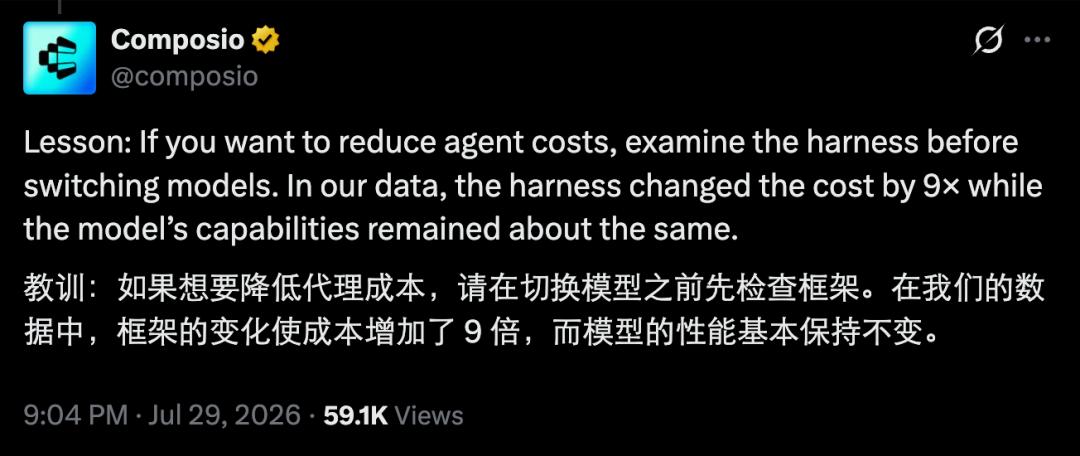
被忽视的成本黑洞:当模型能力趋同,框架决定生死
在生成式人工智能迅速渗透至软件开发与企业工作流的当下,行业焦点长期锁定在基础模型的参数规模、推理能力以及基准测试分数上。然而,随着应用层开发的深入,一个更为隐蔽且致命的成本因素逐渐浮出水面:智能体编排框架,即业界所称的“Harness”。近期,来自Composio团队的一项严谨对比实验揭示了这一现象的严峻性。该实验选取了同一款基础模型Kimi K3,将其分别嵌入Claude Code、Hermes以及Kimi Code三个不同的Agent框架中,执行完全相同的28个标准化任务。
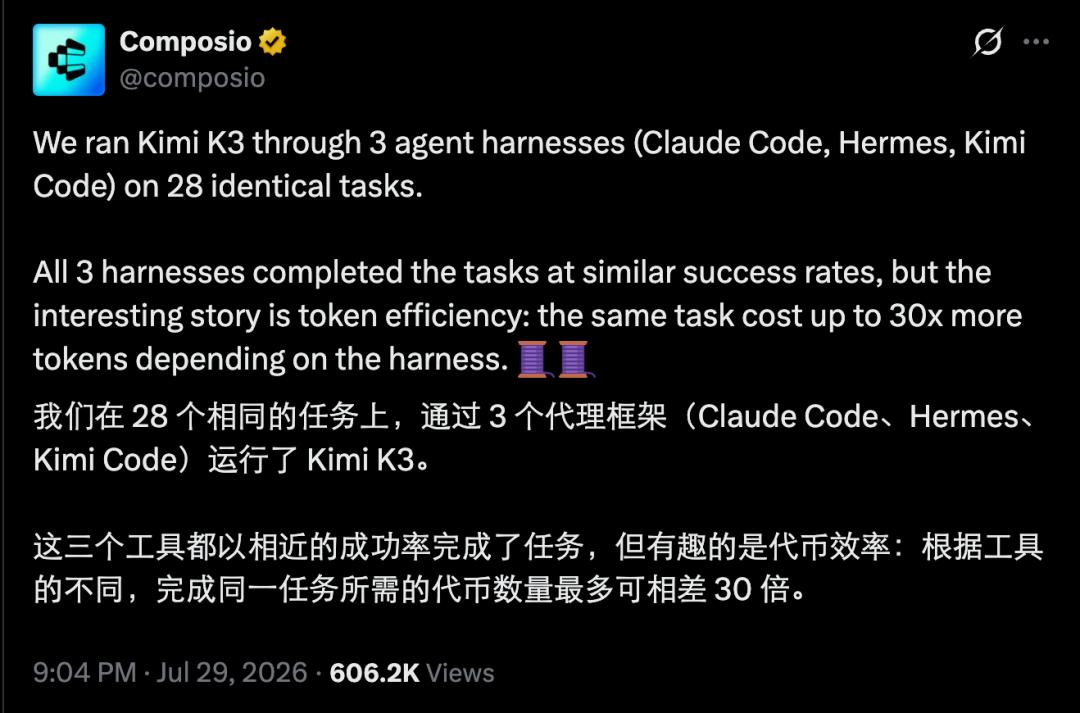
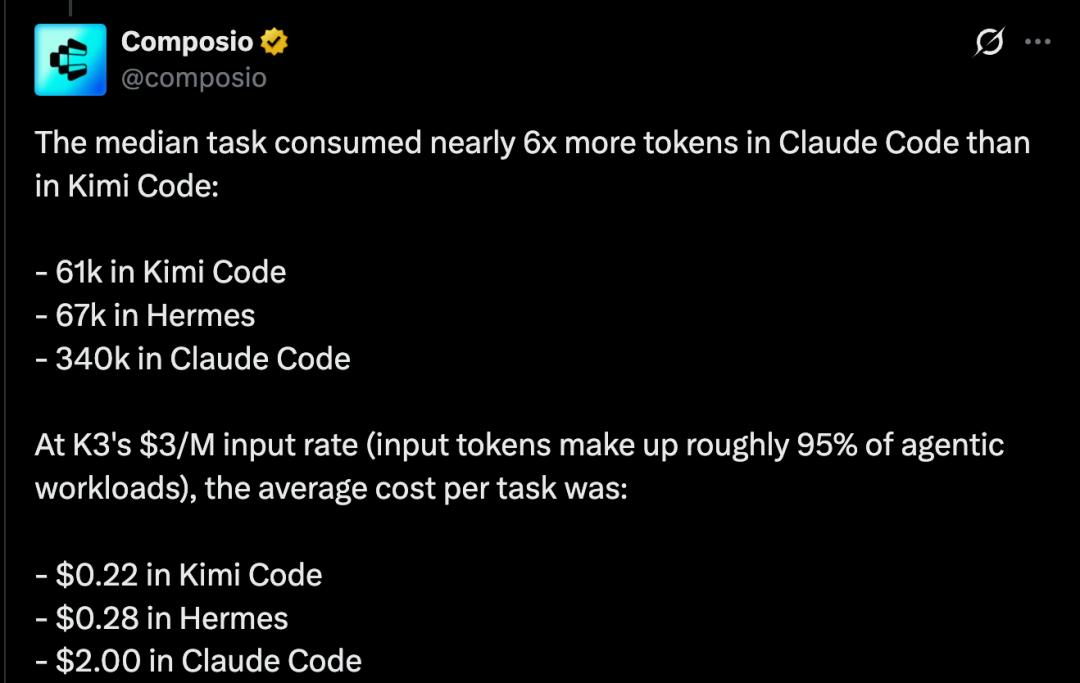
实验结果令人震惊。尽管三个框架在任务成功率上表现相近——Kimi Code成功22次,Hermes成功21次,Claude Code成功20次——但在资源消耗层面却呈现出巨大的鸿沟。数据显示,完成同等任务所需的Token数量,不同框架之间最多相差30倍。从中位数来看,Kimi Code平均消耗约6.1万Token,Hermes约为6.7万Token,而Claude Code则飙升至34万Token,是前者的近6倍。若以Kimi K3每百万输入Token 3美元的定价计算,单个任务的平均成本从Kimi Code的0.22美元激增至Claude Code的2美元。这一数据差异不仅关乎财务预算,更直接指向了系统架构设计的合理性问题。
深度解析:为何Claude Code成为“Token吞噬者”
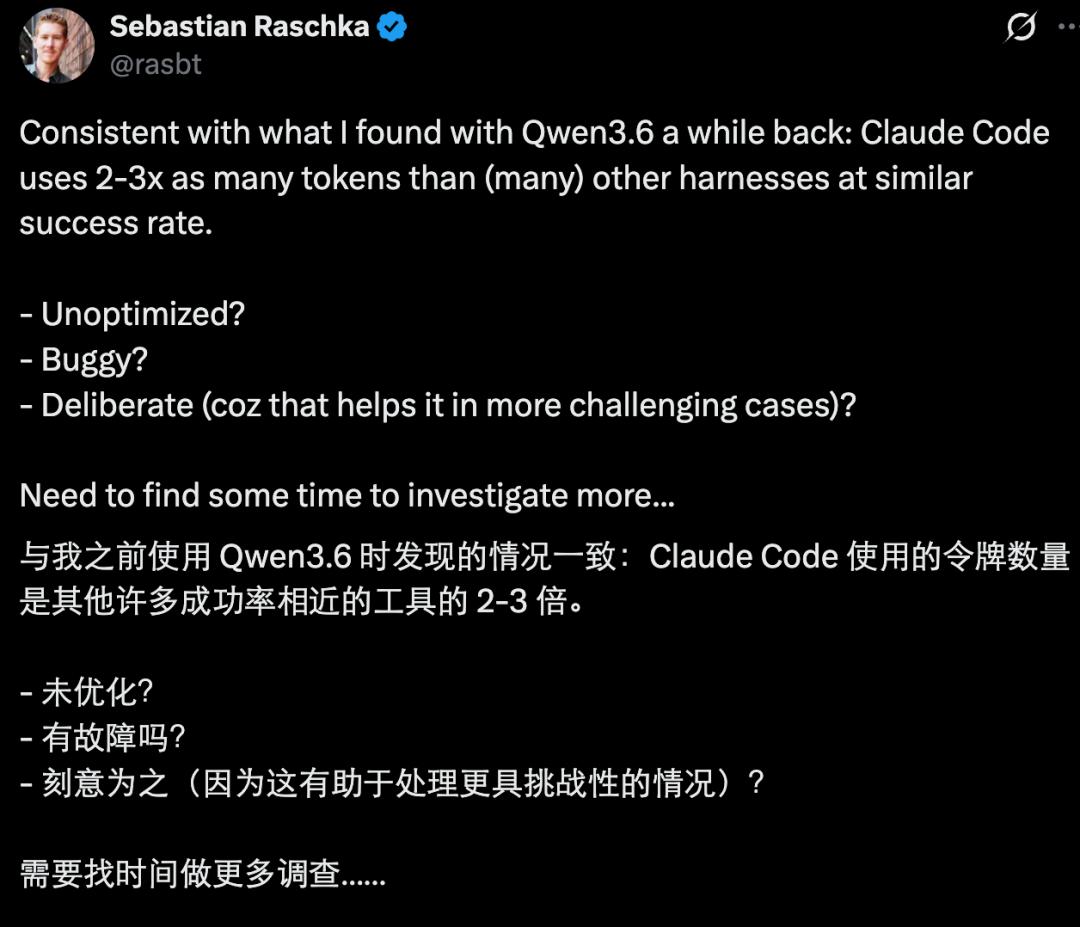
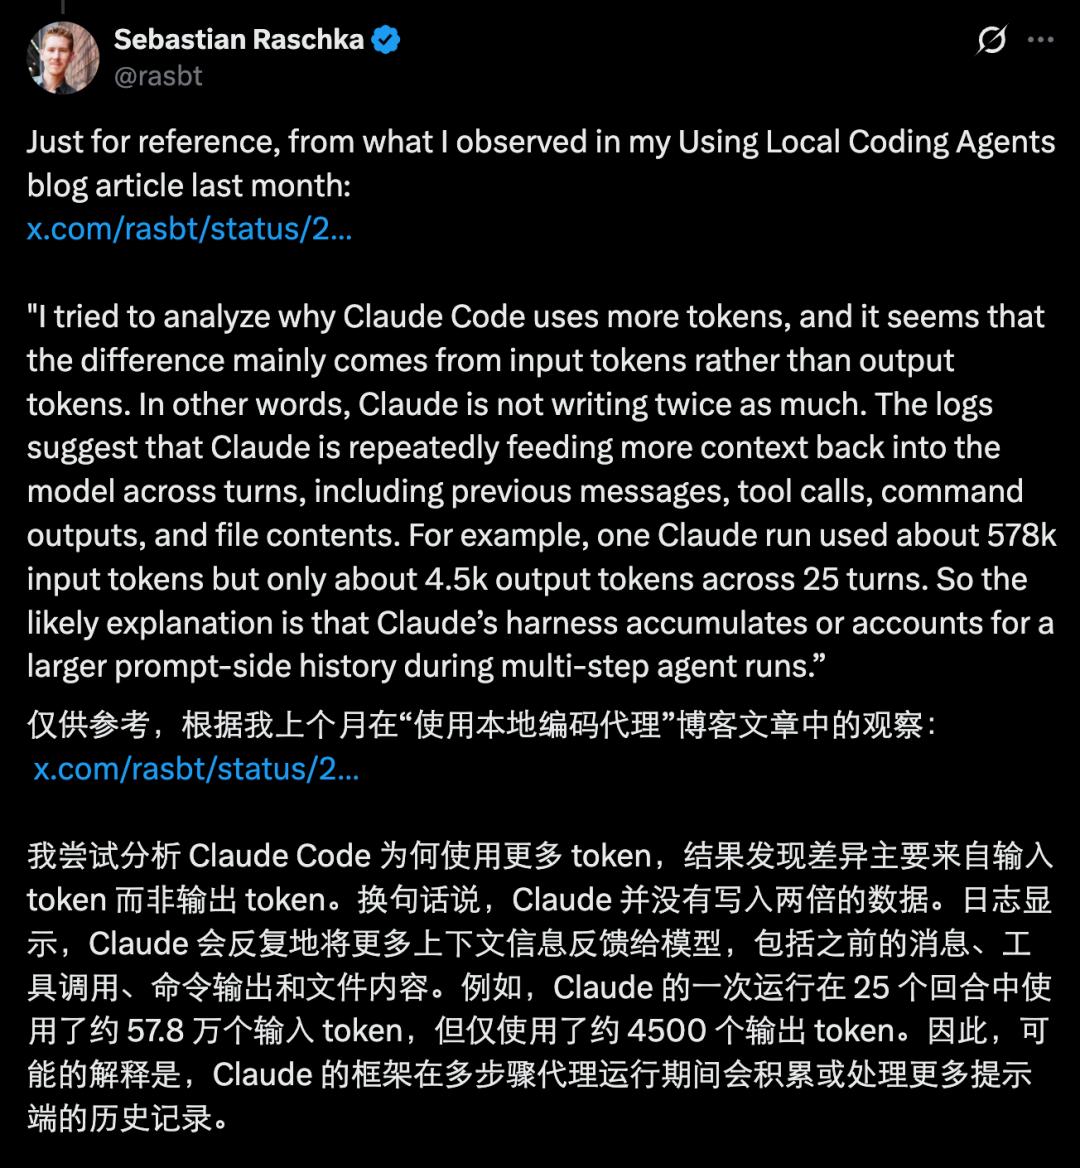
面对如此悬殊的成本差异,探究其背后的技术成因至关重要。知名AI研究者Sebastian Raschka对此现象进行了深入追踪,他指出Claude Code的高消耗并非源于模型输出了更多的内容,而是集中在输入端。日志分析显示,在一次典型的运行中,Claude Code可能产生57.8万的输入Token,但输出Token仅为4500左右,且跨越了25轮交互。这种极端的输入输出比表明,问题核心在于上下文管理的策略。
具体而言,Claude Code的Harness在多轮代理运行过程中,倾向于将大量的历史消息、工具调用记录、命令输出以及文件内容反复塞回模型的提示词窗口。这种“全量回溯”或“过度包含”的策略,虽然可能在某些复杂逻辑推理中提供额外的上下文支撑,确保模型不丢失关键信息,但其代价是指数级增长的输入成本。相比之下,Kimi Code和Hermes可能采用了更高效的上下文修剪、摘要压缩或选择性记忆机制,仅保留对当前步骤至关重要的信息,从而大幅降低了无效Token的传输与处理。
此外,速度维度的差异也佐证了这一观点。Hermes以179秒的中位数耗时位居第一,Kimi Code为297秒,而Claude Code则需348秒。更快的响应速度通常意味着更少的网络往返和更精简的数据处理流程。因此,最快与最省并未重合于同一框架,这提示开发者在选型时需根据业务场景权衡:是追求极致的低成本,还是特定的交互体验,亦或是两者之间的平衡点。
Harness即产品:编排层的技术红利远超模型迭代
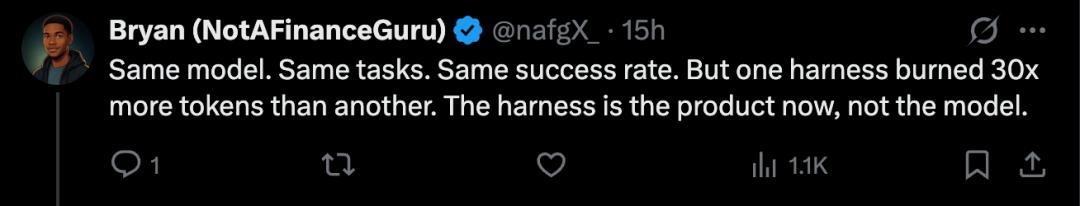
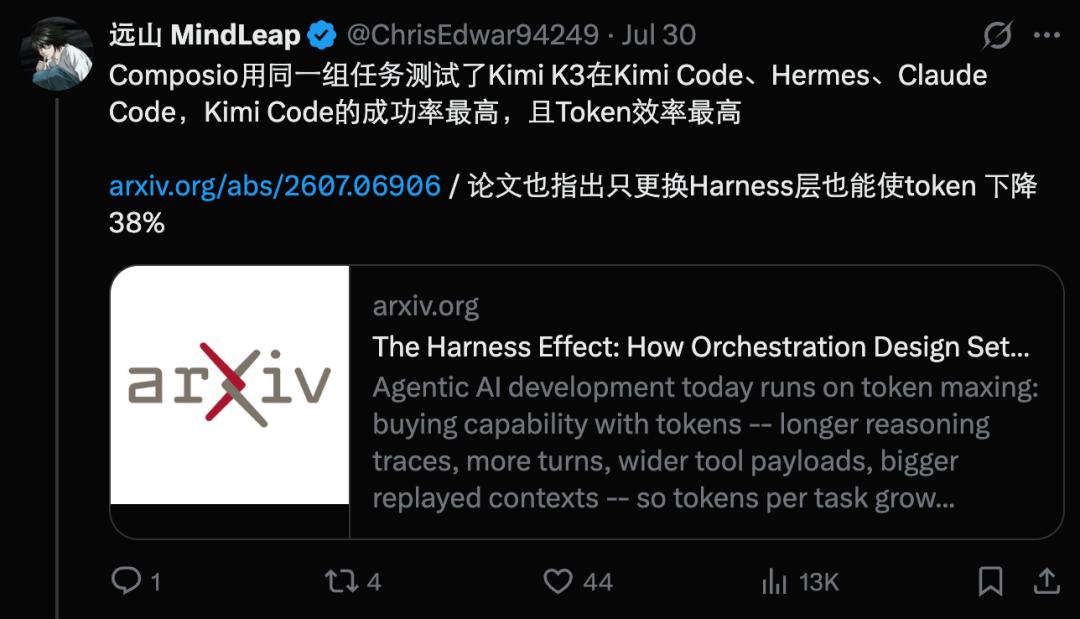
Composio的实验结论指向了一个行业范式的转变:在模型能力日益同质化的今天,Harness的重要性已不亚于模型本身。这一观点在Writer公司发布的最新研究中得到了进一步印证。Writer进行了一项严格的控制变量实验,固定使用包括Claude Sonnet 4.6、Gemini 3.1、Qwen 3.6在内的六款主流基础模型,仅替换底层的编排层,将传统生产级智能体循环替换为Writer自家的Harness。
实验数据极具说服力:在任务完成质量基本持平的前提下(评分从0.78微升至0.81),引入优化后的Harness使每项任务的平均成本降低了41%,从0.21美元降至0.12美元;中位延迟缩短了44%,从48秒减少至27秒;Token消耗量减少了38%。更为关键的是,性价比指标发生了质的飞跃,每美元成本所能获得的质量提升了82%,每百万Token能完成的任务数从54.9跃升至92.0。这意味着,通过优化软件架构和编排逻辑,企业可以在不更换更昂贵模型的情况下,实现近乎翻倍的业务处理能力。
这一发现颠覆了以往“模型即产品”的认知。过去,开发者认为提升性能的唯一路径是升级到参数量更大、价格更高的模型。现在,证据表明,“Harness即产品”才是下一阶段竞争的核心。优秀的编排层能够像高效的空调系统一样,精准调控模型这一“水电煤”资源的消耗,避免不必要的浪费。它通过智能的路由选择、动态的上下文管理、并行的工具调用以及错误的自愈机制,最大化地挖掘了基础模型的潜力。
“Harness税”:未来Agent竞赛的新标尺
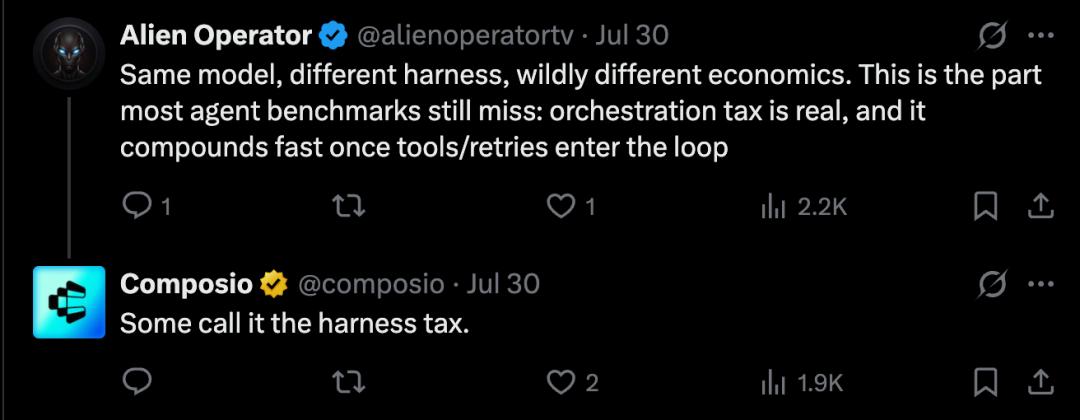
随着Agent应用从概念验证走向大规模生产部署,我们需要重新定义评估标准。传统的Benchmark主要关注准确率、召回率等模型性能指标,却很少考量系统层面的效率损耗。鉴于工具调用失败后的重试机制、多轮对话中的上下文累积效应,这笔隐形的“Harness税”并非线性增长,而在复杂任务中呈现指数级膨胀风险。
因此,行业亟需在现有的评估体系中纳入“效率维度”。未来的Agent竞赛,上半场比拼的是“能不能做”,即模型是否具备解决特定领域问题的能力;而下半场比拼的将是“做同样的事,谁更省”,即在保证成功率的前提下,谁能以更低的Token消耗、更短的延迟完成闭环。省钱的秘密不再仅仅藏在模型的权重里,更藏在代码的编排逻辑中。
对于开发者而言,这意味着需要建立更精细的成本监控体系。在开发初期,就应将Token消耗作为核心KPI之一,对不同框架的默认行为进行压力测试。例如,检查框架是否在每次工具调用后都完整返回了所有文件内容,是否对历史对话进行了有效的截断或摘要,以及重试机制是否设置了合理的上限。同时,社区也应推动开源框架的透明化,鼓励开发者分享各自在上下文优化方面的最佳实践,共同降低整个生态的“摩擦成本”。
构建高效Agent系统的实战策略
基于上述分析,企业在构建自有Agent系统时,应采取以下策略以规避高额的“Harness税”。首先,实施上下文的动态管理。不要盲目地将所有历史对话传入模型,而应根据任务类型设计上下文窗口策略。对于长文档处理,采用检索增强生成(RAG)技术,仅提取相关片段;对于多轮对话,定期生成对话摘要,替代原始消息列表。
其次,优化工具调用的粒度与反馈。避免让模型接收冗长的原始命令行输出或API返回数据,应在中间层对数据进行清洗、格式化甚至初步分析,只将关键结果传递给模型。这不仅能减少输入Token,还能降低模型解析噪声的难度,提高决策准确性。
最后,建立多层级的评估机制。除了功能测试,必须引入成本与延迟的压力测试。模拟真实用户的高频交互场景,监测在不同负载下Token消耗的变化曲线。如果发现某类任务的成本异常偏高,应深入日志分析,定位是框架的重试逻辑过于激进,还是上下文累积失控,进而针对性地调整配置或切换更轻量级的Harness组件。
综上所述,AI Agent的开发已进入精细化运营时代。模型提供了智能的基石,而Harness决定了智能落地的效率与经济性。唯有正视并优化这一环节,才能在激烈的市场竞争中,打造出既聪明又经济的高效智能体。