Claude Code Token消耗惊人:三大框架对比揭示30倍成本差异真相
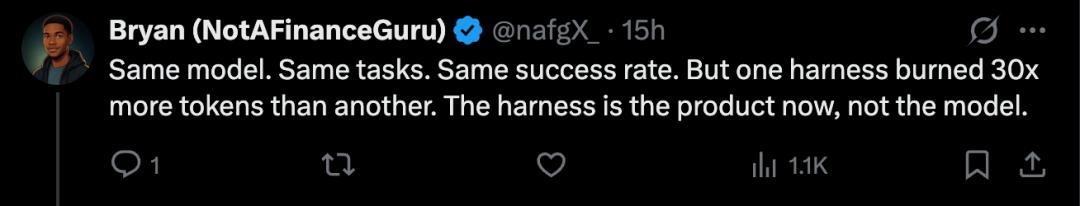
在人工智能应用落地的深水区,开发者们逐渐意识到,模型能力的边际效应正在递减,而工程实现的细节却可能成为决定成败的关键变量。近期,一场关于AI Agent框架效率的对比实验引发了业界的广泛关注。Composio团队通过严谨的控制变量测试,揭示了不同编排框架(Harness)在Token消耗上的巨大差异,其中Claude Code的表现尤为引人深思。这项研究不仅量化了“框架税”的具体数值,更重新定义了AI应用开发中的成本结构逻辑。

实验设计与核心数据:效率鸿沟远超预期
为了探究不同Agent框架的真实效率,Composio团队设计了一项高度标准化的对比实验。实验选取了同一基础模型Kimi K3,分别接入三个主流的Agent框架:Claude Code、Hermes以及Kimi Code。测试集包含28个完全相同的编程与任务处理场景,以确保变量控制的严格性。
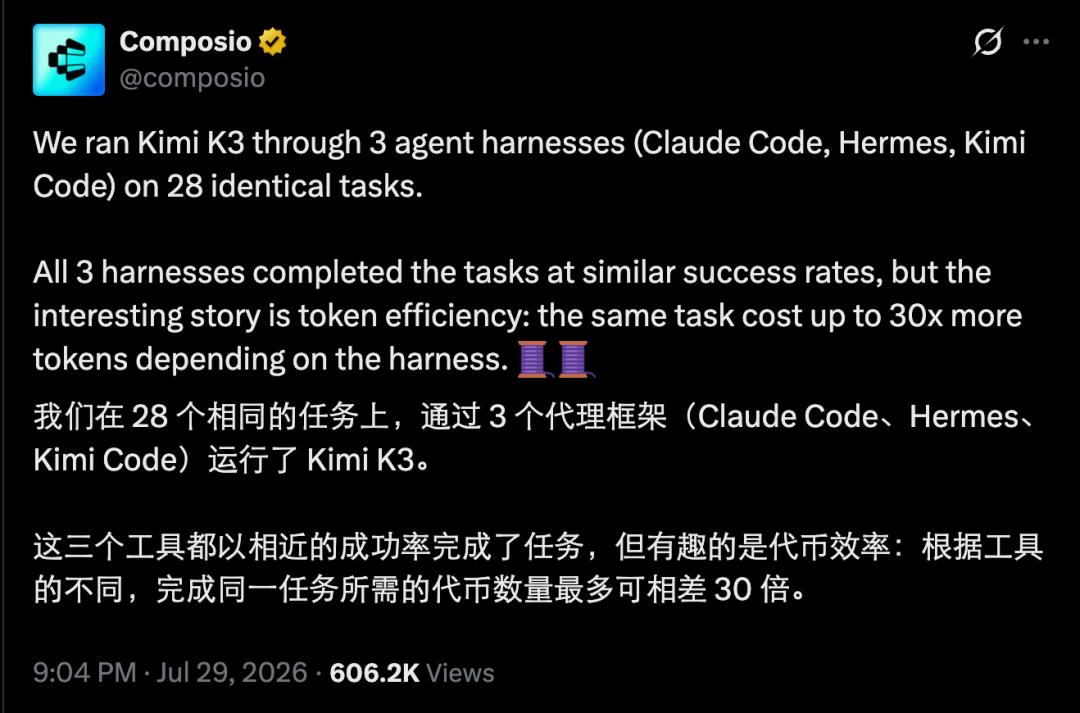
从任务完成度来看,三个框架的表现处于同一梯队。Kimi Code成功完成了22个任务,Hermes为21个,Claude Code为20个。这种微小的成功率差异表明,在基础能力层面,这些框架并未出现明显的性能断层。然而,一旦将视角转向资源消耗,巨大的鸿沟便显露无遗。
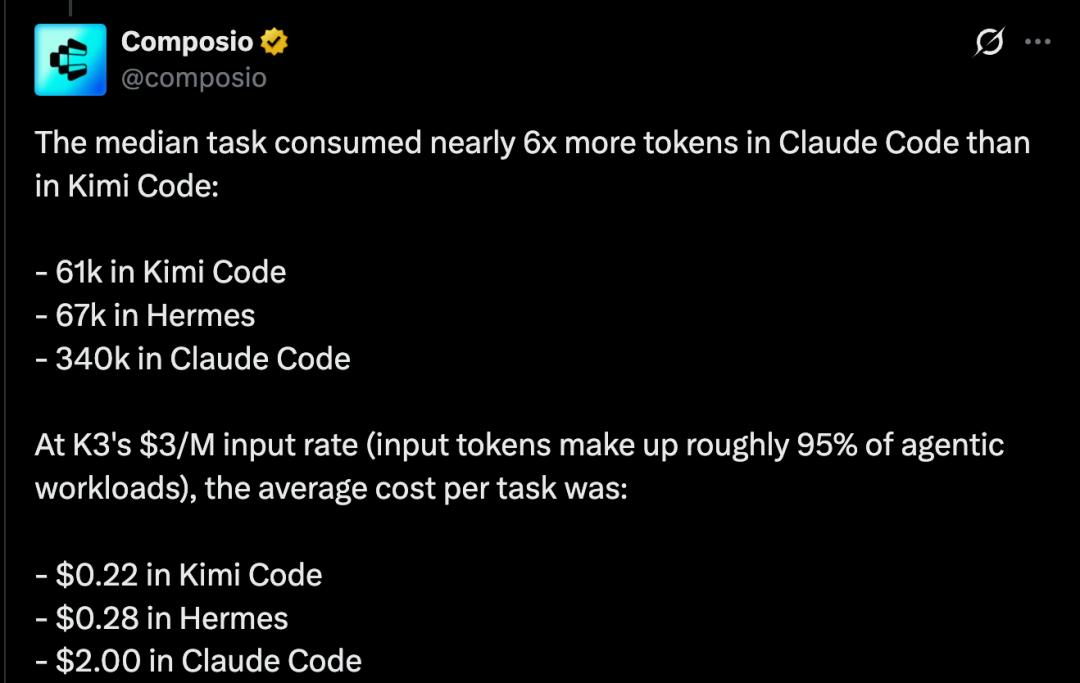
数据显示,在相同任务下,不同框架的Token消耗量最高相差达30倍。从中位数来看,Kimi Code平均消耗约6.1万Token,Hermes约为6.7万Token,而Claude Code则飙升至34万Token,是Kimi Code的6倍左右。若以Kimi K3每百万输入Token 3美元的价格计算,且假设输入Token占总量的95%,平均每个任务的成本分别为:Kimi Code约0.22美元,Hermes约0.28美元,而Claude Code高达2美元。这意味着,仅因框架选择不同,单次任务成本可能相差近10倍。
在速度维度上,Hermes以179秒的中位数耗时位居第一,Kimi Code为297秒,Claude Code最慢,为348秒。这一结果进一步印证了效率与成本的正相关性:更快的响应速度往往伴随着更精简的上下文管理和更低的Token开销。
深度解析:为何Claude Code如此“昂贵”?
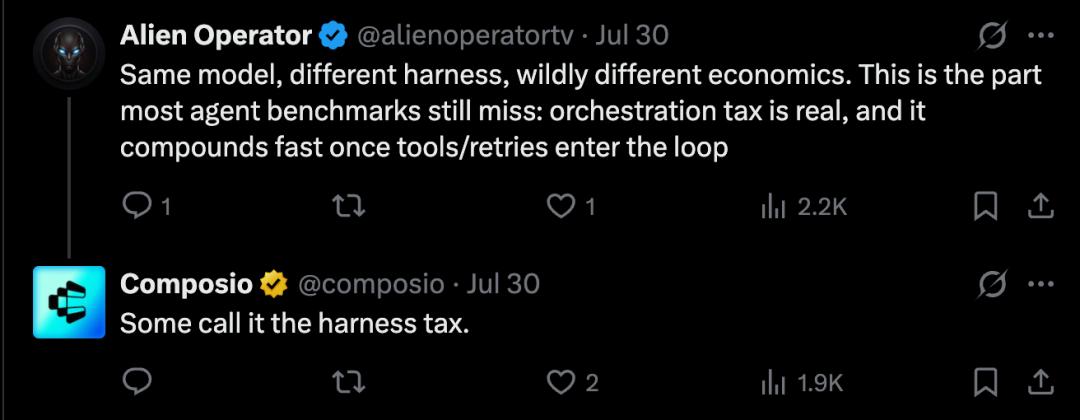
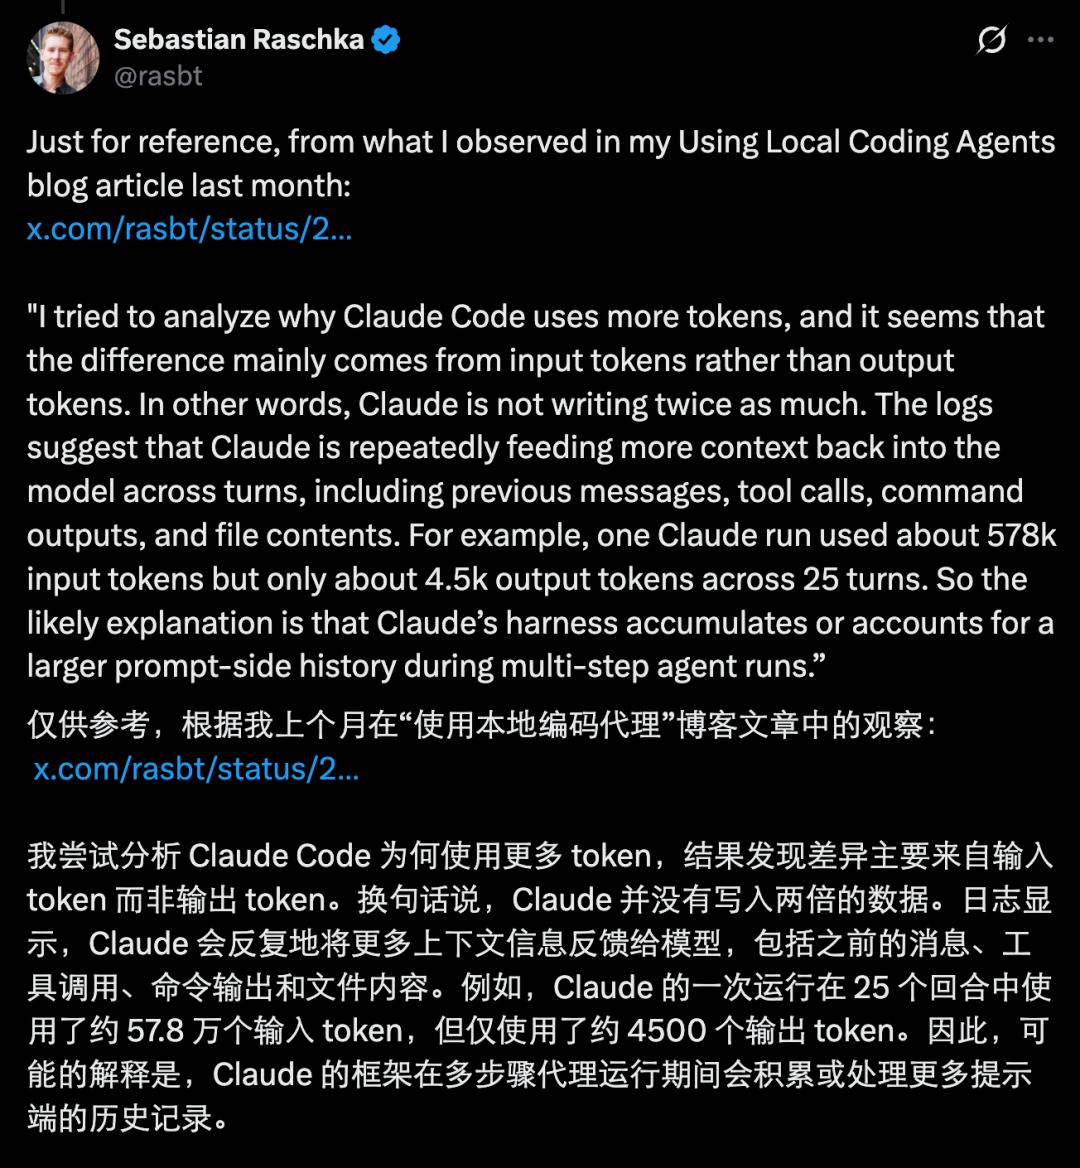
面对如此悬殊的成本差异,业界专家Sebastian Raschka提出了深刻的质疑:这究竟是优化不足、存在Bug,还是某种特定的设计策略?通过深入分析日志数据,Raschka发现,差异主要源于输入Token(Input Tokens)的激增,而非输出Token(Output Tokens)。
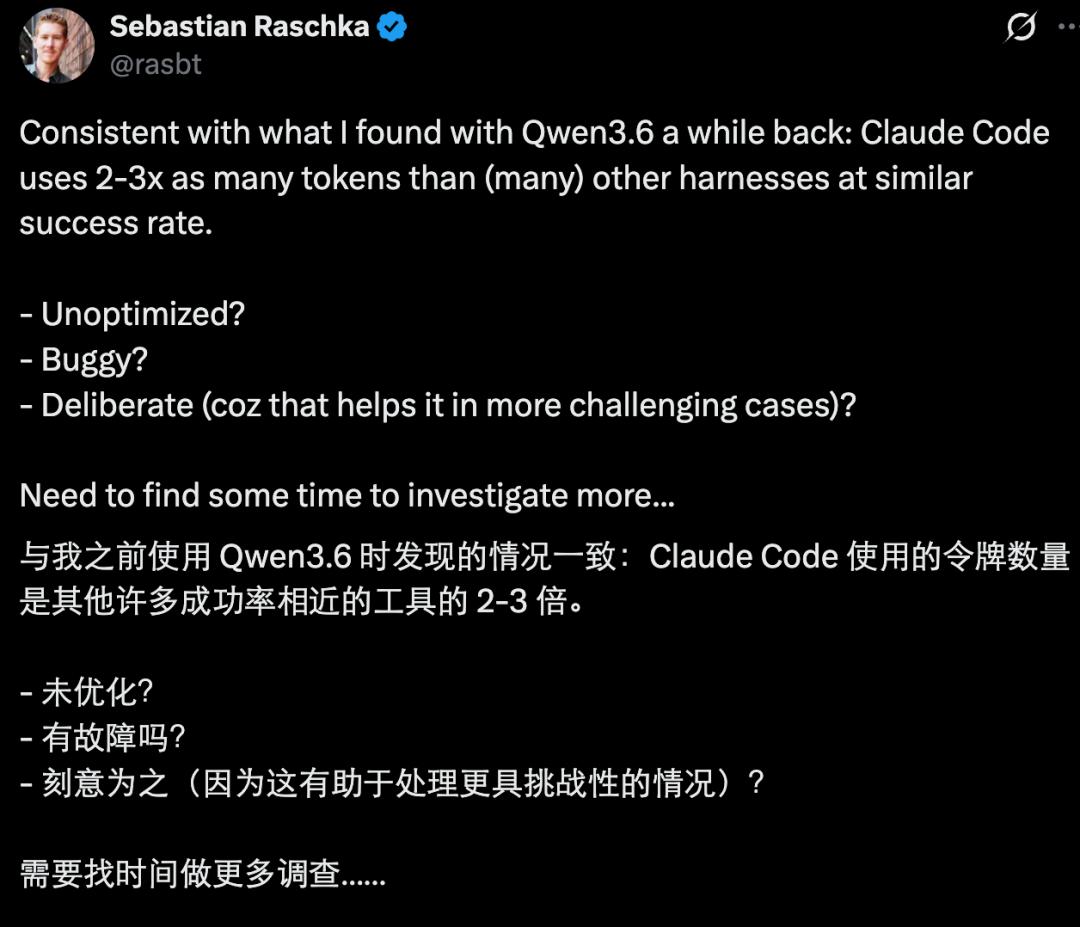
具体而言,Claude Code的Harness在多步Agent运行过程中,倾向于将更多的上下文历史重新注入模型。这包括之前的对话消息、工具调用结果、命令行输出以及文件内容等。在某次测试案例中,Claude Code在25轮交互中,输入Token高达57.8万,而输出Token仅为4500左右。这种“上下文累积”策略虽然可能有助于模型保持对复杂任务的长期记忆,但也导致了Token消耗的指数级增长。
相比之下,其他框架如Hermes和Kimi Code可能采用了更激进的上下文压缩或滑动窗口策略,仅保留最相关的信息片段,从而大幅降低了输入负载。这种设计哲学的差异,直接反映在了最终的账单上。对于开发者而言,这意味着在选择框架时,不能仅关注其“智能”程度,更需审视其“记忆”机制对资源的吞噬能力。
行业趋势:从“模型即产品”到“Harness即产品”
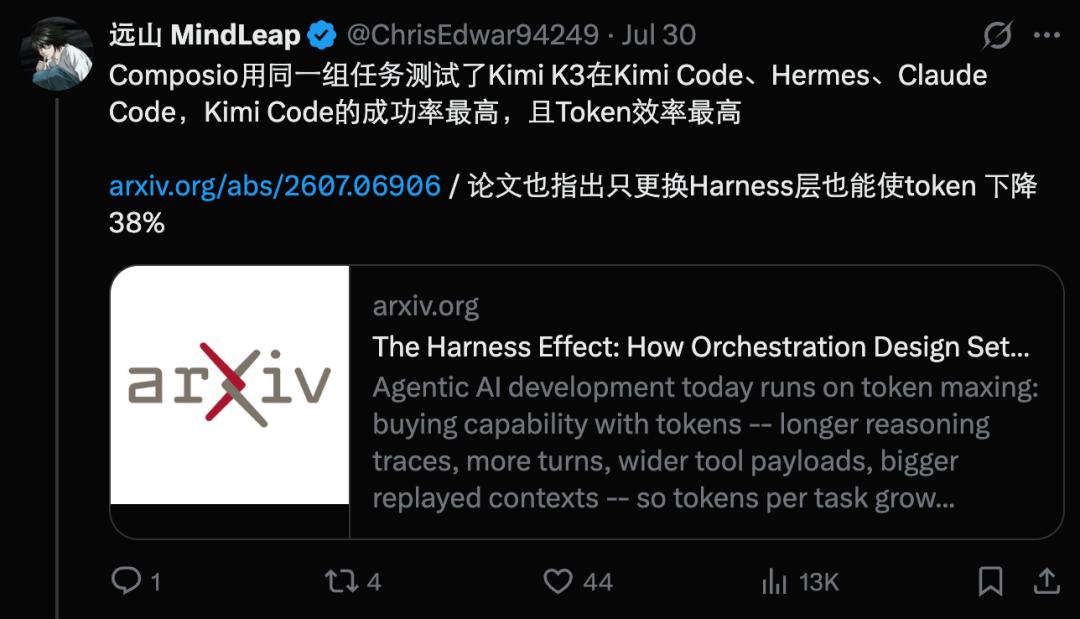
Composio的实验结果并非孤例。Writer公司发布的一篇论文进一步系统性地证实了这一趋势。该研究在22个企业任务和6个基础模型(包括Claude Sonnet 4.6、Gemini 3.1、Qwen 3.6等)的固定前提下,仅替换编排层,将传统生产级智能体循环替换为Writer自家的Harness。
实验结果令人瞩目:平均任务成本降低41%(从0.21美元降至0.12美元),中位延迟缩短44%(从48秒降至27秒),Token消耗减少38%(从14.2k降至8.8k),而任务完成质量基本持平(0.78提升至0.81,视为无显著差异)。在性价比方面,每美元所能获得的质量提升高达82%,每百万Token能完成的任务数从54.9跃升至92.0。
这些数据清晰地指向一个结论:随着大模型能力的同质化,编排层(Harness)的效率优化已成为降本增效的核心驱动力。过去,业界信奉“模型即产品”,认为强大的基座模型是竞争力的唯一来源;如今,“Harness即产品”的理念正在崛起。优秀的编排框架能够通过智能的上下文管理、高效的工具调用策略和精准的重试机制,在同等模型能力下实现数倍的成本节约和性能提升。
未来展望:重新定义Agent基准测试
这一趋势对AI应用开发的基准测试体系提出了新的挑战。传统的Benchmark往往只关注任务的成功率和准确率,却忽视了执行过程中的资源消耗。然而,在大规模部署场景下,Token成本和响应延迟是决定商业可行性的关键指标。
因此,未来的Agent竞赛将从“能否做”转向“做得多省”。开发者需要在现有的评估体系中引入“Harness税”这一维度,特别是在涉及工具调用和重试循环的场景中,这笔成本往往呈非线性增长。只有将效率指标纳入核心评估体系,才能筛选出真正具备生产级价值的Agent解决方案。
对于企业而言,这意味着在构建AI应用时,应优先考虑框架的优化程度,而非盲目追求最新、最贵的模型。通过精细化调整Harness策略,如优化上下文窗口、减少不必要的工具调用、引入缓存机制等,可以在不牺牲智能水平的前提下,实现显著的成本控制。
综上所述,Claude Code的高Token消耗现象并非偶然,而是不同设计哲学在资源效率上的直接体现。随着AI Agent生态的成熟,编排层的优化将成为开发者必须掌握的核心技能。在这场从“智能”到“效率”的转型中,谁能更好地驾驭Harness,谁就能在激烈的市场竞争中占据成本与性能的双重优势。未来的赢家,或许不是拥有最强模型的公司,而是拥有最高效编排框架的团队。