数百万书籍被AI“阅后即焚”?探索数字训练背后的伦理与法律争议
在液压切纸机冰冷的金属刀锋下,数百万册厚重的人类文明结晶被瞬间肢解。书脊断裂,装订胶化,原本紧密相连的知识载体变成了一沓沓待处理的纸张。这一画面若仅作为视觉奇观呈现,或许能引发某种强迫症式的舒适感;但若置于人工智能(AI)大模型训练的背景之下,这种工业化、规模化的“阅后即焚”,则暴露出技术狂飙突进背后令人不安的伦理困境。
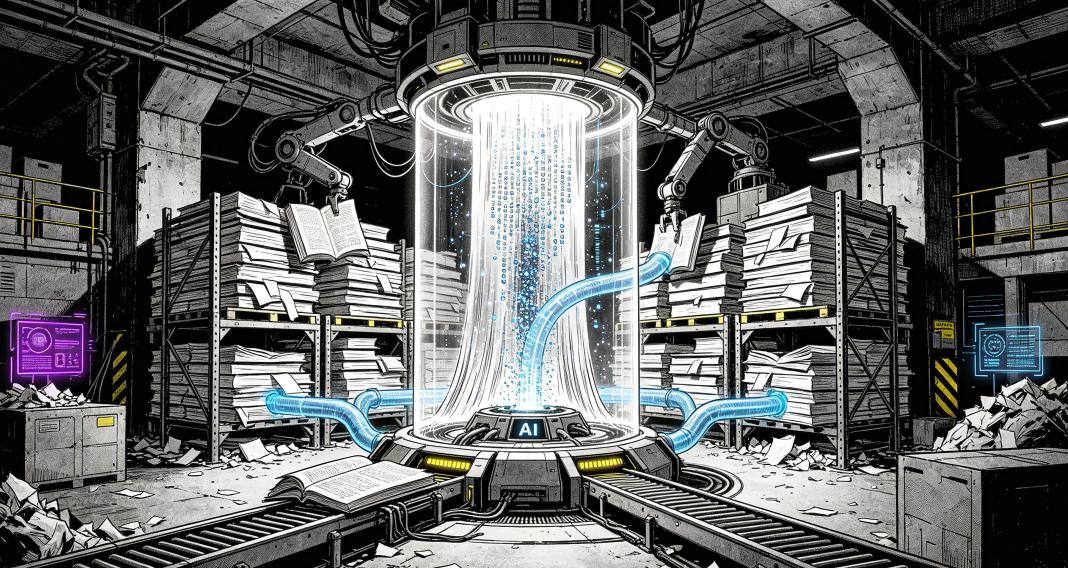
为了让AI模型真正理解人类的语言逻辑与知识体系,Anthropic等科技公司正在实施一项代号为“巴拿马计划”的秘密工程。其核心逻辑简单而残酷:获取书籍 -> 高速扫描 -> 销毁实体。这一过程不仅涉及对普通出版物的批量处理,更悄然延伸到了冷门书、绝版书乃至具有独特历史价值的收藏版本领域。
从互联网抓取到实体书掠夺
AI模型对高质量文本的渴求并非一日之寒。早期,OpenAI等公司主要依赖公开互联网数据进行预训练,但网页内容良莠不齐,噪音极大。相比之下,经过编辑校对、结构严谨的图书数据被视为“纯净水源”。
起初,获取这些数据的途径主要是数字化手段。法庭材料显示,Anthropic曾从Books3、LibGen等盗版资源库下载超过700万本电子书。然而,随着版权意识的觉醒和法律风险的加剧,单纯依赖盗版电子书的模式难以为继。法官威廉·阿尔萨普在2025年的判例中指出,虽然模型训练可能属于“合理使用”,但获取盗版内容的方式本身并不合法。
这一法律红线迫使AI公司寻找更“干净”的数据来源。于是,目光转向了现实世界中的纸质书。相比盗版电子书,合法购买的纸质书在版权链条上更加清晰。Anthropic的做法极具代表性:购买实体书 -> 扫描成数字副本 -> 销毁原书。从法律技术角度看,这被视为一种格式转换而非复制,因为市场上最终只存在一份数字版本,并未增加流通量。
然而,这种“合法合规”的表象下,隐藏着对知识载体物理价值的漠视。当一本书被切掉书脊、打成纸浆,它所承载的不仅仅是文字信息,还有纸张的质感、装帧的设计、甚至前人留下的批注与记忆。对于这些实体书而言,数字化的完成即是其物理生命的终结。
“巴拿马计划”的细节与争议
《华盛顿邮报》与404 Media的后续报道,进一步揭开了这场秘密行动的冰山一角。据披露,Anthropic在一年内花费数千万美元,购入了数百万本纸质书。供应商通过切掉书脊来加速扫描过程,随后将剩余的纸张交由回收公司处理。一份内部方案甚至计划在半个月内处理高达200万本书籍。
最令业界震惊的并非规模,而是内部文件的措辞。Anthropic明确表示,这是一项“对全世界所有书籍进行破坏性扫描的行动”,且“不希望外界知道”。这种隐秘性加剧了公众的不信任感。作为一家强调AI安全与责任的科技公司,Anthropic在背地里推行如此激进的数据采集策略,与其公开倡导的道德准则形成了鲜明反差。
此外,数据质量的追求也推动了这一趋势的扩大化。生成式AI爆发后,互联网上充斥着大量AI生成内容(AIGC)和数据投毒样本。相比之下,2022年以前出版的纸质书,因其未经现代AI污染,且经过专业编辑流程,成为了训练高质量语言模型的“黄金数据”。这种对“纯净人类知识”的渴望,使得AI公司的触角延伸到了二手书市场、旧书店乃至图书馆的绝版目录中。
绝版书的命运与物理价值的消亡
在数字时代,我们往往误以为“内容”可以完全脱离“载体”存在。只要文字被数字化,书籍的价值就得以保留。然而,对于古旧书商和藏书家而言,书籍的物理属性本身就是一种核心资产。
澳大利亚和新西兰古旧书商协会主席Dawn Albinger指出,古旧书的价值不仅在于印刷正文,更在于其作为历史物件的独特性。书页上的手写批注、作者的亲笔签名、历任收藏者的题赠,以及特殊的装帧工艺,共同构成了这本书的“灵光”(Aura,本雅明语)。这些信息依附于特定的物理实体,无法通过简单的OCR(光学字符识别)完全提取。
当AI公司将绝版书送进切割机时,它获得了一份完美的数字文本,却永久销毁了承载这段历史记忆的物理原件。对于孤本或存世极少的珍本而言,这种损失是不可逆的。即使书中文字可以重新印刷,但作为唯一历史见证者的那本书,已经不复存在。
这种现象在二手书市场已初现端倪。专营稀有图书的书商反映,自2024年以来,每周订单量激增,买家对冷门、外文及绝版书的需求毫无规律,唯一共同点是拥有ISBN编号。虽然这为书商清库存提供了机会,但得知这些书籍最终将被销毁而非阅读,许多从业者感到深深的惋惜与不安。
法律边界与行业退让
2025年的司法判例为Anthropic的做法提供了一定的法律保护伞。法官认为,只要AI公司合法购买实体书,扫描后销毁原书,且不向市场提供额外的数字副本,就不构成版权侵权。这种逻辑在技术上是自洽的,但在伦理上却备受争议。
法律专家James Grimmelmann认为,Anthropic放弃盗版库,转而通过购买实体书并销毁的方式来获取数据,是一种“聪明的选择”,体现了对法律边界的试探与遵循。然而,法律的滞后性使得这一判例仅在美国范围内具有参考意义,且未涵盖书籍作为文化资产的非经济价值。
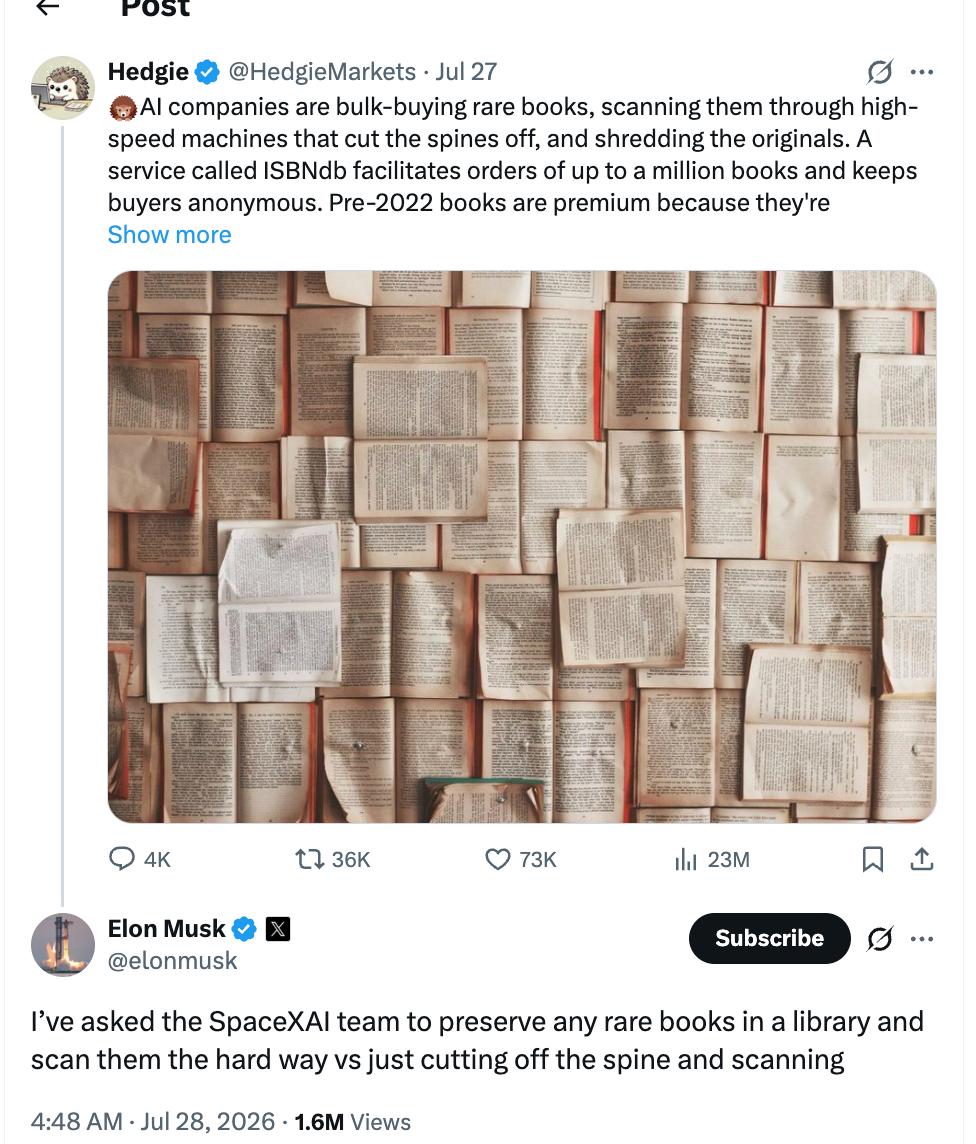
舆论的反噬很快到来。在报道发布后,图书数据库公司ISBNdb迅速删除了面向AI公司的采购页面,并将此业务称为“市场需求测试”。SpaceX创始人埃隆·马斯克也公开表态,要求旗下AI团队对稀有书籍采用无损扫描方式,并保存实体书。这些退让更多是出于声誉管理的考量,而非对行业规则的实质性重构。
重构AI数据伦理的必要机制
当前的争议表明,仅靠法律上的“合理使用”原则已不足以规范AI时代的数据采集行为。我们需要建立新的行业标准和伦理框架:
首先,建立“稀有书籍豁免机制”。对于绝版书、签名本、带有特殊历史批注的版本,应禁止采用破坏性扫描方式。AI公司应优先采用无损扫描技术,并在扫描后将实体书捐赠给公共图书馆或档案馆,确保其物理价值得以保留。
其次,实施透明度义务。AI公司在大规模采购数据时,应公开采购书目的大致范围,并接受第三方伦理审查。秘密进行的“巴拿马计划”式操作,必须被阳光下的规范化流程所取代。
最后,重新定义“数据价值”。社会应认识到,书籍不仅是信息的容器,更是文化遗产的一部分。在追求AI技术突破的同时,必须权衡对文化记忆的潜在破坏。技术不应以消灭人类文明的物理载体为代价。
AI吞噬纸质书的进程或许无法完全逆转,但在速度与伦理之间寻找平衡,是人类社会必须面对的紧迫课题。当我们在屏幕前享受着更强大的AI智能时,不应忘记,每一份沉默消散的纸张背后,都有一段被遗忘的历史。保护这些脆弱的物理连接,不仅是对过去的尊重,也是对人类共同记忆完整性的守护。