国产大模型三强同日亮剑:视频生成与Agent能力的双重突围
国产AI的“集体交作业”时刻
2026年7月的最后一天,人工智能领域并未因夏末的余热而沉寂,反而迎来了一场堪称“密集轰炸”的技术发布潮。在这一天,MiniMax、字节跳动与DeepSeek三家头部厂商几乎在同一时间窗口,向市场抛出了各自在生成式AI领域的最新答卷:MiniMax H3、Seedance 2.5以及DeepSeek V4-Flash。这种近乎默契的“扎堆”发布,并非简单的巧合,而是国产大模型厂商在视频生成与智能体(Agent)两大核心赛道上,从单点突破走向全面竞争的缩影。
过去,视频生成模型往往受限于单一模态或特定任务,用户需要在多个工具间切换以完成一条完整的视频内容。而此次发布的三款模型,分别代表了“全能多模态”、“长叙事视频”与“深度智能体”三种不同的演进路径。MiniMax H3试图通过统一架构打破模态壁垒,Seedance 2.5致力于解决视频生成的连贯性与叙事逻辑问题,而DeepSeek V4-Flash则通过后训练技术,将轻量级模型的能力边界向专业开发者领域延伸。这三者的同时亮相,标志着国产AI正在从“拼参数”转向“拼落地”与“拼体验”的新阶段。
MiniMax H3:多模态统一架构的降维打击
MiniMax H3的发布,最引人注目的在于其“全能”定位。在传统的视频生成工作流中,文生视频、图生视频、视频编辑以及动作迁移往往由不同的专用模型完成。这种碎片化的工具链不仅增加了用户的操作成本,也导致了数据流转中的信息损耗。H3的核心突破在于构建了一个统一的多模态上下文理解框架,将文本、图片、音频和视频的输入与输出整合在同一套模型架构中。
从技术实现来看,H3支持高达2K分辨率的视频直出,单次生成时长可达15秒。更重要的是,它在指令遵循、文字渲染以及品牌信息呈现上进行了针对性优化。对于广告主和电商品牌而言,这意味着可以直接输入商品图、品牌字体、参考视频甚至背景音乐,由模型自动生成包含产品展示、人物表演和品牌信息的完整广告素材。这种“一站式”生成能力,极大地缩短了从创意到成片的周期。
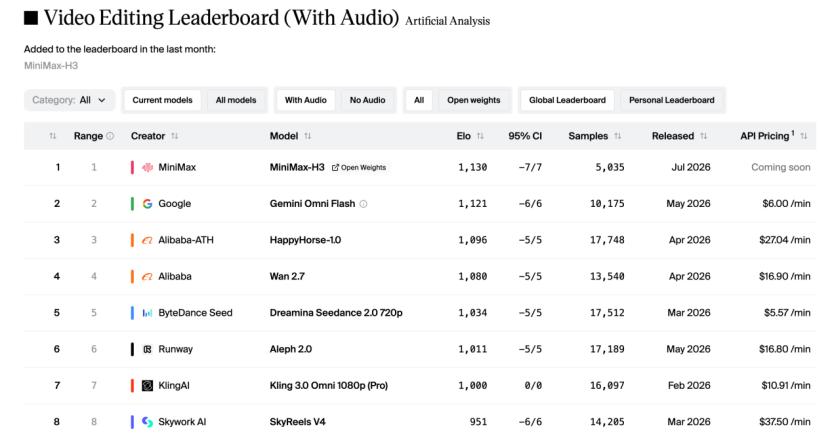
此外,H3在视频到视频(V2V)的动作迁移能力上表现突出。用户只需提供一段真人动作参考,模型即可替换人物、服装、产品甚至场景,同时保持动作的一致性。这一功能在虚拟偶像直播、电商模特换装等场景中具有极高的应用价值。在榜单表现上,H3在Artificial Analysis的视频编辑榜单中位列第一,显示出其在多模态处理上的领先地位。
成本与开源:MiniMax的商业化策略
除了技术能力的提升,MiniMax H3在商业化策略上也展现出了极强的侵略性。其2K视频生成价格定为0.8元每秒,仅为业内同类旗舰模型的三分之一。这一价格优势并非通过牺牲质量实现,而是源于底层技术的优化。MiniMax采用了高压缩Tokenizer技术,有效减少了视频生成所需的Token数量,同时通过异构训练、任务负载均衡以及GPU利用效率的优化,大幅降低了推理成本。
更为关键的是,H3将成为MiniMax首款开源的多模态生成模型。开源策略不仅有助于构建开发者生态,允许企业进行本地部署和数据适配,也为国产芯片厂商提供了软硬件协同优化的机会。在算力成本日益成为制约AI发展的背景下,通过开源生态降低整体使用门槛,是MiniMax在激烈竞争中突围的重要一步。这种“技术+成本+生态”的组合拳,显示出MiniMax在视频生成领域深耕的决心。
Seedance 2.5:从“抽卡”到“导演”的叙事进化
如果说MiniMax H3强调的是多模态的统一,那么字节跳动推出的Seedance 2.5则聚焦于视频生成的“叙事性”与“连贯性”。长期以来,AI视频生成被诟病为“抽卡”体验:用户输入提示词,模型生成一段镜头,但人物表情、场景细节往往在切换时发生突变,导致视频缺乏逻辑连贯性。要制作一分钟的视频,创作者往往需要生成十几段素材,再手动拼接,效率低下且效果难以保证。
Seedance 2.5的核心升级在于将单次视频生成时长从15秒延长至30秒。这不仅仅是时间的翻倍,更是叙事能力的质变。在30秒的窗口内,模型能够组织多个具有逻辑关联的画面,实现故事的铺垫、推进、转折与收尾。更重要的是,用户可以在已有视频的基础上继续生成,模型会尽力保持人物、场景、风格、声音及叙事节奏的一致性,从而形成数分钟且视听语言统一的内容。
为了摆脱AI视频常见的“油腻感”,Seedance 2.5在人物皮肤质感、眼神光影以及画面饱和度上进行了精细化调整,使其更接近实拍效果。同时,模型减少了自作主张添加字幕和背景音乐的行为,赋予创作者更多的控制权。在参考能力方面,用户最多可输入30张图片、10段视频和10段音频,让模型同时参考不同素材中的人物、声音、构图等元素。这种“多素材投喂”的方式,使得AI从单纯的“素材生成器”逐渐演变为具备导演、摄影和剪辑能力的创作工具。
时间戳控制与局部编辑:精细化的创作自由
Seedance 2.5的另一大亮点是其强大的编辑能力。用户可以通过时间戳精确规定视频中特定秒数发生的剧情、动作或视角。例如,保留演员的动作轨迹,仅替换背景场景;或者保持人物和画面不变,仅修改特定时间段的镜头运动。这种精细化的控制能力,使得创作者能够对视频进行“外科手术式”的修改,极大地提升了内容的可控性和可迭代性。
这种从“生成”到“编辑”的能力延伸,反映了AI视频工具从“玩具”向“生产力工具”的转变。对于专业视频创作者而言,能够精确控制每一帧的细节,是将其纳入工作流的关键。Seedance 2.5通过强化参考能力和局部编辑功能,正在逐步消除AI视频与专业影视制作之间的鸿沟,为短视频、广告片乃至微电影的创作提供了新的可能性。
DeepSeek V4-Flash:后训练重塑Agent能力
与视频生成模型的“视觉盛宴”不同,DeepSeek V4-Flash的发布则显得更为“硬核”和“务实”。7月31日,DeepSeek宣布V4-Flash正式版API开启公测。值得注意的是,V4-Flash的模型架构和尺寸并未改变,其性能提升主要来自于重新进行的后训练(Post-training)。这一策略表明,在基础模型预训练成本日益高昂的背景下,通过高质量数据、强化学习和任务环境对已有模型进行“调教”,已成为提升模型实用性的另一条重要路径。
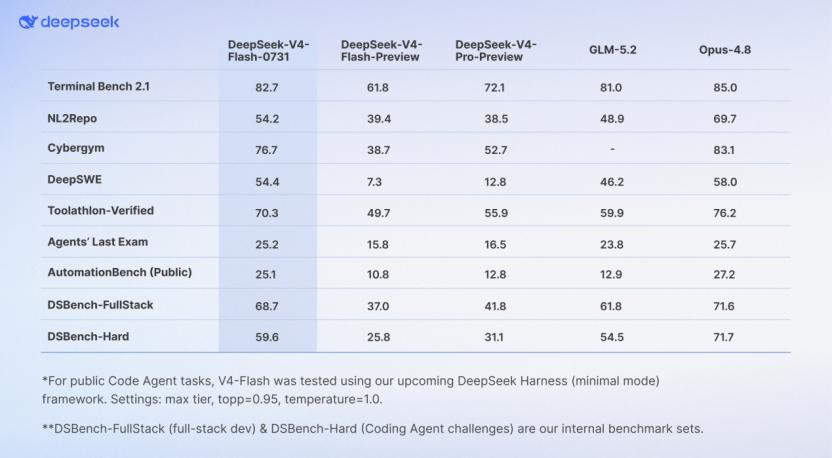
V4-Flash的重点升级方向是工具调用、任务规划、代码开发和Agent执行能力。根据DeepSeek公布的数据,该模型在Terminal Bench 2.1、NL2Repo、DeepSWE等多个Agent测试中取得了显著提升,其中Terminal Bench 2.1得分达到82.7。这一成绩意味着,V4-Flash在处理复杂代码任务、文件修改、工具调用及结果检查等方面,已经具备了接近人类初级工程师的水平。
开发者生态与轻量模型的崛起
V4-Flash原生支持Responses API,并针对Codex等Agent开发环境进行了适配。开发者可以在这些环境中调用DeepSeek模型,让模型完成代码阅读、任务拆解等复杂工作,而不仅仅是回答孤立的编程问题。DeepSeek还计划发布用于完成代码Agent任务的Harness框架,进一步降低开发者构建智能体的门槛。
这一升级也重新强调了后训练的价值。当基础模型越来越大,预训练边际效益递减时,如何通过后训练挖掘模型潜力,成为竞争的新焦点。V4-Flash的发布,展示了轻量级模型通过精细化训练,在特定领域(如代码Agent)逼近甚至超越旗舰模型的可能性。虽然目前V4-Pro尚未同步更新,但V4-Flash的进步表明,轻量模型与旗舰模型之间的能力差距正在被迅速压缩。
行业启示:从技术竞赛到场景深耕
回顾MiniMax H3、Seedance 2.5与DeepSeek V4-Flash的发布,我们可以清晰地看到国产大模型发展的三个趋势:一是多模态融合成为标配,单一模态模型难以满足复杂创作需求;二是视频生成从“生成片段”向“叙事连贯”演进,注重用户体验与创作效率;三是智能体(Agent)能力成为开发者关注的核心,后训练技术成为提升模型实用性的关键。
这三款模型的集中亮相,不仅展示了国产AI在技术上的快速迭代,更反映出厂商对应用场景的深刻理解。MiniMax通过开源与低成本策略切入企业级市场,字节跳动通过提升视频叙事能力优化创作者体验,DeepSeek则通过强化Agent能力服务开发者生态。这种差异化竞争,有助于推动AI技术在垂直领域的深度落地。
未来,随着多模态技术的进一步成熟和Agent能力的增强,AI将从“辅助工具”逐渐转变为“创作伙伴”甚至“独立创作者”。对于用户而言,这意味着更低的使用门槛、更高的创作效率以及更丰富的内容形式。而对于行业而言,如何在技术突破与商业落地之间找到平衡,将是下一阶段竞争的核心。国产大模型厂商的这一波“集体交作业”,或许只是这场变革的开端。