谷歌Gemini Robotics 2揭秘:全身智能能否攻克机器人“最后几厘米”难题?
在2026年世界人工智能大会(WAIC)的喧嚣散去之后,具身智能行业的叙事逻辑发生了微妙而深刻的转变。过去,公众对机器人的关注点往往停留在后空翻的杂技或机械舞的节奏感上,这种“表演型”能力虽然震撼,却难以掩盖行业深处的焦虑:硬件躯体的成熟并未带来同等水平的智能内核。超过200家参展企业与300多台真机的同台竞技,最终指向了一个共识——机器人不能仅止于“动”,更需具备在混乱环境中“活”的能力。就在展会结束后不久,Google DeepMind推出的Gemini Robotics 2,以“全身智能”为核心命题,试图填补这一关键拼图。
从回合制到连续流:身体作为统一动作空间
传统机器人控制架构普遍存在一种“回合制”的割裂感。在典型的工作流中,机器人首先需要移动到目标位置,停止并校准姿态,随后激活独立的机械臂控制器执行抓取;任务完成后,再切换回导航模块前往下一个地点。这种模块化设计在静态、结构化的环境中表现尚可,但在动态、非结构化的真实世界里,模块间的切换往往意味着时间的浪费和误差的累积。例如,当目标物体发生轻微位移时,独立的视觉模块与运动规划模块若不能实时协同,机器人便可能陷入“僵直”或重复校准的死循环。
Gemini Robotics 2的核心创新,在于打破了这种基于“模块边界”的控制范式。官方演示中,搭载该模型Apptronik Apollo 2机器人走向地面的绿色水壶,随后弯腰、屈膝、前倾重心,最终将水壶提起。这一系列动作并非由多个独立脚本拼接而成,而是由同一个视觉-语言-动作(VLA)模型统一生成。谷歌将整副身体视为一个相互耦合的动作空间,双腿不再仅仅是运输工具,而是维持全身平衡与重心调整的关键组件;手臂也不再是孤立的作业单元,而是与躯干运动紧密协同的操作延伸。
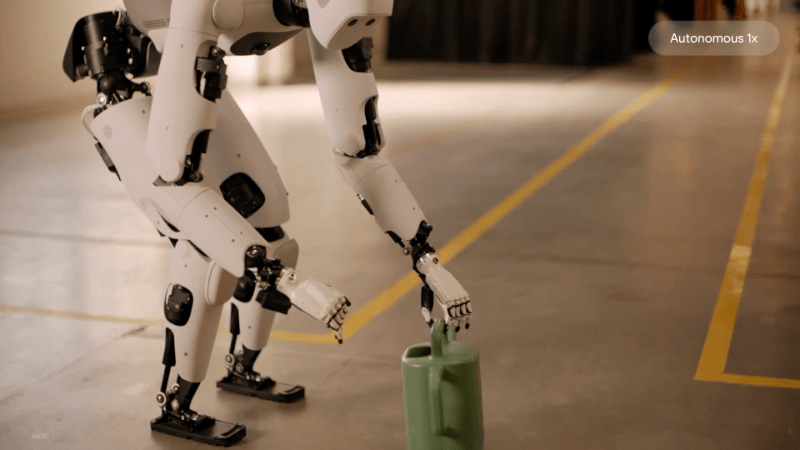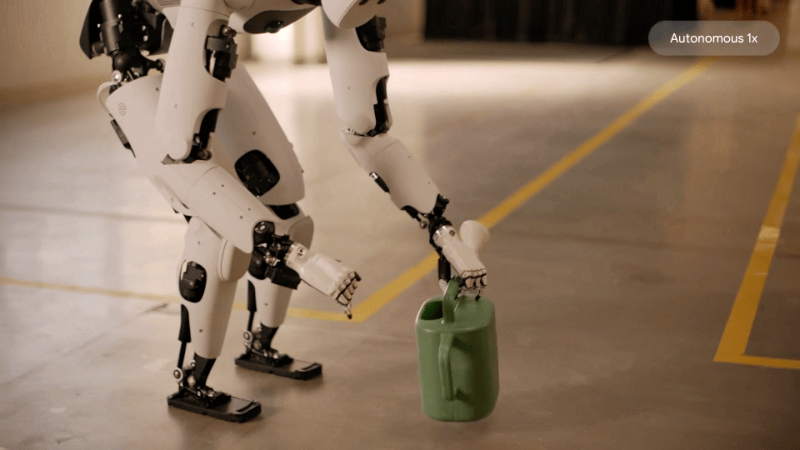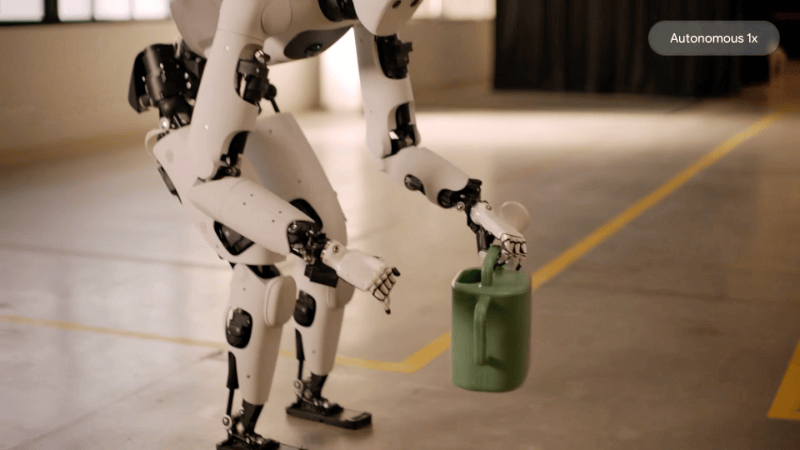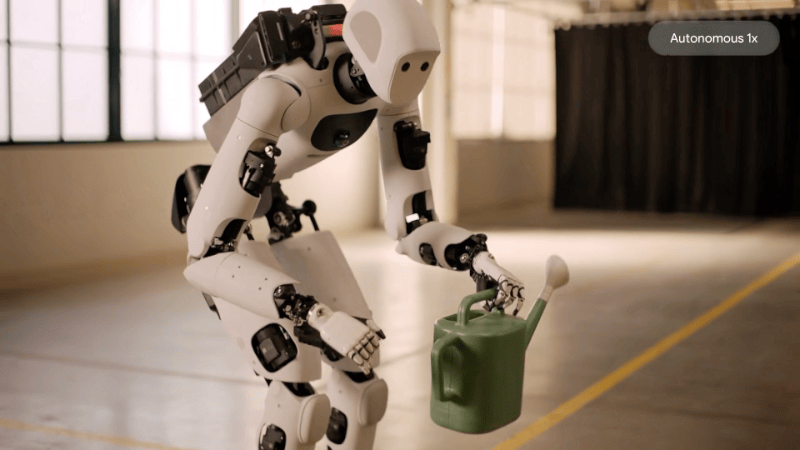
值得注意的是,视频明确标注画面为自主运行且按真实速度播放。这看似平平无奇的“弯腰拾物”,背后是对视野、可达范围、步态动力学及重心转移的极高要求。手臂前伸改变力矩,躯干随之倾斜,双腿即刻补偿以维持平衡。这种“一边思考推理,一边移动操作”的能力,标志着机器人控制从“规划-执行”的两阶段分离,向“感知-决策-执行”的端到端融合迈出了实质性一步。
攻克“最后几厘米”:精细操作的失败样本与行业困境
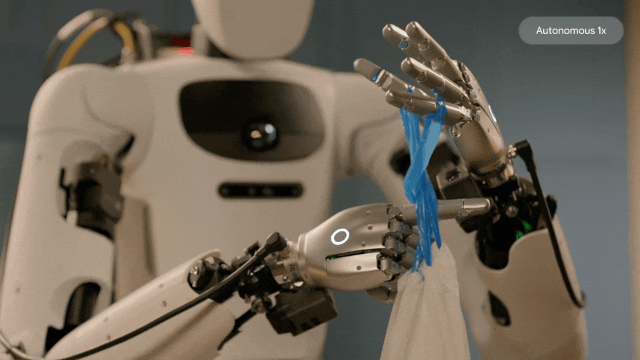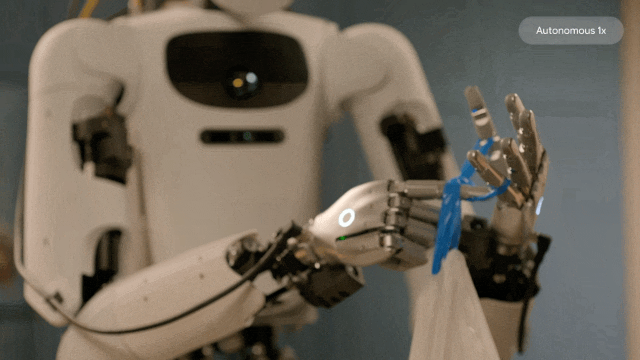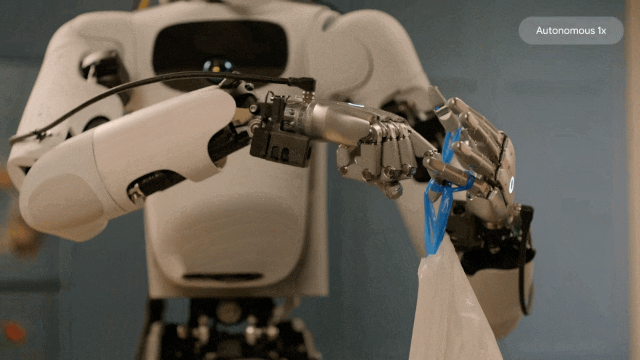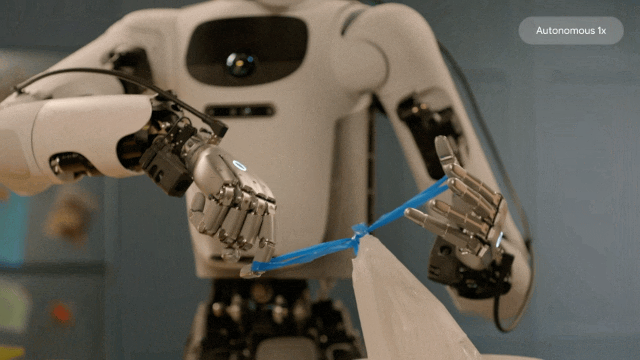
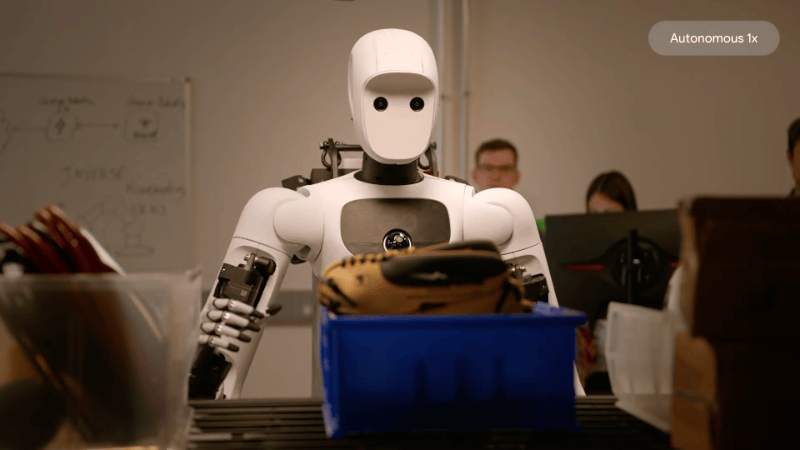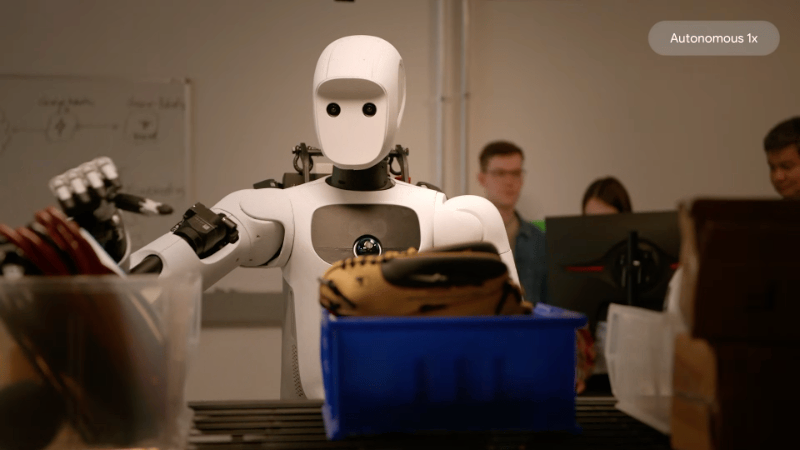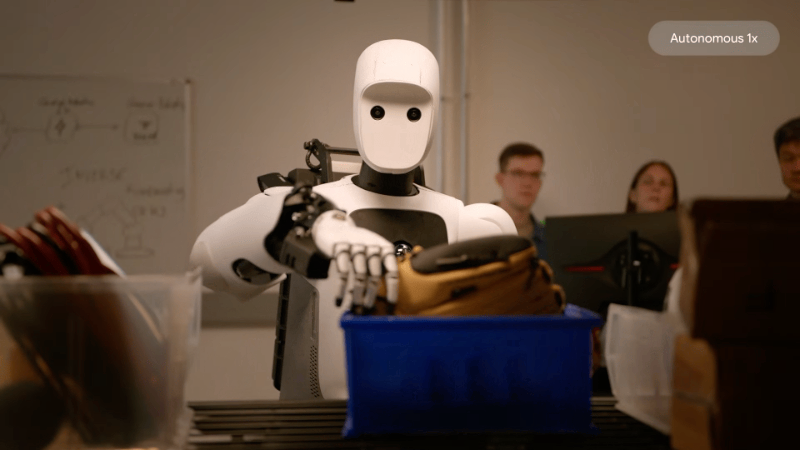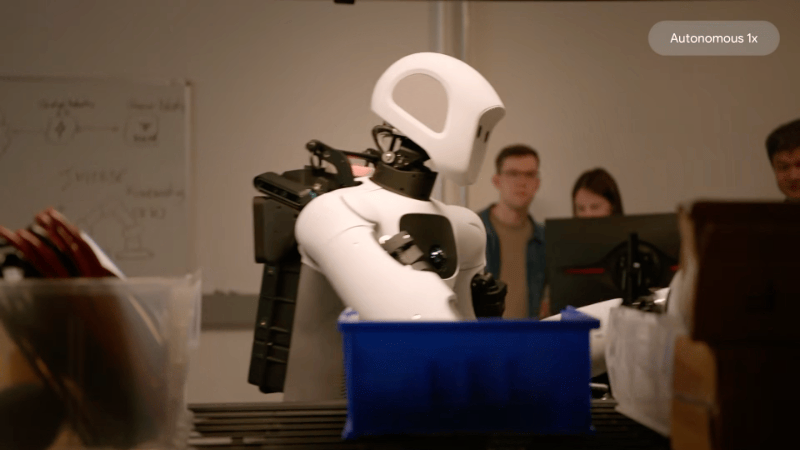
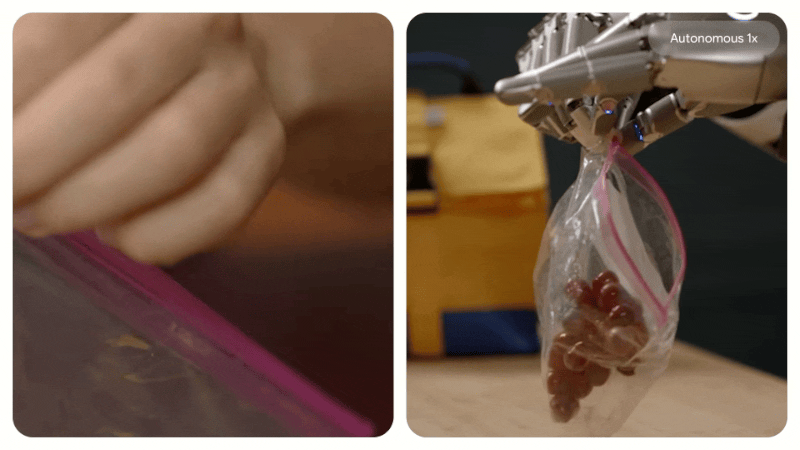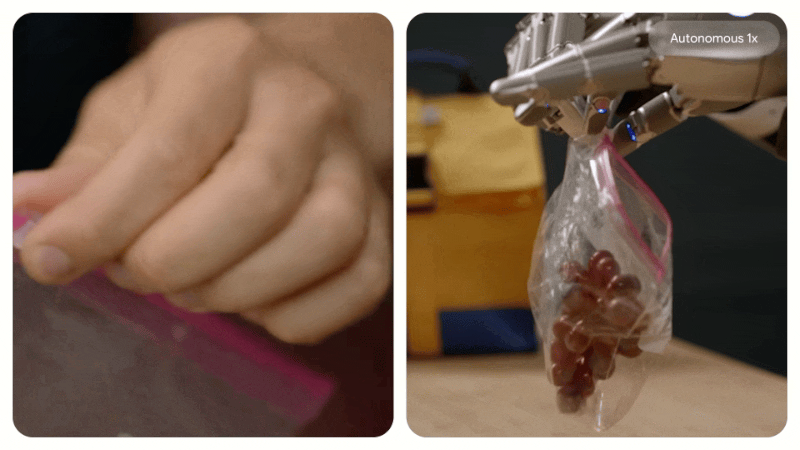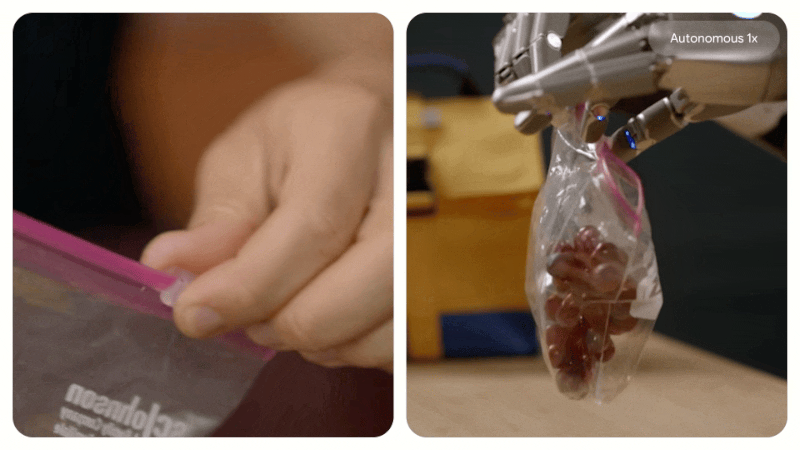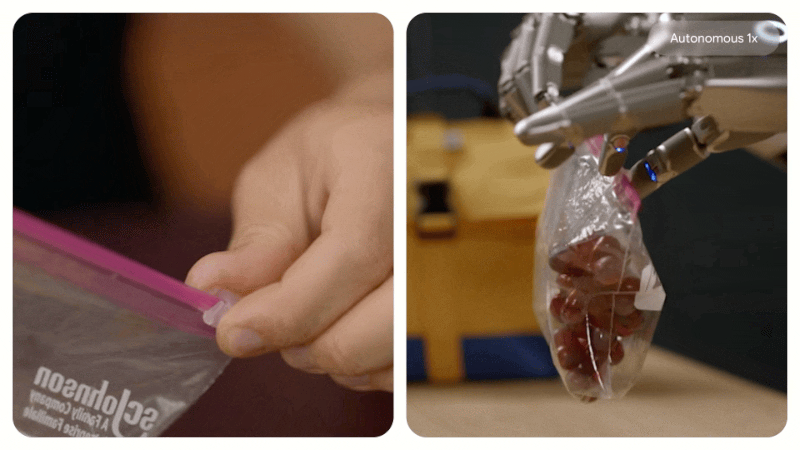
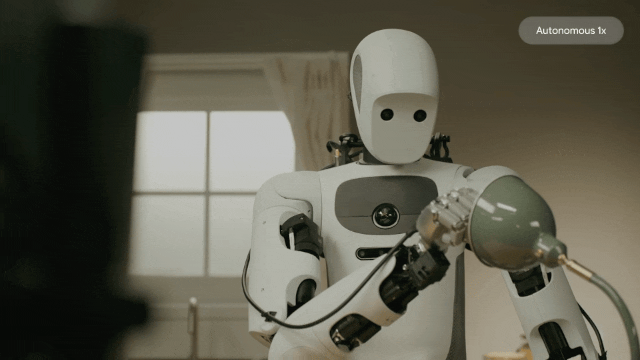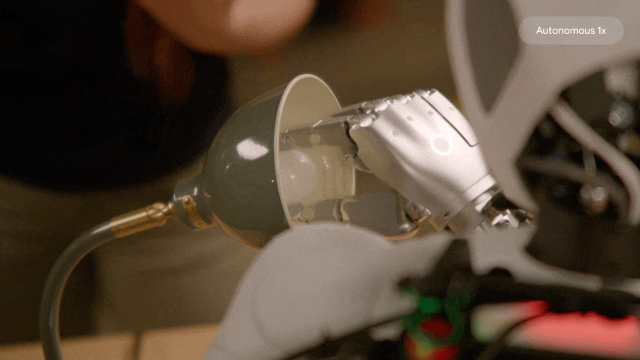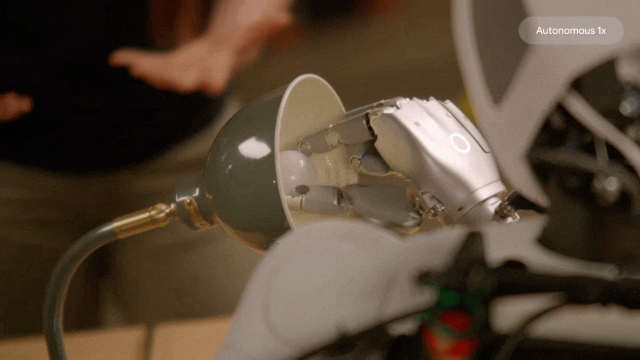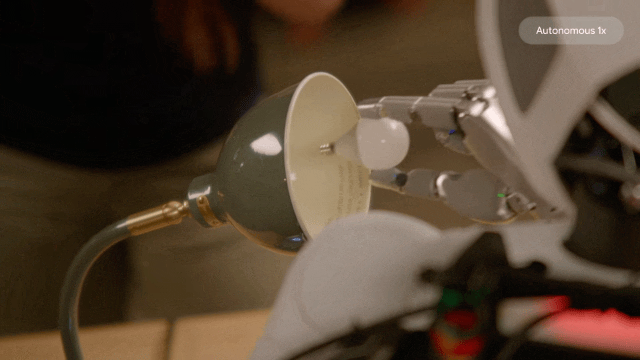
虽然全身运动控制的突破令人振奋,但决定机器人能否真正进入家庭和工厂的,往往是“最后几厘米”的精细操作能力。在官方演示中,Apollo 2利用拥有22个自由度的SharpaWave五指灵巧手,尝试拧灯泡、封自封袋、给垃圾袋打结;Franka Duo则使用两指夹爪进行工具收纳。这些任务涉及连续接触、双手配合、物体形变及力度控制,远非简单的A点到B点搬运可比。
人类在执行此类任务时,依赖的是触觉反馈与视觉感知的无缝融合,无需预先计算每个关节的角度。然而,对于基于概率预测的生成式模型而言,生成高频、连续且符合物理规律的动作指令,仍是一条充满荆棘的道路。谷歌披露的实际测试数据揭示了这一技术瓶颈:在两指夹爪测试中,通用抓放、工具配套和精密插入的平均成功率分别达到了74.2%、78.9%和89.6%,表现相对稳健。然而,当切换到更复杂的五指灵巧手时,成功率出现了显著断层。
数据显示,拧下灯泡的成功率高达92%,但拧上灯泡仅为36%;扎垃圾袋的成功率为44%;而涉及更复杂形变控制的簸箕使用和自封袋封口,成功率分别跌至32%和40%。这组数据直观地表明,尽管大模型已能接管相当复杂的手部动作,但在处理柔软、易形变物体及需要极高精度的装配任务时,仍远未达到“人类级”的稳定水平。机器人拧灯泡十次失败六次的现状,说明其在触觉推理、微操力度调节及动态误差补偿方面,仍缺乏足够的鲁棒性。
架构演进:并非抛弃“大小脑”,而是重新定义边界
在具身智能领域,普遍存在一种对“端到端”模型的迷信,即认为用一个巨型神经网络取代所有传统模块是唯一的出路。然而,Gemini Robotics 2的架构设计显示出一种更为务实的折中主义。谷歌并未完全抛弃传统的“大小脑”分层架构,而是对其进行了重新划分。
在该体系中,Gemini Robotics ER 2承担高层“大脑”的角色,负责理解环境、规划长任务、进行多机协作调度及引入安全约束。它具备语义推理能力,能够调用导航API或其他厂商的VLA作为工具,并实时监控任务进度。而Gemini Robotics 2 VLA模型则作为中间层,将视觉与语言指令直接转化为动作,负责全身的运动生成。底层的安全机制,如急停、限速及防碰撞逻辑,依然保留传统的物理安全兜底。
这种架构设计深刻反映了物理世界的复杂性。高层推理需要毫秒级的响应频率,而底层平衡控制需要千赫兹(kHz)级的处理速度。将所有环节强行塞入单一网络,不仅会导致训练成本呈指数级上升,更会在出现错误时增加调试难度。谷歌通过ER 2与VLA的解耦,既保留了高层语义理解的灵活性,又确保了底层动作执行的实时性与安全性。
这一思路与行业其他领先者的探索不谋而合。Figure AI发布的Helix 02模型同样采用了多层架构,System 1以200Hz输出全身关节目标,System 0以1kHz处理平衡,System 2负责语义推理。智元机器人的GO-2模型则提出“语义-执行鸿沟”概念,通过动作思维链与异步双系统连接低频规划与高频执行。这些案例表明,行业正在从非此即彼的二元对立中走出,转向构建多时间尺度紧密咬合的混合系统。
通用性的代价与未来挑战
Gemini Robotics 2的另一大亮点是其On-Device 2组件,支持用少于200个样例、几小时的数据适配新的机器人本体。这一特性对于具身智能的规模化落地至关重要。如果每次更换机械臂或传感器都需要重新采集海量数据并从头训练,通用模型便难以形成规模效应。
然而,通用性往往以牺牲特定场景的性能为代价。英伟达GR00T N1.6虽拥有数千小时遥操作数据,但仍承认在分布外泛化上存在挑战。谷歌的五指操作成功率波动也证实,同一个模型控制不同身体,不等于它能稳定掌握所有身体形态的物理特性。更严峻的挑战来自真实部署环境:设备磨损、电量限制、意外碰撞、人类突然闯入以及网络中断,这些都是实验室演示中难以完全模拟的变量。
此外,多机协作虽在演示中得以展现,但仅限于经过精心设计的短周期场景。让不同形态的机器人在真实工厂中连续协作数月,仍需要解决通信延迟、冲突检测及长期稳定性等复杂问题。
结语
Gemini Robotics 2的发布,并非意味着机器人已经突然“开窍”,而是标志着具身智能模型开始系统地越过桌面与上半身的限制,将行走、平衡、精细操作、长任务规划与多机协作纳入同一张考卷。相较于过去“一种任务对应一组算法”的前大模型时代做法,这是一种范式级的进步。
随着WAIC上展示的成熟芯片、关节及整机硬件日益完善,机器人拥有了更强壮的躯体。而谷歌等科技巨头正致力于赋予这些躯体以统一的智能灵魂。至于机器人何时能真正走进厨房,弯腰捡起掉落的杯子并顺手擦干污渍,这需要技术在感知、推理、控制及硬件可靠性上实现全方位的跃迁。目前,我们正处于这一漫长征程的关键节点,虽未至终点,但方向已明。