大模型估值逻辑重构:为何SOTA叙事正在失效?
估值锚点的迁移:从技术峰值到商业现实
2026年下半年的中国人工智能资本市场,正在经历一场静默却剧烈的逻辑重构。过去半年间,大模型公司的股价走势与模型发布的关联度极高,市场习惯于将“单任务性能第一”或“榜单排名跃升”直接等同于估值溢价。然而,随着7月以来一系列市场事件的发酵,这种线性对应的关系正在断裂。市场不再盲目为单一的“最强模型”买单,而是开始冷静地审视技术领先背后的商业可持续性、生态成本结构以及差异化竞争能力。
这一转变的标志性节点,或许可以追溯到智谱与MiniMax解禁前后的市场反应。在此之前,智谱凭借GLM-5及GLM-5.2的连续发布,一度构建了“模型即估值”的完美叙事。数据显示,GLM-5发布当日智谱股价上涨近29%,T+3累计涨幅超过130%;GLM-5.2发布后,其AA智能指数突破51分,市值一度突破万亿港元。市场当时的逻辑非常清晰:模型能力提升带来排名跃升,排名跃升支撑API涨价,涨价后的调用量增长验证了定价权。这是一套纯模型公司最容易获得估值溢价的闭环逻辑。
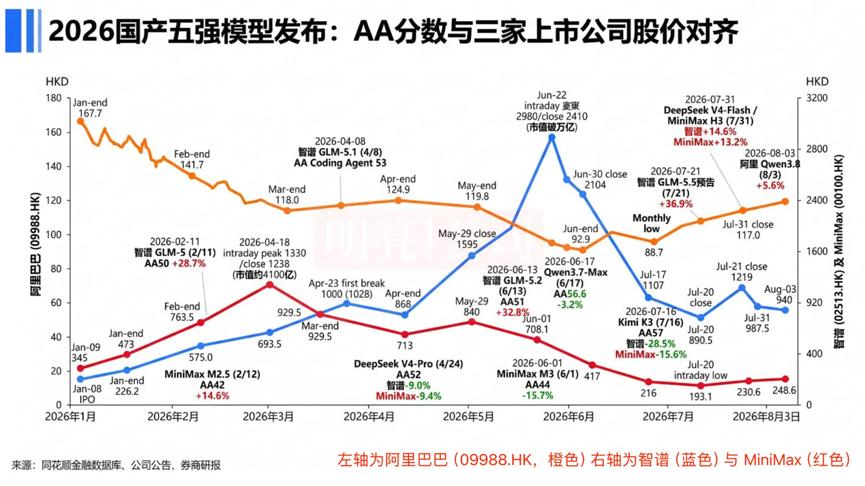
然而,这套逻辑在7月之后遭遇了严峻挑战。Kimi K3的发布导致智谱股价在两日内暴跌42.47%,MiniMax同期下跌约24.57%。尽管两周后DeepSeek V4 Flash和MiniMax H3的发布又引发了板块反弹,但两次截然不同的市场反应揭示了一个核心事实:市场对“SOTA”(State of the Art,最先进)的定义和理解已经发生了根本性变化。单一的性能领先,已不再是估值的充分条件,甚至不再是必要条件。
SOTA窗口的极速缩短与交易信号化
造成这一变化的首要原因,是模型迭代周期的急剧压缩。BenchLM统计数据显示,过去12个月共有107个显著模型发布,平均约3天一个。进入2026年下半年,前沿模型的发布周期已缩短至1至2周。在这种高频迭代下,任何一家公司都难以长期独占“最强”头衔。SOTA不再是一个长期的护城河,而变成了一个短期的交易信号。
资本市场对SOTA的反应机制也随之改变。过去,模型登顶后,市场会给予长达数月甚至半年的估值溢价。现在,只要新模型足以改变排序预期,或者削弱原SOTA公司的领先假设,股价就会提前调整。例如,Kimi K3发布后,智谱此前依靠GLM-5.2建立的“国产最强开源模型”叙事被迅速削弱,市场立即通过股价下跌来重新定价。这种“排序重排”式的反应,使得单次模型发布的边际效用递减。
更深层的变化在于,市场开始区分“技术领先”与“商业领先”。MiniMax早期的M2.5版本虽然AA指数仅为42分,排名靠后,但凭借SWE-bench的优异表现和OpenRouter的高调用量,市场接受了“榜单弱、调用强”的商业化叙事,股价随之上涨。然而,当M3版本发布时,尽管具备1M上下文和自研架构,但因AA指数仅为44分且定价提升缺乏数据支撑,市场将其视为估值兑现窗口而非能力突破,导致股价高开低走。这表明,市场不再迷信参数和榜单,而是更看重模型在真实场景中的调用粘性和定价权。
生态成本基准与差异化叙事的重构
7月31日DeepSeek V4 Flash的发布,是估值逻辑重构的另一个关键转折点。Artificial Analysis指出,该版本被认为是目前单任务成本最低的模型,比Anthropic的Fable 5便宜105倍。这一发布并未引发像Kimi K3那样的恐慌性下跌,反而带动了智谱、MiniMax和阿里巴巴的股价同步上涨。
这一反常现象背后的逻辑在于,市场将DeepSeek V4 Flash重新定义为“国产开源生态的成本基准和能力下限”。当基础模型的成本大幅下降时,所有基于开源生态构建的公司都受益于基础设施成本的降低。这种“生态框架定价”取代了“零和博弈定价”。市场意识到,在成本基准下移的环境中,竞争焦点从“谁更便宜”转向了“谁能在低成本基础上提供更高的附加值”。
与此同时,差异化叙事成为新的估值支撑点。MiniMax在7月31日发布的H3视频生成模型,虽然并非全面领先,但作为首款开源多模态生成模型,其在AA视频编辑榜上的全球第一表现,回应了市场对多模态叙事是否结束的质疑。H3以0.8元/秒的低价开源,重新提供了一个可讨论的估值锚。MiniMax股价当日上涨13.15%,这并非因为技术全面超越,而是因为其在多模态领域的差异化配置逻辑得到了市场认可。这表明,在基础大模型趋于同质化的背景下,垂直领域或多模态能力的差异化,成为维持估值溢价的关键。
平台型公司与纯模型公司的估值分化
在SOTA叙事降权的背景下,不同类型的模型公司呈现出截然不同的估值路径。阿里巴巴的Qwen系列模型迭代频率高,技术能力稳居第一梯队,但其股价很少由单一模型发布直接决定。6月Qwen 3.7-Max发布时,尽管AA分数达到56.6分,阿里美股当日反而下跌3.18%。这是因为阿里的估值变量更加多元,包括阿里云收入、MaaS平台规模、资本开支、AI应用分发以及集团基本面。平台型公司依靠云收入、MaaS调用和生态合作来承接模型能力,而不是依赖模型榜单本身。这种估值逻辑更加稳健,但也缺乏短期爆发力。
相比之下,纯模型公司如智谱和MiniMax,其估值对模型发布的敏感度极高。智谱在7月解禁比例约5.76%时,股价仍能上涨,说明市场当时仍认可其持续交付能力。然而,随着解禁压力和多模态叙事降温,单一模型的性能已无法对抗筹码供给和估值回归的压力。7月21日,摩根大通将智谱目标价从2400港元下调至1600港元,降幅约33%,但仍维持“增持”评级。这一动作明确传递出信号:卖方并未否定公司本身,而是在下调市场愿意为单一领先性支付的估值倍数。
长期估值的新锚点:路线图与商业闭环
随着SOTA窗口期的缩短,资本市场对模型公司的评估维度正在从“技术峰值”向“商业闭环”迁移。市场开始追问模型能力之外的商业价值,包括迭代速度、收入增速、价格弹性以及长期的商业模式。一个公司如果只有一次登顶,却没有持续迭代能力、调用量增长、客户留存和收入转化,那么SOTA带来的估值溢价很快会被下一次发布稀释。
在通往AGI的终点路上,清晰的“路线图”成为掌握叙事话语权的关键。这不仅仅指技术路线图,更包括商业化路线图。市场需要看到模型能力如何转化为实际的收入增长,如何通过生态合作扩大护城河,如何在成本下降的环境中保持利润率。对于国内几家开源模型公司而言,资本市场似乎已经开始从中观层面对标北美市场,大语言模型的市场正在“缩圈”,从“三巨头”走向“双寡头”。在这一语境下,一款在短期内评分排名靠前的模型,并不是能够留在圈里的充分条件。
未来,能够持续提供稳定性能、拥有强大生态整合能力、并具备清晰商业化路径的公司,才能获得长期的估值支撑。单纯依靠模型性能领先的时代正在过去,一个更加理性、更加注重商业本质的估值新周期已经到来。对于投资者而言,理解这一逻辑转变,比追逐每一个SOTA发布更为重要。