国产算力破局:超节点架构如何重塑AI基础设施竞争格局
在人工智能技术飞速演进的当下,算力已不再仅仅是支撑模型运行的基础资源,而是决定产业竞争力的核心战略要素。近期,随着GLM 5.2、Kimi K3.0等国产头部大模型的密集发布,以及DeepSeek相关技术细节的市场热议,行业内部对于算力紧张的焦虑感再度升温。这一现象揭示了一个被暂时掩盖的事实:尽管算法优化在一定程度上缓解了单次推理的压力,但面对日益复杂的应用场景和海量的用户并发,国产大模型要想真正跻身国际第一梯队,必须跨越一道难以绕过的算力门槛。
过去一段时间,业界曾普遍信奉“力大飞砖”的逻辑,试图通过单纯增加硬件投入来解决性能问题。然而,受限于供应链和技术壁垒,这条路径在国内走得并不顺畅。DeepSeek的出现曾带来一丝曙光,其通过混合专家(MoE)架构、注意力机制优化以及开源垂直模型等手段,显著降低了对算力的依赖,使得“花小钱办大事”成为可能。这种技术减负的策略,一度让市场认为可以通过软件层面的创新来抵消硬件层面的不足,从而消除算力溢价。
然而,现实很快给出了不同的答案。随着国产大模型能力的跃升,其应用场景从简单的问答扩展至长程编程、智能体(Agent)任务执行等复杂领域。以Kimi K3为例,虽然其通过稀疏激活技术将单次推理的参数规模控制在较低水平,但一旦进入实际业务流,一个用户请求背后可能隐藏着数十次的代码读取、工具调用和自我纠错过程。这种后台的高频交互导致Token总吞吐量激增,进而推高了对整体算力的需求。这正是经济学中“杰文斯悖论”的典型体现:技术进步提高了资源利用效率,反而刺激了需求的爆发式增长,最终导致资源总消耗量的增加。
面对这一困境,单纯依靠算法优化已无法满足全负荷工作下的算力缺口,基础设施的扩容成为必由之路。数据显示,2026年上半年国内智能算力规模已达2185 EFLOPS,同比增长177%,呈现出爆发式增长态势。在这一背景下,国产AI芯片厂商纷纷走上舞台中央,昆仑芯发布的第四代AI芯片M100针对大规模推理场景进行了深度优化,平头哥推出的真武M890则在性能上实现了三倍提升,这些进展为国产算力提供了坚实的硬件基础。
然而,硬件性能的突破并非终点,如何将这些分散的算力单元高效整合,成为新的技术焦点。此时,“超节点”概念应运而生,并迅速成为国产算力破局的关键抓手。超节点并非简单的芯片堆叠,而是将数张乃至数百张AI芯片通过高带宽、低时延的互联技术融为一体,形成一个具备超级计算机特征的完整计算系统。这种架构的核心价值在于,它能够通过软硬协同的方式,最大程度地减少数据同步带来的等待时间,将理论上的峰值算力转化为实际可用的有效算力。
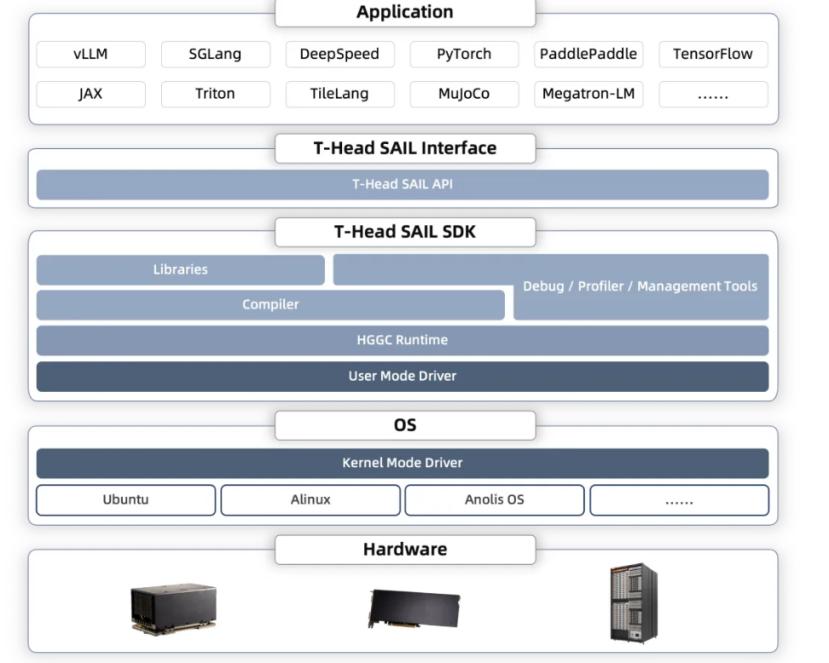
在万亿参数的大模型训练中,尤其是采用MoE架构时,不同专家网络之间的频繁通信对互联带宽提出了极高要求。如果互联带宽不足,即使单个GPU的计算能力再强,也会因为等待数据同步而处于闲置状态,造成巨大的资源浪费。超节点通过构建统一的内存编址空间和高效的通信协议,显著降低了这种“通信墙”效应,从而大幅提升了集群的整体效率,并有效降低了每个Token的计算成本。
目前,围绕超节点的构建,行业内形成了两种截然不同的技术路线。一种是以华为昇腾为代表的“大规模集群”派,主张节点越大越好。随着模型参数规模的扩大和上下文长度的突破,只有百卡、千卡甚至万卡级别的超节点才能满足全场景的需求。昇腾推出的384卡超节点已实现规模化销售,并正在向1024卡乃至8192卡的超大规模节点演进,旨在探索物理节点内存统一编址的技术上限,以应对极端复杂的计算任务。
另一种则是以浪潮信息为代表的“经济性节点”派,主张在性能与成本之间寻求最佳平衡。他们认为,对于大多数中小企业而言,过大的节点规模不仅成本高昂,还可能导致算力闲置。因此,浪潮信息推出了64卡乃至32卡的超节点产品,旨在让更多企业能够以较低的门槛使用万亿参数大模型。这种小节点策略强调灵活性和性价比,试图通过降低初始投入来加速AI技术在垂直行业的普及。
这两种路线的分歧,本质上是对市场需求分层的不同回应。大规模超节点更适合头部互联网企业和科研机构,用于训练基础大模型和处理海量并发请求;而小规模超节点则更契合传统行业数字化转型的需求,能够在控制成本的前提下实现智能化升级。无论哪种路线,超节点的出现都标志着国产算力竞争已从单一的芯片性能比拼,转向了系统级架构优化的深层较量。
值得注意的是,超节点技术的成熟离不开生态系统的协同支持。百度、阿里巴巴、沐曦科技、摩尔线程等企业纷纷入局,不仅在硬件层面提供多样化的选择,还在软件栈、开发工具和云服务平台上进行深度整合。这种全方位的生态建设,有助于打破国外高端芯片的技术垄断,为国产AI基础设施注入新的活力。
从长远来看,超节点将成为连接底层硬件与上层应用的关键枢纽。它不仅解决了当前算力紧张的问题,更为未来更大规模、更复杂的人工智能应用奠定了坚实基础。随着技术的不断迭代,超节点的能效比、稳定性和易用性将进一步提升,推动国产算力从“可用”向“好用”转变。
在这个过程中,我们需要清醒地认识到,算力破局并非一蹴而就。它需要芯片制造商、服务器厂商、云服务商以及算法开发者的共同努力,需要在标准制定、接口兼容、软件优化等方面达成广泛共识。只有这样,才能真正释放出超节点的潜力,让国产算力在全球竞争中占据有利地位。
此外,超节点的发展也将对能源消耗提出新的挑战。随着集群规模的扩大,功耗和散热问题日益凸显。未来的超节点设计必须更加注重绿色节能,通过液冷技术、智能调度算法等手段,降低单位算力的能耗,实现可持续发展。这不仅是技术问题,更是社会责任。
综上所述,国产算力的破局之路,关键在于超节点架构的创新与应用。它既是应对杰文斯悖论的有效手段,也是提升国产AI核心竞争力的战略支点。在大模型时代,谁能够打造出更高效、更经济、更稳定的超节点系统,谁就能掌握人工智能发展的主动权。这场关于算力的竞赛,才刚刚进入深水区,而超节点无疑是决定胜负的关键手。