Const成员函数为何需线程安全?揭秘mutable与同步机制的深层博弈
重新审视Const成员函数的线程安全假设
在传统的C++编程思维中,const成员函数往往被等同于“只读操作”,进而被默认认为是线程安全的。这种直觉来源于“位常量性”(Bitwise Constness)的概念,即编译器保证函数内部不会改变对象中任何比特的值。然而,在现代高并发软件架构中,这一假设正逐渐失效。我们需要引入更深刻的“逻辑常量性”(Logical Constness)视角,来审视那些为了实现缓存、统计或懒加载等功能而修改内部辅助状态的const成员函数。
当const成员函数内部存在修改逻辑时,线程安全问题便从代码静态分析转向了运行时状态。如果多个线程同时访问同一个对象的同一个const成员函数,且该函数内部依赖mutable修饰的辅助成员变量进行状态维护,那么未加同步的保护机制将直接导致数据竞争。这不仅是编译器的语法约束问题,更是并发控制中的核心工程挑战。理解这一界限,是构建健壮多线程系统的第一步。
互斥量:多变量协同同步的基石
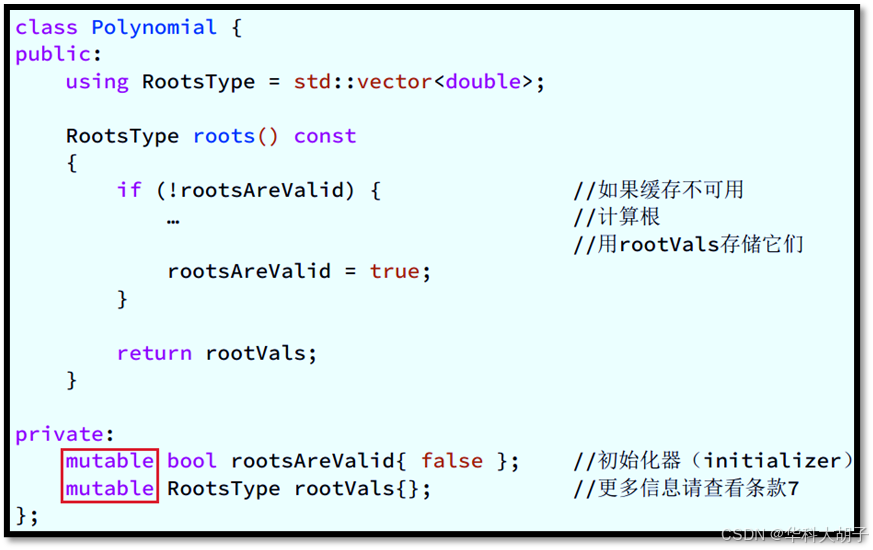
以“多项式求根”为例,我们可以清晰地看到缓存机制与线程安全之间的张力。假设有一个Polynomial类,其核心数据是系数向量,而roots()函数负责计算多项式的根。由于计算成本高昂,我们期望在首次计算后缓存结果。为了实现这一目标,我们需要引入两个mutable成员变量:一个是布尔标志rootsAreValid,用于指示缓存是否有效;另一个是向量rootVals,用于存储计算结果。
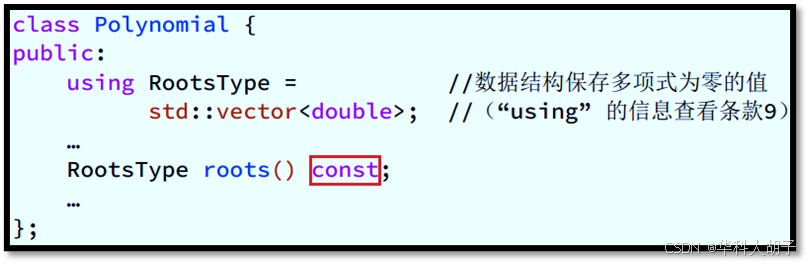
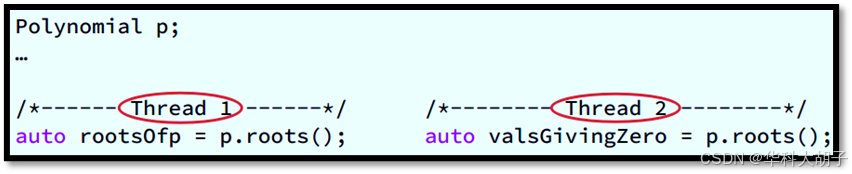
在这种设计下,roots()函数虽然被声明为const,但它实际上修改了对象的状态——更准确地说,是修改了那些不参与对象数学语义但影响对象性能行为的内部状态。当线程A检测到rootsAreValid为false并准备计算时,如果线程B同时也进入该函数,两者可能同时启动昂贵的计算过程,或者在写入rootVals时发生覆盖,导致不可预知的结果。这就是典型的数据竞争。
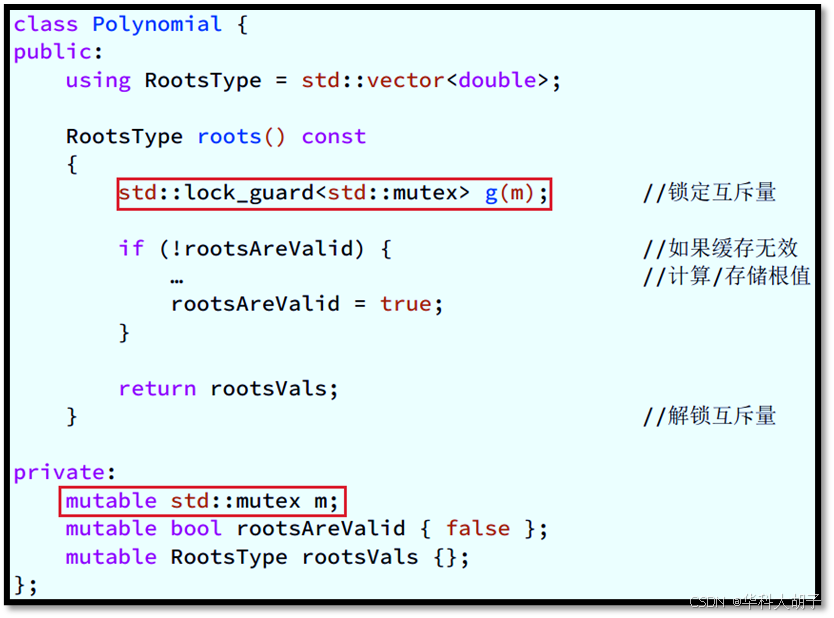
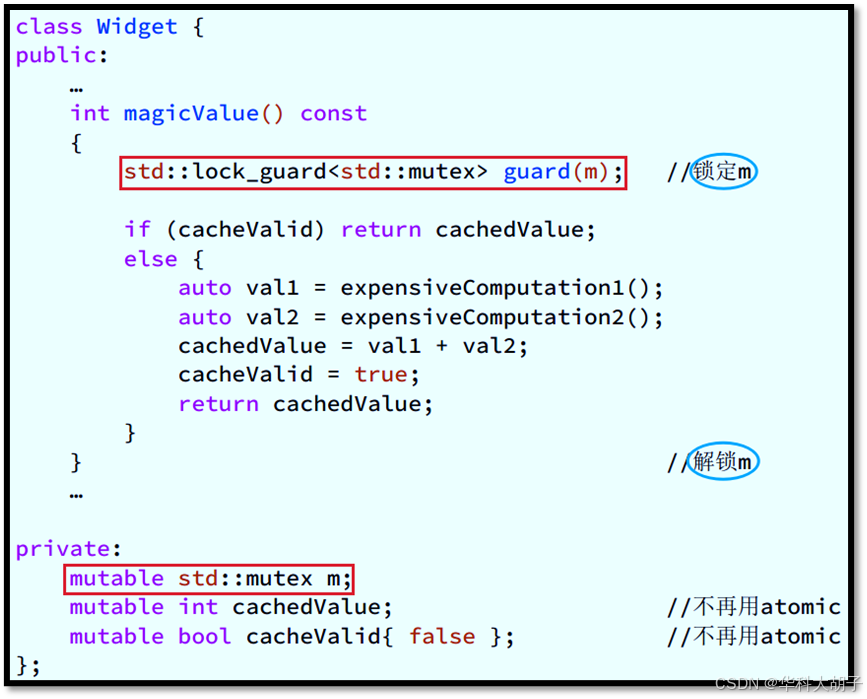
解决这一问题的标准方案是引入std::mutex。通过在roots()函数中使用std::lock_guard自动管理锁的生命周期,我们可以确保对rootsAreValid和rootVals的读写操作是原子的。一旦进入临界区,其他线程将被阻塞,直到当前线程完成计算并更新缓存。这种方案虽然引入了轻微的同步开销,但保证了数据的一致性。值得注意的是,由于std::mutex是不可拷贝的,这会导致整个Polynomial类也失去拷贝构造和拷贝赋值的能力,只能支持移动语义。这在某些需要频繁拷贝对象的算法中可能会带来适配成本。
原子变量:单变量同步的高效利器
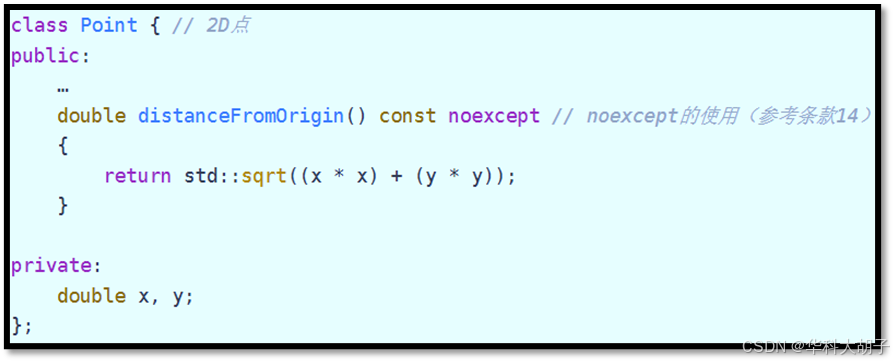
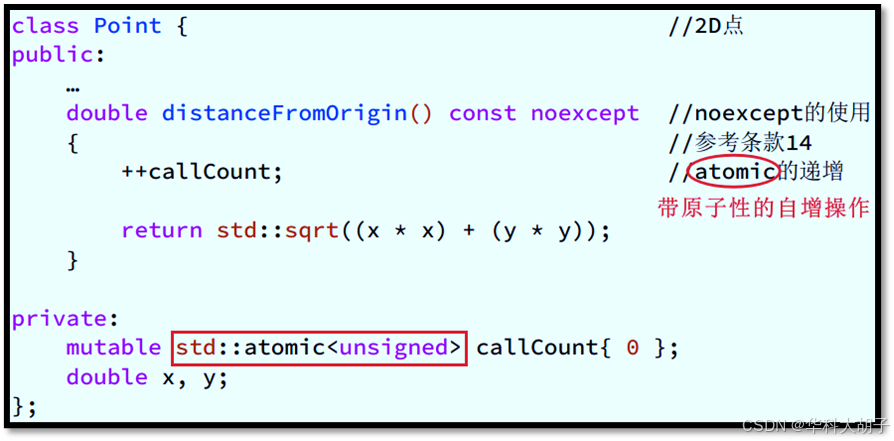
与互斥量处理复杂状态不同,原子变量std::atomic专为单个内存位置的无锁同步而设计。考虑一个统计函数调用次数的场景:Point类的distanceFromOrigin()函数每次被调用时,需要将内部计数器callCount加一。这里的“状态”仅涉及一个整型变量。
如果使用互斥量来保护这个简单的计数器,无疑是“杀鸡用牛刀”。互斥量通常涉及系统调用或复杂的内核态切换,开销远大于一次简单的内存读写。此时,std::atomic提供了更优的解决方案。通过声明mutable std::atomic
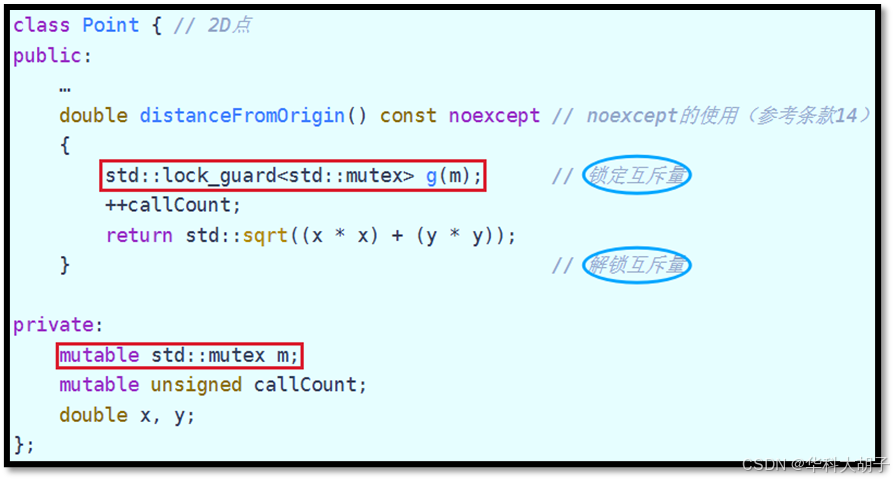
原子变量的优势在于其极低的延迟和高并发下的可扩展性。然而,它同样带来了类不可拷贝的后果。std::atomic实例也是移动-only的,这意味着Point类同样失去了拷贝能力。在实际工程中,这种副作用需要被纳入类设计的考量范围。如果类必须保留拷贝语义,开发者可能需要重新评估是否真的需要在线程安全的const函数中维护状态,或者通过外部同步机制来规避。
原子操作的陷阱与局限
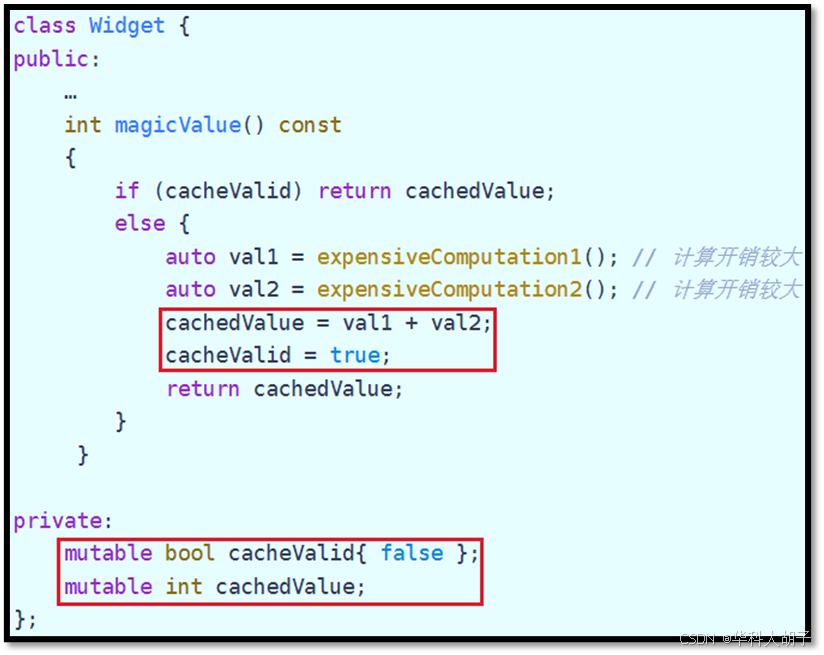
尽管std::atomic性能优异,但它并非万能药。一个常见的误区是试图用一对原子变量来模拟互斥量的逻辑,例如用cacheValid和cachedValue两个原子变量来实现缓存。这种设计在单变量检查时看似完美,但在多变量协同更新时却极易陷入逻辑陷阱。
考虑以下并发场景:线程A检测到缓存无效,开始执行计算;与此同时,线程B也检测到缓存无效。由于原子操作的独立性,线程B可能在线程A尚未完成计算并将结果写入cachedValue时,就已经将cacheValid标记为true。或者,如果交换写入顺序,线程B可能在读取到cacheValid为true后,直接读取尚未更新的cachedValue,从而返回一个垃圾值或旧数据。这种现象被称为“ABA问题”的变体或简单的逻辑竞态,单纯依靠原子类型无法解决。
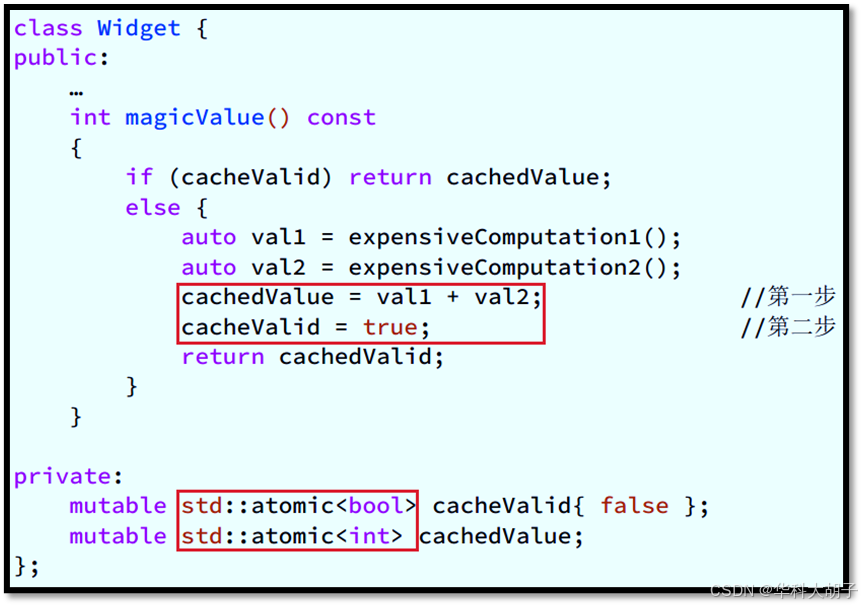
这揭示了一个重要的工程原则:原子变量适用于单一内存位置的同步,而当需要同步两个或多个相关联的数据时,必须回归到互斥量或其他高级同步原语。互斥量不仅保证了数据的原子性更新,还建立了内存屏障,确保了指令重排不会破坏逻辑一致性。因此,在设计并发组件时,切勿因为追求性能而盲目堆砌原子操作,忽视了数据之间的语义关联。
性能权衡与架构决策
在实际开发中,选择互斥量还是原子变量,往往取决于具体的业务场景和性能要求。一般来说,互斥量的开销高于原子操作,但其提供的临界区保护更强大、逻辑更清晰。对于简单的计数、标志位检查等单变量场景,std::atomic是首选。对于涉及多个变量更新、复杂状态机转换或缓存一致性维护的场景,std::mutex是更可靠的选择。
此外,还需要考虑类的接口契约。引入同步机制会改变类的语义,使其从“可拷贝”变为“可移动”。在某些遗留系统或特定算法库中,这可能是一个Breaking Change。如果应用场景明确为单线程,或者对象生命周期极短且不会跨线程共享,那么完全可以在const函数中省略同步机制,以换取最佳的性能和最小的内存 footprint。
然而,随着并发编程范式的普及,真正能保证对象永不跨线程共享的场景正变得越来越少。大多数现代框架,尤其是涉及UI渲染、网络I/O或后台数据处理的应用,都默认运行在多线程环境中。因此,保守且稳健的做法是:默认假设const成员函数可能面临并发调用,并据此设计线程安全的实现。这种防御性编程策略,虽然在初期增加了少许复杂性,但能极大降低后期维护中的调试难度和潜在的系统崩溃风险。
综上所述,保证const成员函数的线程安全,并非简单的语法要求,而是对数据一致性、性能损耗和类设计语义的综合平衡。开发者需要深刻理解mutable、互斥量和原子量的底层机理,根据具体需求灵活选型,才能在C++并发编程的深水区游刃有余。