AI数学奇点降临?OpenAI与Anthropic的24小时攻防战启示录
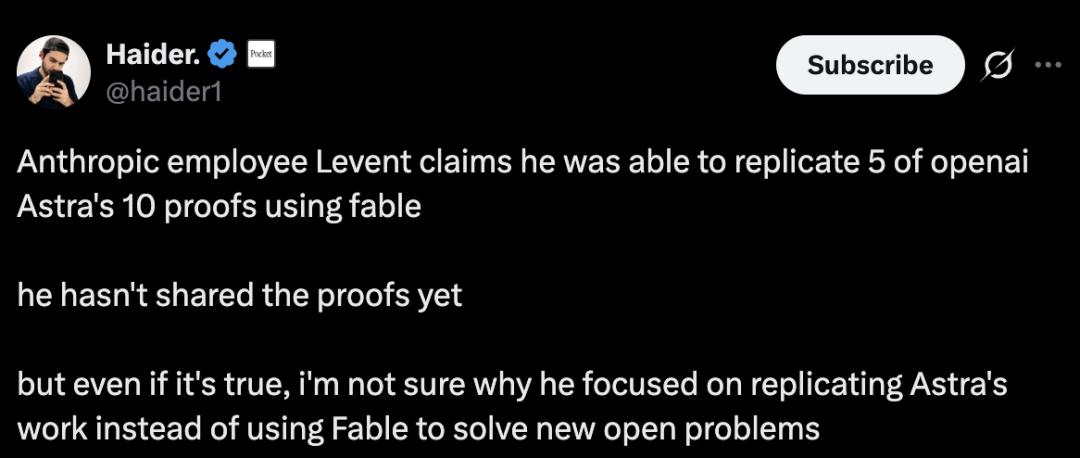
在这个被算法重新定义的周末,数学界经历了一场前所未有的地震。OpenAI研究员Sébastien Bubeck宣布,其内部未发布的下一代主力模型Astra,成功证明了10项长期悬而未决的前沿数学成果。这一消息尚未在学术界激起完整的涟漪,Anthropic的研究员Levent Alpöge便在不到24小时内回应,称其使用公开可用的模型Fable复现了其中5项难题的解法。这场看似简单的技术展示,实则揭示了人工智能在基础科学领域引发的深层范式转移:当“发现”变得廉价且迅速,“验证”便成为了新的瓶颈。
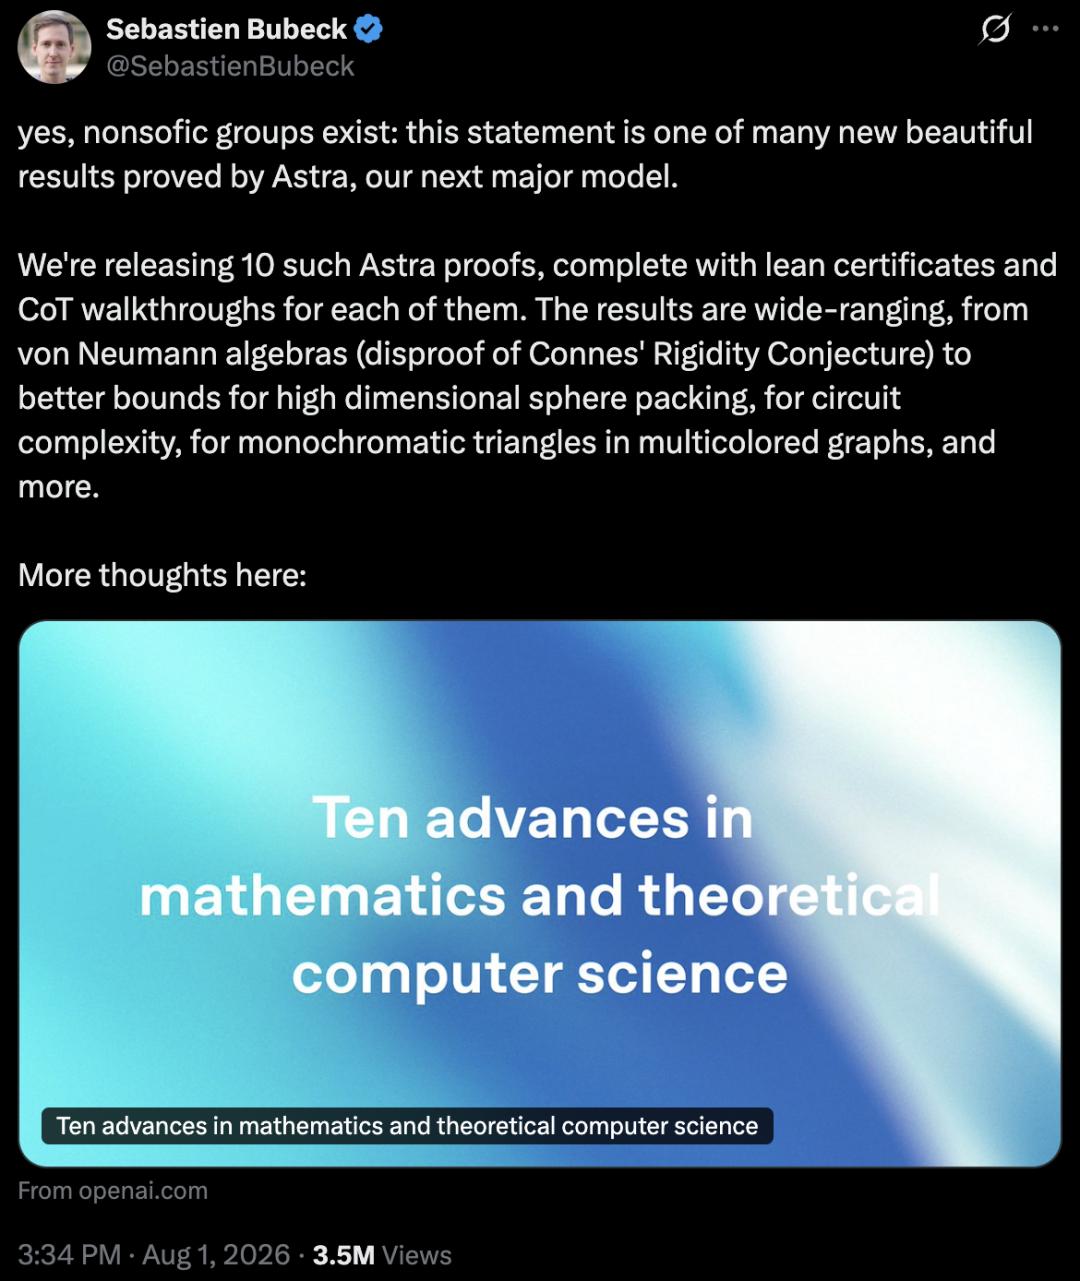
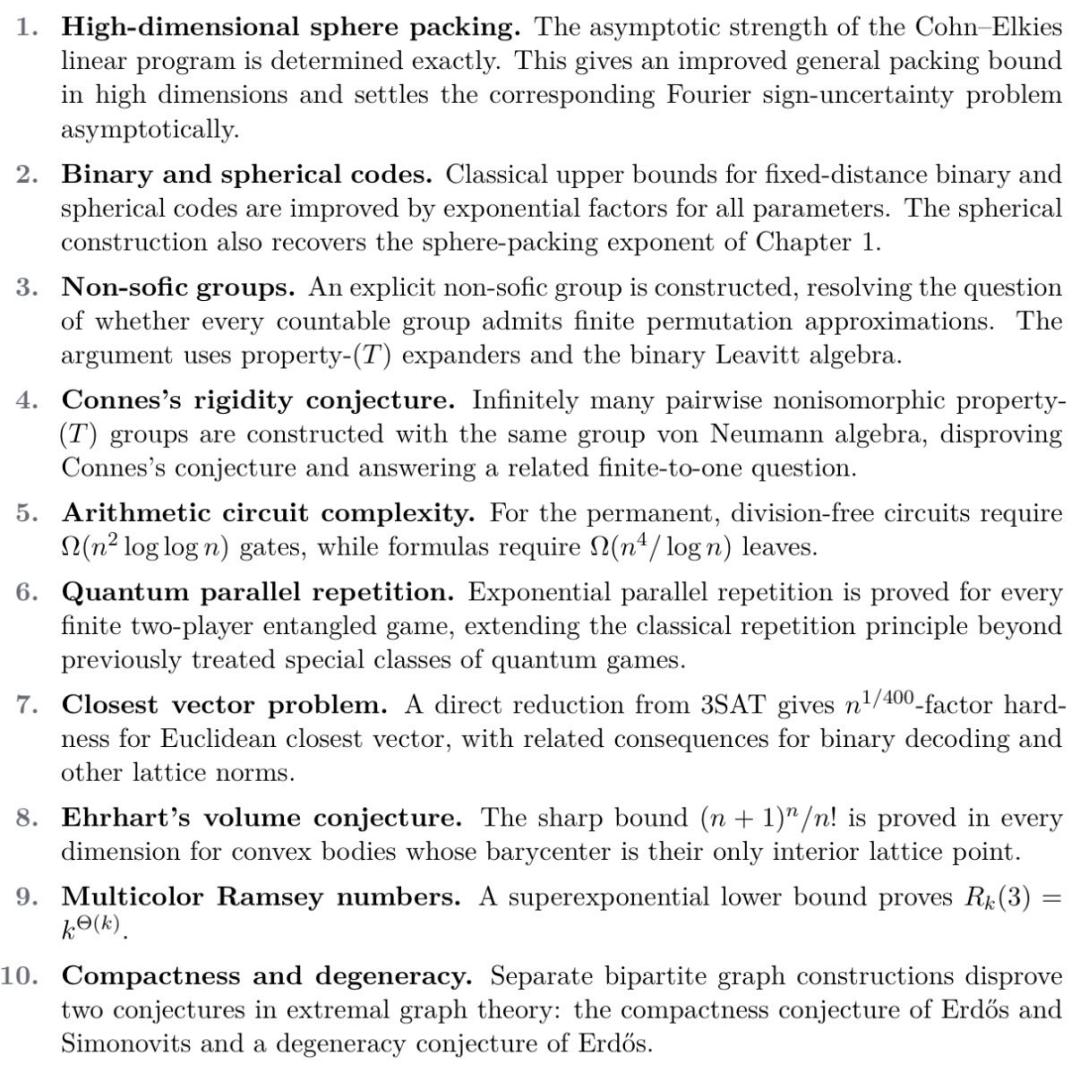
这10道被攻克的难题并非普通的教科书习题,而是数学前沿真正“难啃的硬骨头”。它们中的许多结论已经停滞了数十年,甚至超过十年无人推动。例如,涉及非索菲克群存在性的证明,被Epoch AI旗下FrontierMath负责人Elliot Glazer评价为足以刊登在《数学年刊》这样的顶级期刊上。这些成果的价值在于其深度和独立性,而非仅仅是计算量的堆砌。Astra不仅给出了答案,还生成了10份Lean证书以及详细的思路复盘,展示了其在逻辑推导上的严密性。然而,这种严密性在Fable的快速跟进面前,显得既辉煌又脆弱。
Fable的介入让这场竞赛的性质发生了根本变化。Levent Alpöge强调,他的实验环境是“干净”的:完全自主运行、使用通用提示词、全程无网络连接,并采取了严格的防泄漏措施以确保独立性。如果这一复现得到最终证实,那么OpenAI所抢占的“首发权”将失去其传统的历史重量。在过去,数学优先权的争夺往往以年为单位,涉及漫长的投稿、审稿和修改过程。而现在,这一周期被压缩到了24小时以内。首发的含金量依然存在,但其保质期却呈现出断崖式下跌。这意味着,未来的科学突破可能不再属于第一个提出者,而是属于第一个被广泛验证者。
关于成本的讨论同样引人深思。OpenAI透露,找到这10项解法的边际推理成本不到2000美元。这一数字是基于成功跑出解法所需的Token数量,并按Sol API价格折算得出的。然而,这只是一个极具误导性的表面数字。它忽略了Astra模型本身巨大的训练研发成本、那些尝试失败的问题所消耗的资源、人类研究人员将论证整理成249页论文的巨大工时,以及将每个证明形式化为Lean代码的高昂人力投入。更重要的是,它还排除了外部数学家进行审查的成本。尽管如此,2000美元这个数字依然具有象征意义,它将AI解决一道前沿难题的边际成本打到了地板价,引发了关于未来科研经济学的无限遐想。
这种低成本、高效率的证明生成能力,正在重塑我们对“刷榜”行为的理解。传统的AI基准测试通常基于已知答案的题目,比拼的是准确率。而此次Astra与Fable的互动,更像是一场实时的、去中心化的同行评审。两个模型在无网络、防泄漏的条件下,各自独立抵达同一个前沿结论,这测试的不是记忆或检索能力,而是真正的推理可靠性和可复现性。Levent此前曾利用Fable给出Jacobian猜想的三维反例,并经过代数验证确认,这证明Fable并非仅仅是在蹭热度,而是具备解决全新开放问题的能力。这种从“互相刷榜”到“互相验货”的转变,标志着AI在科学探索中的角色从工具向合作者的演进。
然而,随之而来的是一个更为严峻的问题:绝大多数人,包括许多专业数学家,都难以在短时间内理解这些由AI生成的深奥证明。宾夕法尼亚大学教授Ethan Mollick指出,对于地球上几乎每一个人来说,这些成果不仅超出能力范围,更超出理解范围。我们只能依赖少数专家来判断其价值。这与代码、图像或文本生成不同,后者普通人尚可通过直观体验来评估AI的能力。而在高等数学、理论物理等前沿领域,公众乃至大部分科研人员对AI的信任,建立在一条漫长而脆弱的信任链之上。当AI的能力越往科学前沿延伸,这种“连惊叹都无从惊叹”的状态就越发普遍。
数学家Thomas Bloom提出了一个关键的评判标准:这份证明是否教给我们关于这个问题的新东西?如果AI只是通过暴力搜索或模式匹配找到了一个已有的路径,而没有提供新的洞察或方法论,那么其科学价值将大打折扣。简单地将此描述为“AI取代数学家”是不诚实的,因为这些成果依赖于上百年来数学家积累的理论框架和亲手搭建的形式化系统。AI是在巨人的肩膀上进行高速奔跑,而非凭空创造。因此,衡量AI成果的真实价值,不应仅看其产出端的速度,更应看其验收端的深度。
在这种背景下,最稀缺的能力正在从“做出证明”转向“看懂并验收证明”。当AI能够一夜之间证出十道难题,人类的验证能力是否还能跟上?这不仅是一个技术问题,更是一个社会学和教育学问题。我们需要培养更多能够理解、审查和整合AI生成内容的专家。同时,科学共同体需要建立新的验证机制,以应对海量、快速产生的AI辅助证明。这可能包括开发更先进的自动化工具来辅助人类审查,或者改变学术出版的流程,使其更能适应这种高速迭代的知识生产模式。
此外,这场竞赛也暴露了开源与闭源模型之间的微妙关系。OpenAI的Astra作为未发布模型,代表了闭源巨头在算力与算法上的极致优化;而Anthropic的Fable作为公开可用模型,则展示了开源生态在复现和验证方面的强大潜力。Fable能够在24小时内复现一半的成果,说明在基础推理能力上,公开模型与顶尖闭源模型之间的差距正在缩小。这种竞争格局有利于科学知识的快速传播和验证,但也可能加剧巨头之间的军备竞赛,导致资源进一步向少数几家大公司集中。
展望未来,我们可能会看到更多类似的“闪电战”。AI不仅在数学领域,可能在材料科学、药物发现、气候建模等领域,都会以类似的方式加速突破。关键在于,我们如何构建一个能够容纳这种加速度的社会和技术基础设施。这需要政策制定者、科学家、技术人员和公众的共同努力。我们需要确保AI生成的科学知识是透明的、可验证的,并且最终服务于人类的福祉,而不是成为黑箱中的神秘产物。
在这场24小时的攻防战中,我们看到的不仅是技术的进步,更是人类认知边界的拓展与挑战。AI不再是简单的工具,它已成为科学探索中不可或缺的伙伴,甚至在某些时刻成为引领者。面对这一现实,我们既不必过度恐慌,也不应盲目乐观。唯有保持清醒的批判性思维,强化人类的验证与解读能力,才能在这场智能革命中掌握主动权。毕竟,证明可以自动生成,但意义的赋予,始终离不开人类的智慧与判断。