AI数学突破:24小时复现5题,验证能力成新瓶颈
在人工智能与基础科学交汇的最前沿,一场无声却剧烈的范式革命正在上演。过去,数学发现的优先权往往以年甚至十年为单位进行衡量,漫长的投稿、审稿与修改周期构成了学术发表的天然壁垒。然而,近期发生的一系列事件表明,这一传统时间尺度正在被AI技术彻底压缩。OpenAI研究员Sébastien Bubeck宣布,其未发布的下一代主力模型Astra成功证明了10项长期悬而未决的前沿数学成果,并提供了完整的Lean形式化证书及思路复盘。这10个问题并非普通的练习题,而是至少十年无人推动、部分搁置数十年的开放难题,其难度足以让任何一位职业数学家望而却步。
更具戏剧性的是,这一“首发”优势的保鲜期仅维持了不到24小时。Anthropic研究员Levent Alpöge迅速回应,称使用完全公开可用的模型Fable,在无网络、防泄漏的干净实验环境下,独立复现了其中5项成果。这一举动不仅验证了Astra解法的正确性,更揭示了一个令人深思的事实:顶尖AI模型的解题能力差距正在迅速缩小,而公开模型与闭源模型之间的界限在特定任务上变得模糊。当一项曾经需要数年攻坚的数学突破,能在一天内被另一个模型复现一半时,我们不得不重新审视“创新”与“验证”在AI时代的定义。
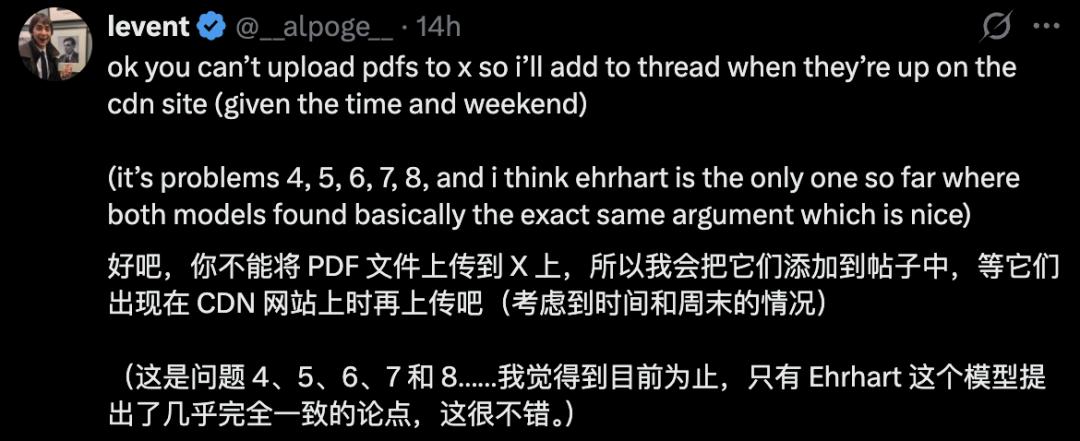
这次交锋的核心价值,不在于谁先解出题目,而在于它改变了科学发现的验证逻辑。传统的基准测试(Benchmark)往往基于已知答案,比拼的是准确率与速度,本质上是一种“刷榜”行为。而此次Astra与Fable的互动,更像是一场实时的、去中心化的同行评审。两个模型在隔离环境中独立抵达同一结论,这种双重确认极大地提高了结果的可信度。尽管Levent尚未公开完整的证明细节与运行日志,但此前Fable在Jacobian猜想三维反例上的表现已证明其具备解决全新开放问题的能力。这种从“单向输出”到“互相验货”的转变,标志着AI科研助手正从工具角色向合作者角色演进。
关于成本的讨论同样揭示了技术普及的潜在路径。OpenAI透露,寻找这10项解法的边际推理成本不足2000美元。这一数字仅涵盖了成功跑出解法所需的Token消耗,若按Sol API价格折算,其低廉程度令人咋舌。当然,这背后隐藏着巨大的沉没成本,包括Astra模型的训练研发、大量失败尝试的计算资源、人类专家将论证整理为249页论文的工时,以及将自然语言证明形式化为Lean代码的高昂人力投入。尽管如此,2000美元的边际成本依然是一个里程碑,它意味着解决一道前沿数学难题的经济门槛已被击穿。未来,随着模型效率的提升,这种低成本批量生产数学证明的能力可能会成为常态,进而引发科研产出模式的根本性变革。
然而,技术的狂飙突进也带来了深刻的认知危机。对于绝大多数公众乃至非相关领域的学者而言,这些由AI生成的证明如同天书。无论是非索菲克群的存在性证明,还是Connes刚性猜想的反例,其复杂性远超普通人的理解范畴。Ethan Mollick指出,我们正处于一种“连惊叹都无从惊叹”的状态,只能依赖极少数专家构建的信任链来判断成果的价值。这种信任链的延长,使得科学知识的传播与接受变得更加脆弱。当AI能够低成本、批量化地生产前沿证明时,公众和部分研究者失去了直接体验与验证的能力,转而完全依赖于权威机构的背书。
在这种背景下,数学家的角色正在发生微妙而深刻的转变。Thomas Bloom等学者强调,简单地将此解读为“AI取代数学家”是不诚实且片面的。真正的挑战在于,这份证明是否教给了我们关于该问题的新见解?如果AI只是通过暴力搜索或模式匹配给出了一个正确的但晦涩难懂的证明,其科学价值可能大打折扣。相反,如果证明过程能揭示新的结构或联系,那才是人类智慧的延伸。因此,评估AI成果的标准,正从“是否正确”转向“是否可理解”和“是否有启发性”。
这也引出了当前最紧迫的问题:验证能力的滞后。当AI生成证明的速度呈指数级增长,而人类阅读、核对和理解这些证明的速度却受限于生理与认知极限时,瓶颈便出现了。最稀缺的资源不再是解题算力,而是能够读懂并验收这些高维数学结构的人类专家时间。这种供需失衡可能导致大量有价值的数学成果被积压,或者因缺乏足够的人力审查而被误判。此外,形式化系统本身也是数学家百年积累的产物,AI是在既有框架内进行演绎,而非创造全新的数学范式。因此,AI目前更多是作为强大的加速器,而非独立的创造主体。
从更宏观的视角来看,这一事件预示着科学研究范式的全面转型。未来的科研流程可能不再是线性的“假设-实验-结论”,而是循环的“AI生成-人类筛选-形式化验证-新假设生成”。在这个过程中,人类专家的核心竞争力将集中在提出好问题、设计验证框架以及解读结果的深层意义上。对于教育体系而言,培养具备跨学科验证能力、能够驾驭形式化语言的人才变得至关重要。我们需要培养的不再是只会计算的学生,而是能够与AI协作、具备批判性思维的科学鉴赏家。
此外,开源与闭源模型的博弈也为科研生态带来了新的变量。Fable作为公开模型,能够在短时间内复现闭源模型Astra的部分成果,这表明基础能力的扩散速度远超预期。这对于促进科学民主化具有积极意义,但也引发了关于技术垄断与安全边界的讨论。如果最前沿的数学突破可以轻易被复现,那么保持技术领先的优势窗口期将越来越短。科研机构和企业可能需要重新思考知识产权的保护策略,以及如何在开放合作与竞争保密之间找到平衡点。
值得注意的是,尽管AI在特定领域表现出色,但其局限性依然明显。Noam Brown承认,Astra并未攻克任何千禧年大奖难题,且在许多其他重大问题上遭遇失败。这说明当前的AI系统仍缺乏真正的通用推理能力,其成功高度依赖于特定的提示工程、形式化环境以及问题本身的结构性特征。对于那些缺乏清晰形式化定义、需要直觉跳跃或创造性思维的数学问题,AI依然显得力不从心。因此,盲目乐观地宣称“数学奇点”到来为时过早,我们仍处于弱人工智能向强人工智能过渡的漫长隧道中。
综上所述,OpenAI与Anthropic的这次“数学对决”,不仅是两家科技巨头技术实力的展示,更是整个科学界面临的一次集体反思。它迫使我们回答:在算法日益强大的今天,人类智力的独特价值究竟何在?答案或许在于,我们不仅是知识的消费者,更是意义的赋予者。AI可以提供无数条通往真理的路径,但只有人类才能决定哪一条路径值得行走,以及沿途的风景意味着什么。随着验证成为新的瓶颈,建立高效的人机协同验证机制,将成为未来十年科学发展的关键议题。这不仅关乎数学,更关乎所有依赖复杂逻辑推演的学科未来。