超越逐帧预测:ODEWorld如何用连续时间重塑具身智能未来?
在具身智能的探索历程中,机器人对物理世界的理解往往被困在“帧”的牢笼里。当我们谈论视觉世界模型时,通常预设了一个前提:世界是由一系列离散的快照组成的。模型学习如何从第t帧跳转到第t+1帧。然而,现实世界的物理过程是连续的。想象一个机器人抓取一只滑腻的虾并放入锅中,真正的挑战不在于识别物体或路径规划,而在于对夹爪闭合力度、方向的毫秒级精细控制。如果模型只能看到离散的瞬间,它便无法理解两帧之间那个决定成败的连续动力学过程。这种离散性不仅限制了推理的灵活性,更在本质上偏离了物理世界连续演化的真实属性。
针对这一根本性缺陷,清华大学智能产业研究院(AIR)与UC Berkeley BAIR联合团队提出了ODEWorld,全球首个连续时间具身世界模型。这项工作并非简单地在现有框架上增加补帧功能,而是重构了世界模型对时间的认知方式。它不再询问“下一帧是什么”,而是学习“世界在每一时刻如何变化”。通过引入Physical-Time Flow(PT-Flow)范式,ODEWorld直接在潜空间中构建速度场,利用常微分方程(ODE)求解器来积分得到随真实物理时间连续演化的状态轨迹。这种转变使得模型能够任意插值时间,无论是加速、减速还是逆向回放,都成为同一条连续轨迹的自然衍生能力。
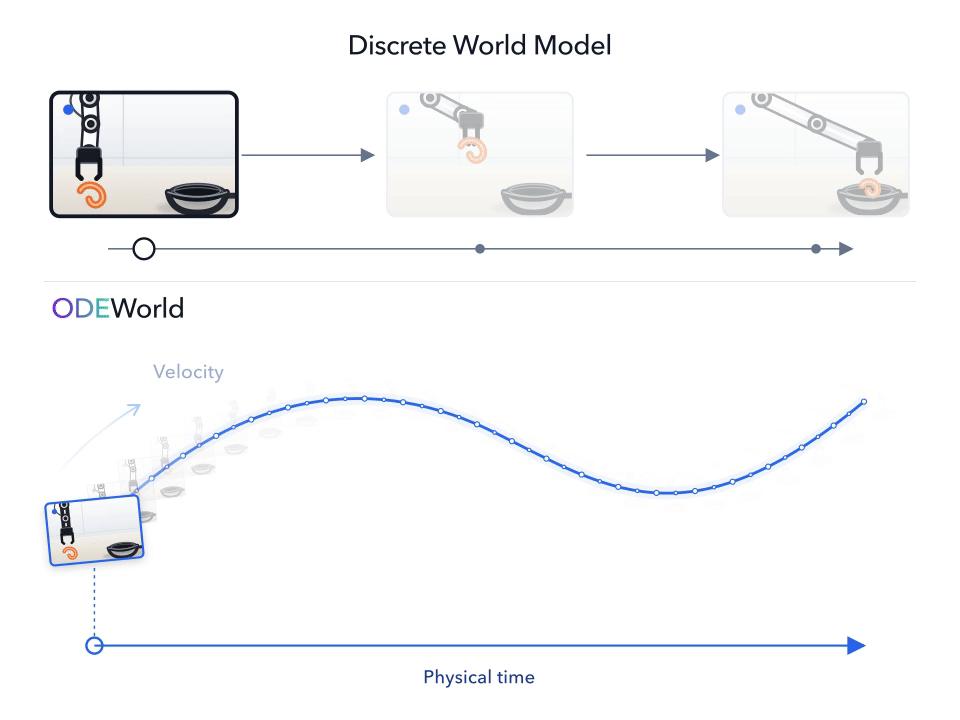
离散模型的核心痛点在于其预测能力被严格绑定在预定义的采样频率上。传统的状态转移函数通常形式化地描述为 $s_{t+1} = f(s_t, c)$,其中c代表条件输入。这种建模方式假设时间步长是固定的且已知的。然而,在实际应用中,观测往往是不均匀采样的,或者存在部分缺失。当我们需要知道第1.5秒的状态,或者需要从稀疏的低帧率视频中恢复高频细节时,离散模型便显得力不从心。ODEWorld通过求解潜状态关于物理时间的导数 $dot{z}t = v{ heta}(z_t, z_0, c, t)$ 来打破这一限制。这里的 $v_{ heta}$ 是潜空间速度场,它输出状态在下一瞬间的变化方向与速率。给定初始状态 $z_0$,未来的任意时刻状态均可通过数值积分器推导得出。这种连续时间的表述,为处理复杂时序任务提供了数学上的完备性。
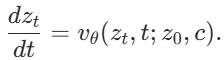
要实现连续时间的建模,首先必须解决潜空间表征的有效性难题。在机器人操作视频中,视觉信息存在巨大的冗余。墙壁、桌面等静态背景可能在数秒内保持不变,而真正驱动任务进程的是机械臂、夹爪与物体的接触动力学。若让网络同时拟合背景与动态前景,动态信号极易被静态噪声淹没。ODEWorld采用了创新的静动态解耦策略。模型首先利用冻结的DINOv2编码器提取初始状态的视觉特征 $s_0$,作为静态背景的参考锚点。随后,通过一个以 $s_0$ 为条件的动态编码器,提取仅描述相对变化的潜变量 $z_t$。
这种设计带来了激进的压缩比。原始DINOv2的特征图大小为16×16×768,而ODEWorld的动态潜变量被压缩至单一的1×768 token。基于这唯一的token,速度场仅由一个轻量级的三层MLP参数化,时间信息通过FiLM机制注入。更重要的是,由于编码器和解码器均能直接访问 $s_0$,潜变量 $z_t$ 无需重复编码背景信息,只需概括当前状态相对于初始状态的偏离。这种解耦不仅降低了计算复杂度,更为连续动力学学习清理了表征空间,使得速度场能够专注于捕捉真实的物理运动轨迹。
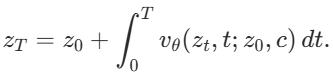
训练连续时间模型面临的另一个严峻挑战是表征坍缩。在典型的潜空间世界模型中,如果编码器将所有不同状态映射到相似的向量,预测器便容易通过最小化重建损失来获得虚假的高性能。ODEWorld摒弃了传统的逐帧重构监督,转而采用直接的一阶时间导数监督。模型的目标不再是预测下一个离散状态,而是预测潜状态的变化速度。利用链式法则和雅可比向量积(JVP),团队将离散视频帧在特征空间中的变化速度投影到动态潜空间,得到监督信号 $dot{z}_t$。
这种监督方式具有极强的结构约束力。如果潜空间发生坍缩,所有状态趋于一致,模型将无法解释非零的真实变化速度,从而导致损失函数无法收敛。实验数据有力地支持了这一观点:通过RankMe指标衡量,ODEWorld的768维动态潜变量平均有效秩高达425.2,显著高于DINOv2的376.1和V-JEPA 2的203.7。更高的有效秩意味着潜空间保留了更多彼此独立的动态维度,证明了单token设计并非信息贫乏,而是高效聚焦。
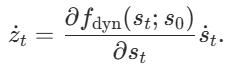
为了确保训练数据的稳定性,团队还引入了Savitzky–Golay导数滤波器。由于DINOv2编码器主要面向单帧语义设计,相邻帧的特征差分往往包含高频噪声。直接将这些差分作为物理速度训练速度场,会引入大量不稳定因素。Savitzky–Golay滤波器通过在局部窗口进行多项式平滑和求导,有效抑制了高频抖动,同时保留了抓取、接触等关键动态特征。可视化结果显示,ODEWorld生成的潜轨迹比原始DINO特征和离散预测基线更加平滑,且保留了主要的几何结构,这证明了PT-Flow在寻找适合连续积分且具语义保持能力的潜空间动力系统方面的成功。
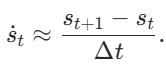
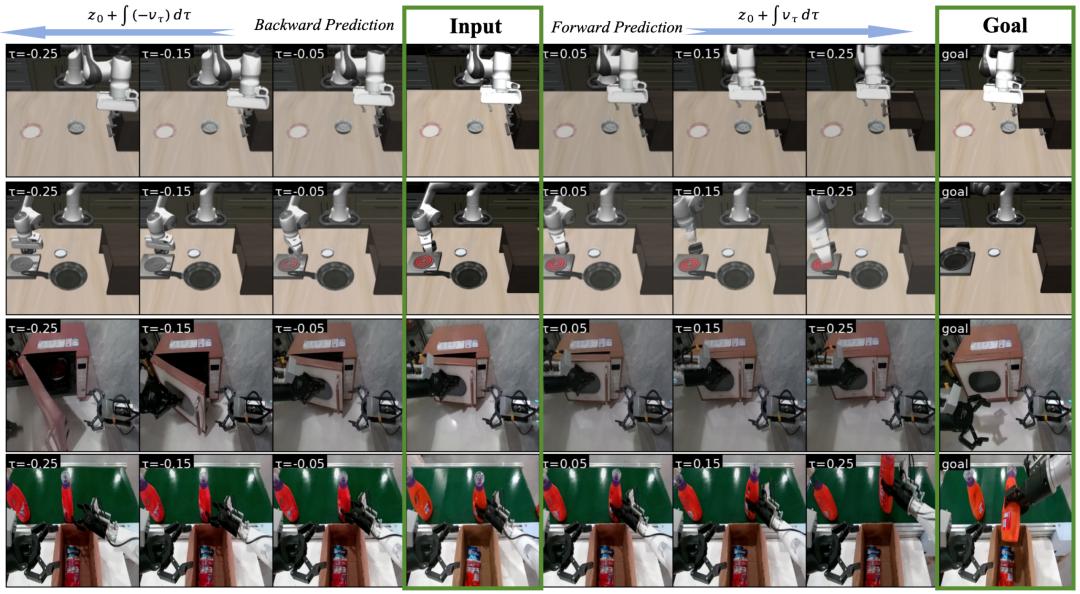
完成训练后,ODEWorld展现出了三类统一于同一速度场的生成能力,这是其最引人注目的突破。首先是任意时间分辨率生成。用户无需为不同速度单独训练模型,只需在积分器中选择不同的采样点密度,即可实现从慢动作回放到快速预测的无缝切换。其次是时间补全能力。在实验中,当训练序列被降采样至原帧率的三分之一时,ODEWorld仍能通过查询轨迹中间时刻,生成连贯且物理合理的高帧率视频。这种补帧并非简单的像素插值,而是基于学习到的潜空间动力学推演而来。第三是反向生成。通过反转积分方向,模型能够生成物理上合理的反向序列。虽然这并不意味着还原了唯一的历史,但表明模型学到的潜空间流具备方向可逆性,为分析因果关系提供了新视角。
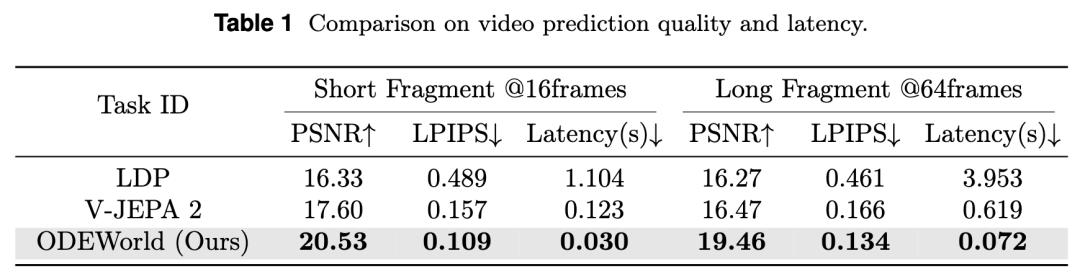
在效率方面,ODEWorld的表现令人瞩目。其核心优势在于将主要计算负担从“逐帧重建”转移到了“连续动力学积分”上。由于动态信息被压缩至单token,速度网络极其轻量,且ODE求解器在低维潜空间中完成整条轨迹积分,仅在最终输出时通过解码器恢复视觉结果。在LIBERO视频预测基准测试中,ODEWorld在64帧长程预测任务中,PSNR达到19.46,LPIPS为0.134,优于LDP和V-JEPA 2。更关键的差异体现在推理速度上:生成64帧时,ODEWorld仅需0.072秒,约为LDP的1/55和V-JEPA 2的1/8.6。这种效率提升不仅源于模型结构的优化,更得益于连续时间表征带来的计算冗余消除。
从更宏观的视角来看,ODEWorld的意义远超出了性能指标的提升。它标志着世界模型的学习对象从“离散状态映射”转向了“状态随物理时间的变化率”。对于具身智能而言,机器人真正需要的不是静态画面的堆砌,而是对物体交互过程中动态变化的实时直觉。当模型能够以连续的方式推演世界状态时,它就具备了在毫秒级时间尺度上进行精准控制的基础能力。这种从“模仿逐帧”到“理解变化”的范式转移,或许正是通向通用具身智能的关键一步。随着连续时间世界模型的成熟,未来的机器人将不再受限于摄像头的帧率,而是能够像人类一样,在连续的时间流中感知、预测并行动。