2026智驾底层重构:物理AI如何终结“黑箱”并重塑产业终局?
从数字模拟到物理交互:智能驾驶范式跃迁
2026年,当我们在谈论智能驾驶时,语境已经发生了根本性的偏移。过去几年,行业热衷于讨论算力TOPS、传感器数量以及像素精度,这些依然是基础要素,但已不再是决定胜负的唯一变量。随着“物理AI元年”概念的正式确立,智能驾驶正经历一场从“数字AI”到“物理AI”的底层重构。这一转变的核心,在于AI不再仅仅是对视觉信号的被动响应,而是开始具备对物理世界因果逻辑的深度理解与主动推演能力。
回顾2025年初,比亚迪掀起的智驾价格下沉战虽然加速了“全民智驾”的普及,但也暴露了早期技术的局限。当时的技术路线大多仍停留在“看见什么做什么”的应激反应阶段,依赖模块化割裂的算法架构。感知、预测、决策、控制各自为政,虽然逻辑清晰,但在传输过程中不可避免地产生信息损耗与误解,导致系统在长尾场景下的泛化能力孱弱,难以达到拟人化水平。这种“昆虫动物智能”式的初级阶段,正被更高级的形态所取代。
端到端演进:从黑箱到可解释的大脑
智能驾驶的技术演进史,本质上是从模块割裂走向“端到端融合”的过程。2024年3月,特斯拉推送FSD V12版本是一个里程碑。它移除了30万行手写代码,采用“Photon In, Control Out”架构,将感知和决策规划整合为单一神经网络。这一突破标志着端到端方案开始大规模落地。然而,早期的端到端模型存在一个致命缺陷——“黑箱”性质。人们难以追溯其决策逻辑,一旦发生事故,无法快速定位问题根源,这成为制约高阶智驾信任度的关键瓶颈。
为了打破这一僵局,行业开始探索VLA(视觉-语言-行动)模型。VLA通过融合计算机视觉、自然语言处理与强化学习,构建了集环境感知、语义理解与决策执行的统一智能体。它不仅仅是视觉识别,更引入了语义层面的理解,使得自动驾驶系统能够像人类一样“阅读”交通标志、“理解”行人意图。这种转变实现了从“机器模仿人类”向“超越人类智能”驾驶模式的迈进。
尽管VLA提供了语义层面的增强,但它并非完美无缺。Momenta CEO曹旭东曾指出,VLA的训练源于大语言模型(LLM),其侧重点在于语义理解,与自动驾驶的实际物理需求存在偏差。这意味着VLA虽然提升了理解能力,但在纯粹的物理推演上仍显不足,陷入了“好钢没用在刀刃上”的困境。因此,单纯依靠VLA难以实现真正的物理智能。
VLA与世界模型:殊途同归的融合之路
面对VLA的局限性,世界模型(World Models)成为另一条极具潜力的技术路线。华为车BU CEO靳玉志形象地比喻,VLA像是一个“背题库的学生”,通过语言中间层将视觉信息转化为文本Token进行决策,这在简单场景中有效,但在复杂或突发场景下容易失效。相比之下,世界模型试图跳过语言层,直接利用多源感知(视觉、声音、触觉等)构建对物理世界的因果逻辑理解。
世界模型的核心价值在于“预测”。如果说VLA解决的是“理解当下”的问题,那么世界模型解决的则是“预测未来”的难题。它给汽车装上了一个能够模拟物理世界运行规律的“智能大脑”。通过海量真实数据的训练,模型能够在输出动作之前,先在内部进行时空推演,预判物体下一秒的动作轨迹。这种基于物理直觉的预测能力,正是人类驾驶员在复杂路况下本能反应的基础。
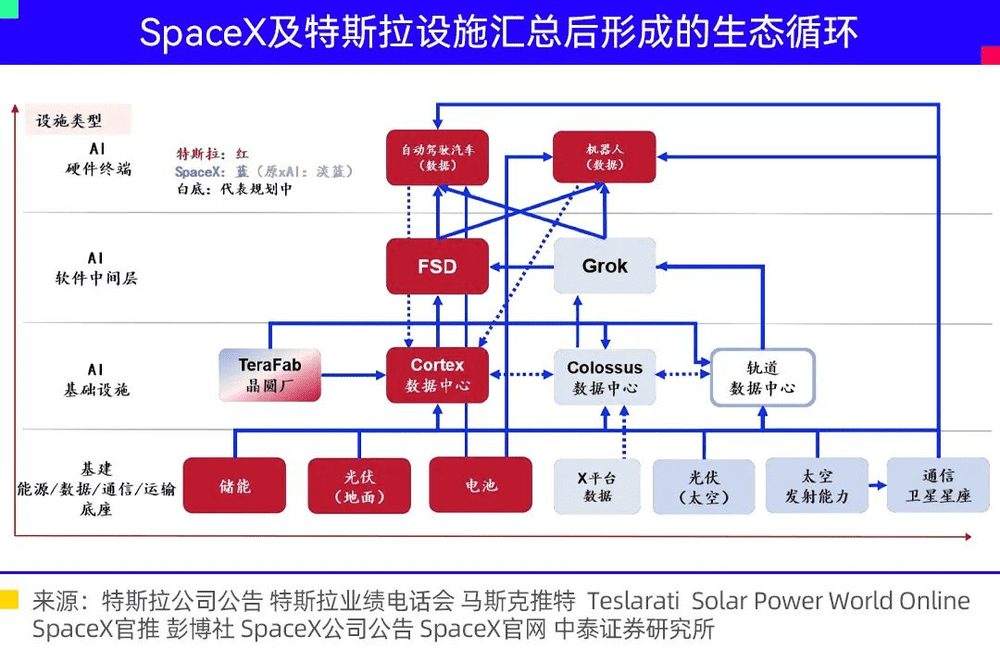
值得注意的是,2026年行业逐渐达成共识:VLA与世界模型并非“二选一”的对立关系,而是深度融合的互补伙伴。特斯拉FSD V14的推出改变了行业认知,新版本集成了xAI的Grok大模型,同时利用世界模型进行数据生成与闭环仿真。这种融合方案既保留了VLA在语义理解上的优势,又借助世界模型强化了物理预测能力。
小鹏汽车在这一融合路线上走得更远。在CVPR 2026大会上,小鹏通用智能中心负责人刘先明明确指出,VLA与世界模型共同构成了小鹏物理世界基座模型的两大支柱。其发布的X-Mind系统,将预测性世界模型内嵌为VLA模型的视觉思维链,实现了真正的端到端闭环。蔚来和华为也在各自的产品中引入了世界模型与强化学习的双引擎架构,标志着这一融合方案已成为全行业的标准配置。
物理AI终局:基座之战与莫拉维克悖论
随着VLA与世界模型的融合,智能驾驶的竞争逻辑已从“堆配置”转向“建底座”。过去,车企比拼激光雷达数量、芯片算力和续航里程;现在,谁掌握物理世界的理解与行动能力,谁就掌握价值链的主导权。越来越多的汽车企业重新定位自身为“物理AI企业”。理想汽车将基座模型与VLA研发团队合并,统一支撑智驾、座舱及人形机器人业务;高通也将汽车与机器人业务纳入同一事业群;Momenta更是被称为“物理AI第一股”。
这种统一技术底座的趋势,正在打破自动驾驶、智能座舱与人形机器人之间的技术壁垒。特斯拉用同一个基础模型驱动FSD、Optimus和人形机器人,实现了从自动驾驶汽车到具身智能体的无缝衔接。华为ADS 5.0引入Multi-Agent多智能体群体博弈,让云端无数AI驾驶者在虚拟环境中互相博弈学习,进一步提升了模型的泛化能力。
然而,我们必须清醒地认识到,现有的智驾系统距离真正的物理AI终极形态仍有巨大差距。这背后隐藏着著名的“莫拉维克悖论”:对人类而言难以完成的逻辑推理,AI可以轻松实现;而对人类而言简单的感知运动,如像婴儿一样感知物理世界,AI却极难掌握。现有智驾系统看似智能,却往往缺乏基本的物理直觉,这也是公众不敢完全放手让渡驾驶权的核心原因。
数据与算力的军备竞赛
通往物理AI之路的障碍,不仅在于算法,更在于数据与算力。世界模型的训练需要巨量的真实世界数据。截至2026年5月,特斯拉FSD车队累计行驶突破100亿英里,位居全球第一。相比之下,其他新势力品牌由于车队规模较小,累计里程多在数十亿公里级别。数据的匮乏限制了模型对长尾场景的理解能力。
与此同时,算力竞赛已进入白热化阶段。物理AI的实时推理要求车端具备极高的算力。小鹏Robotaxi搭载4颗图灵AI芯片,车端算力高达3000TOPS;华为乾崑智驾在未来五年内计划投入至少700亿元用于AI算力提升,其算力规模在29个月内实现了21倍增长。特斯拉据传握有约23万张H100等效算力。没有强大的算力支撑,庞大的模型训练和实时决策将成为空中楼阁。
结语:迈向超越人类智能的未来
2026年,物理AI正在重塑智能驾驶的底层架构。VLA与世界模型的融合,标志着行业从“黑箱”走向“可解释”,从“应激反应”走向“主动推演”。虽然距离真正的无人驾驶终极形态还有相当长的路要走,数据积累与算力瓶颈仍需突破,但方向已然清晰。
未来五年,随着L3/L4级自动驾驶的逐步落地,物理AI将不仅改变出行方式,更将重构整个制造业与服务业的底层逻辑。车企之间的竞争,将不再是单一功能的比拼,而是物理基座能力的全面较量。在这场关乎万亿级增长浪潮的竞争中,唯有那些能够真正理解物理世界因果逻辑、并具备高效执行能力的企业,才能站在终局的顶端。智能驾驶的下一幕,不再是机器的简单模仿,而是与人类智慧并驾齐驱,甚至超越人类的物理智能新时代。