Meta纯推理斩获奥赛金牌:AI解题能力跃迁与评估范式危机
在人工智能领域,衡量模型智力水平的标尺正在经历一场前所未有的剧烈震荡。当OpenAI刚刚宣布GPT-5.6 Luna免费开放之际,Meta悄然抛出了一枚重磅炸弹:其内部训练的AI模型在五项顶级STEM学科奥林匹克竞赛中,全部取得了金牌或同等水平的优异成绩。其中,在亚洲物理奥林匹克竞赛(APhO)和国际物理奥林匹克竞赛(IPhO)的理论考试中,该模型更是拿下了令人咋舌的满分成绩。这一事件不仅意味着Meta在经历了2025年的低谷后重新回到了技术竞争的中心舞台,更揭示了当前大模型推理能力进化的一个新阶段。
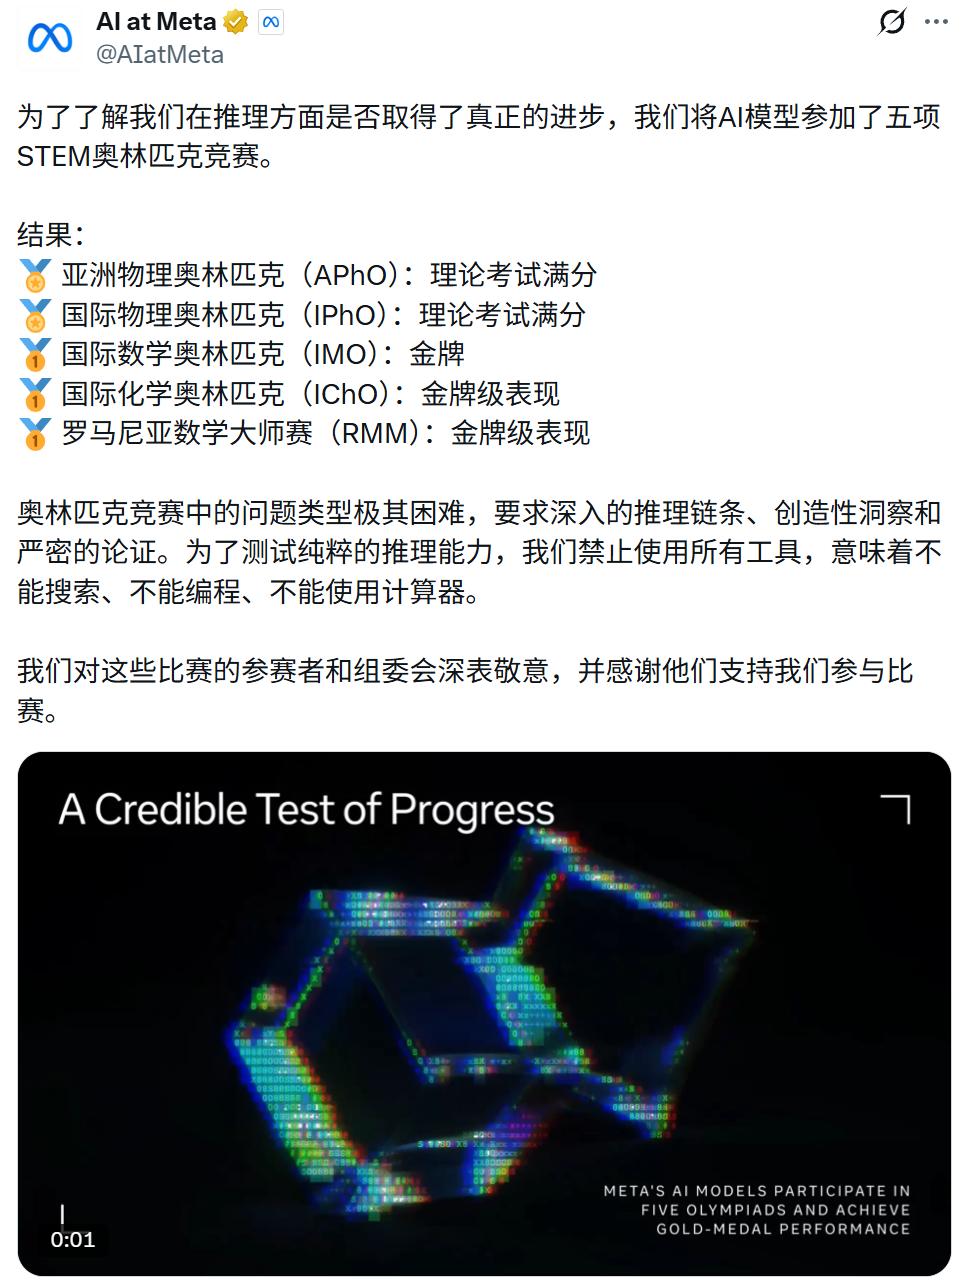
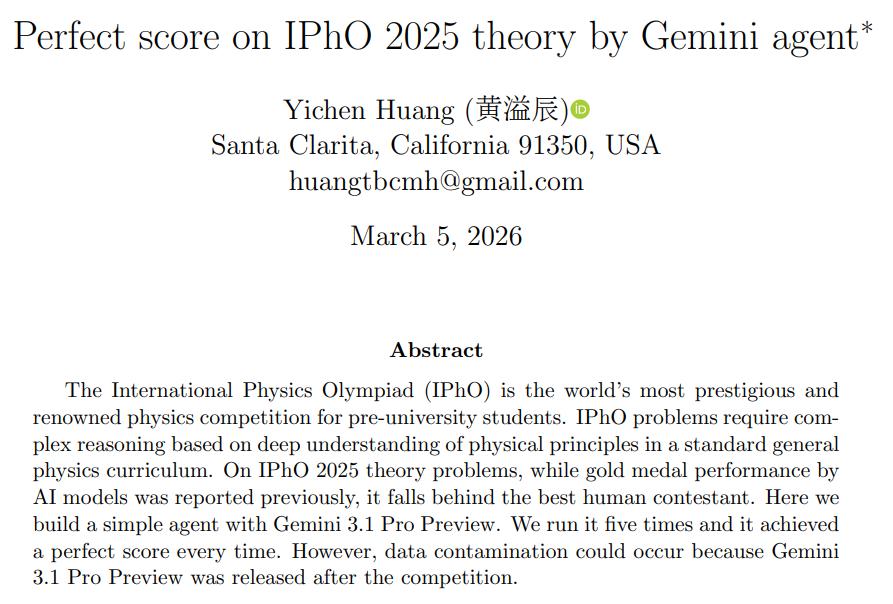
值得注意的是,Meta在此次测试中设定了极为严苛的限制条件:完全禁止使用任何外部工具。这意味着模型不能进行搜索引擎检索,不能编写代码来辅助计算,甚至不能使用计算器。这种“纯推理”模式的设定,旨在剥离以往依靠工具调用增强能力的路径依赖,直接检验模型底层的逻辑推演与知识整合能力。在过去的一年里,许多顶尖的奥赛成绩往往依赖于“强基座模型+验证器+多轮精修”的Agent流水线,而Meta此次的选择,无疑是对模型原生智力的一次极限压力测试。
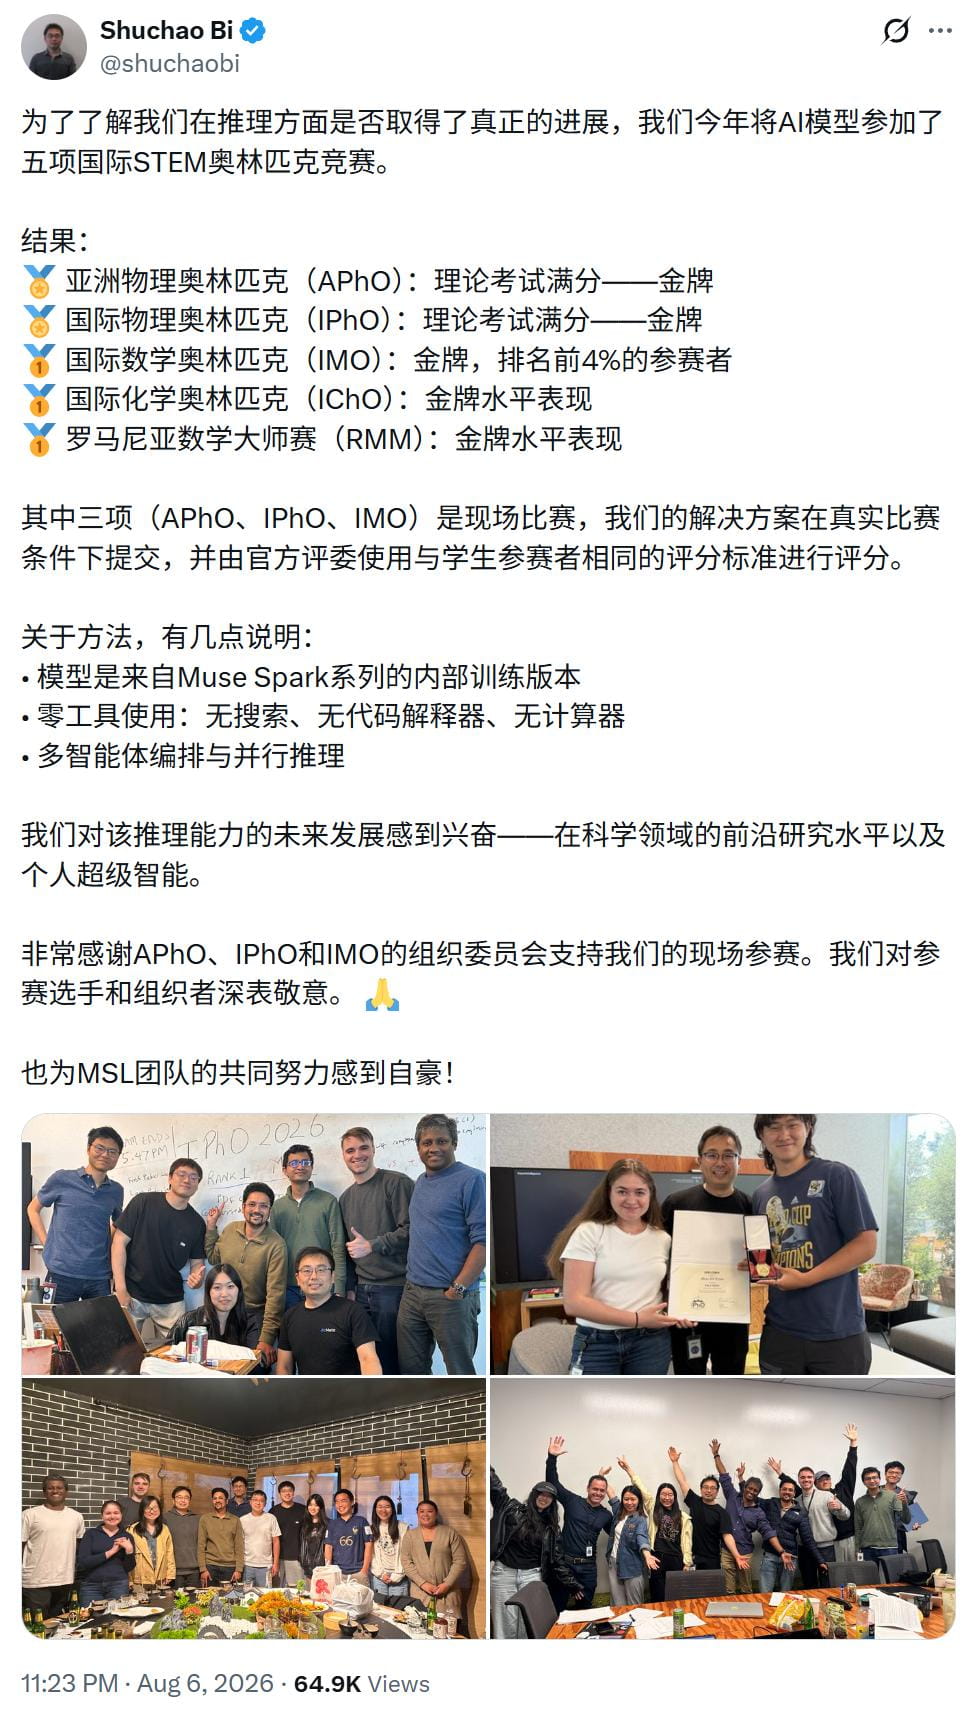
从技术架构来看,这次取得突破的模型并非我们熟知的Llama系列,而是来自Meta内部代号为“Muse Spark”的训练版本。据参与项目的研究人员透露,该模型采用了先进的多智能体编排技术与并行推理机制。这种架构允许模型在面对复杂问题时,能够同时启动多个思维链进行探索,并通过内部协作机制筛选出最优解。这与传统单一线性的推理过程有着本质区别,极大地提升了处理高维度、长链条逻辑问题的成功率。Muse Spark系列的崛起,也映射出Meta在重组其AI实验室后的战略转向,即从单纯的开源生态构建者,向追求极致单体智能与代理智能并重的技术领导者转变。
此次测试中最具戏剧性的一幕,并非仅仅是分数的获取,而是模型对权威的挑战。在IPhO的某道题目中,Meta的模型得出的结论与官方提供的标准答案不一致。经过后续的详细复核,竞赛委员会确认是官方答案存在错误,而AI的推导才是正确的。这一发现不仅防止了人类参赛者的答卷被错误评分,更让IPhO委员会向Meta寄送了一枚实体金牌以示感谢。这一案例极具象征意义,它表明当前的顶级AI模型已经不再仅仅是知识的搬运工或既定规则的遵循者,而是具备了发现既有知识体系中漏洞、甚至修正人类专家错误的潜力。
然而,当我们为Meta的回归欢呼时,必须冷静审视这一成绩背后的行业背景。2026年的AI竞赛格局已与一年前大不相同。早在今年7月结束的上海IMO中,华为的Celia模型与小红书的dots-note-3.0均已宣布获得满分金牌,Anthropic的Claude Opus 5也在无工具辅助下一次性通过了全部六道题。在这样的坐标系中,Meta获得的IMO金牌虽然含金量十足,但已不再是独一无二的“登月时刻”。相反,两项物理理论的满分成绩,因其对复杂物理情境建模的高要求,可能更具区分度。但这同时也引出了一个更为深刻的问题:当奥赛题目逐渐被各大实验室“刷满”,这把曾经被视为智力天花板的尺子,是否还能有效衡量AI的真实进步?
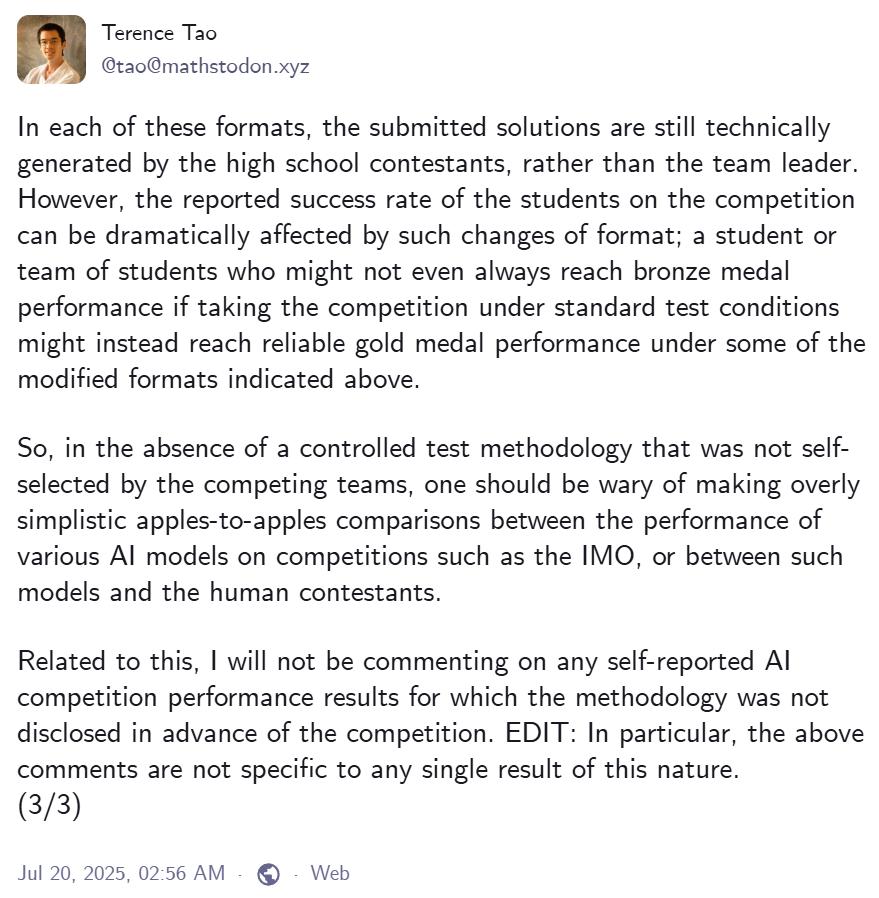
数学界著名学者陶哲轩曾指出,AI的表现高度依赖于测试方法本身。奥林匹克竞赛题目具有标准答案、明确的评分规则以及海量的历史题库,这些特征使得它们成为监督学习和强化学习的理想训练场。然而,现实世界中的科学研究往往面临着定义模糊、数据缺失、没有标准答案的困境。AI在封闭、结构化的竞赛环境中表现优异,并不等同于其在开放、非结构化的科研探索中具备同等的创新能力。因此,奥赛成绩的普遍提升,更多反映的是模型在特定分布数据上的拟合能力与推理策略的优化,而非通用科学智能的根本性突破。
回顾Meta过去两年的历程,从Llama 4 Maverick在智能指数上的低迷,到扎克伯格亲自下场重组成立Meta Superintelligence Labs(MSL),再到引入Alexandr Wang与Scale AI团队重构数据管线与RL后训练系统,这一系列动作显示了Meta破釜沉舟的决心。Muse Spark模型的诞生,正是这一战略重构的直接产物。从4月份智能指数的大幅跃升,到7月份主打Agentic能力的Muse Spark 1.1上线,再到如今奥赛成绩的公布,Meta正在通过快速迭代的产品线,试图弥补其在闭源高端模型领域的短板。
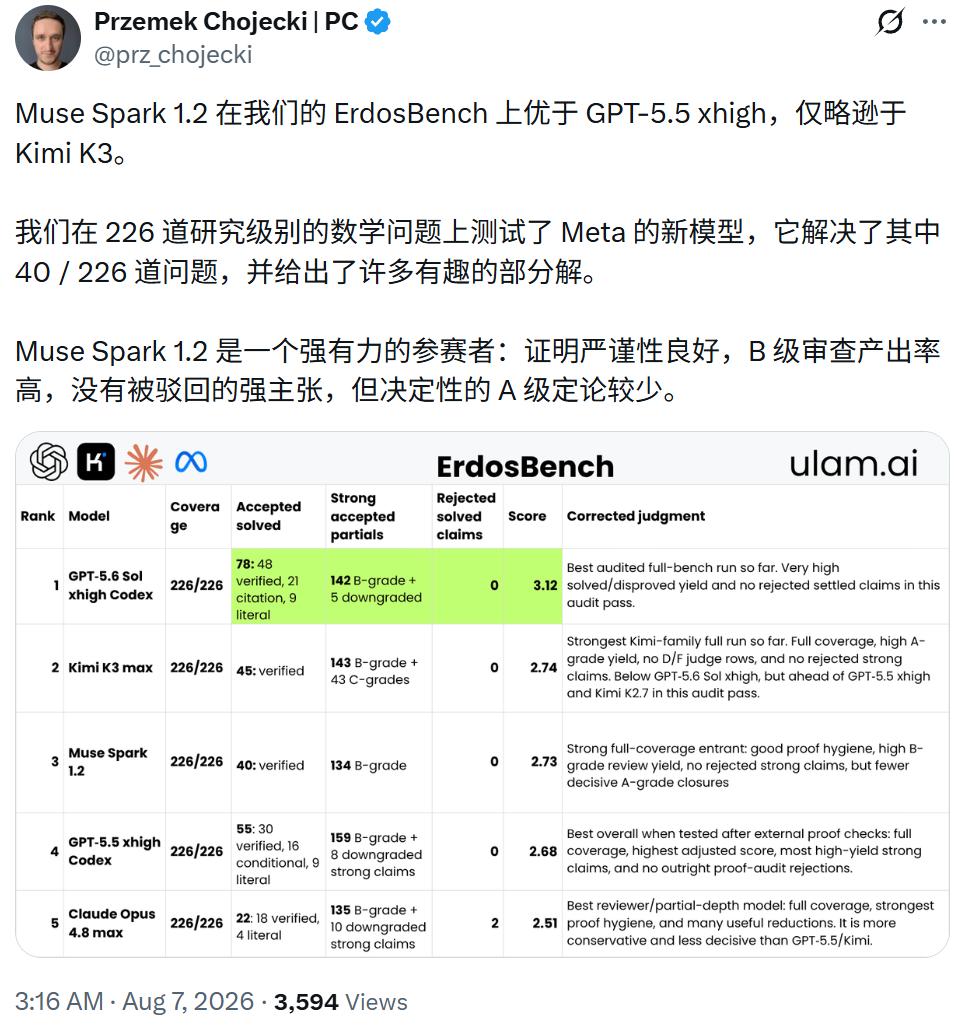
尽管Meta尚未发布详细的技术博客或研究报告,但从现有信息可以推断,其核心优势在于将大规模预训练知识与高效的推理架构相结合。多智能体编排技术的应用,使得模型能够在内部模拟“辩论”与“验证”的过程,从而减少幻觉,提高答案的准确性。这种内部化的自我纠错机制,可能是其能够发现官方答案错误的关键所在。相比于依赖外部工具链的Agent方案,这种内生于模型架构的推理能力,具有更高的鲁棒性和泛化潜力。
然而,技术的进步也带来了评估体系的危机。随着越来越多的模型在标准测试集上达到饱和,行业急需建立新的评估基准。这些新基准应当更注重开放性、创造性以及对未知领域的探索能力,而非仅仅是对已知知识的复现与推导。例如,能否让AI提出一个新的数学猜想?能否设计一个从未有过的物理实验方案?这些缺乏标准答案的任务,或许才是检验下一代AI智能水平的真正试金石。
对于Meta而言,这次奥赛成绩无疑是一剂强心针,证明了其技术路线的正确性与执行力。但要真正重回第一梯队,仅靠竞赛金牌是不够的。市场更需要看到的是,这些强大的推理能力如何转化为实际的生产力工具。Muse Code编程智能体的Beta测试只是一个开始,未来如何将Muse系列的推理能力融入医疗诊断、材料科学、金融分析等垂直领域,解决那些真正复杂且没有标准答案的现实问题,才是Meta乃至整个AI行业面临的终极挑战。
此外,纯推理能力的提升也引发了关于算力效率与伦理安全的讨论。在不借助外部工具的情况下完成高难度推理,意味着模型需要在内部进行海量的计算与状态搜索,这对算力资源提出了极高要求。如何在保持高性能的同时降低推理成本,将是商业化落地的关键。同时,当AI具备纠正人类专家错误的能力时,如何建立人机协作的信任机制,确保AI的判断不被滥用或误读,也是社会层面需要提前布局的议题。
综上所述,Meta在奥赛中的表现是其技术复苏的有力证明,也是AI推理能力进化的一个里程碑。但它更像是一个过渡性的标志,预示着旧有的评估体系正在失效,而新的智能范式尚未完全确立。在这个转折点上,无论是Meta、OpenAI还是其他科技巨头,都需要跳出“刷题”的思维定势,去探索人工智能在更广阔、更深层认知领域的可能性。毕竟,真正的智能,不在于解开已有的谜题,而在于提出新的问题。