从Coding到Work:中美AI巨头如何通过底层逻辑重构生产力版图
在人工智能演进的下半场,一场关于生产力重构的隐形战役正在全球范围内悄然展开。如果说过去的两年是AI编码(Coding)能力的角逐场,那么2025年至2026年,随着Anthropic推出Claude Cowork以及中国大厂密集布局办公智能体,战场已不可逆转地延伸至更广阔的AI工作(Work)领域。这不仅是产品形态的迭代,更是商业逻辑、数据壁垒与用户粘性的全面重构。
战略分岔:Coding赛道的中美错位
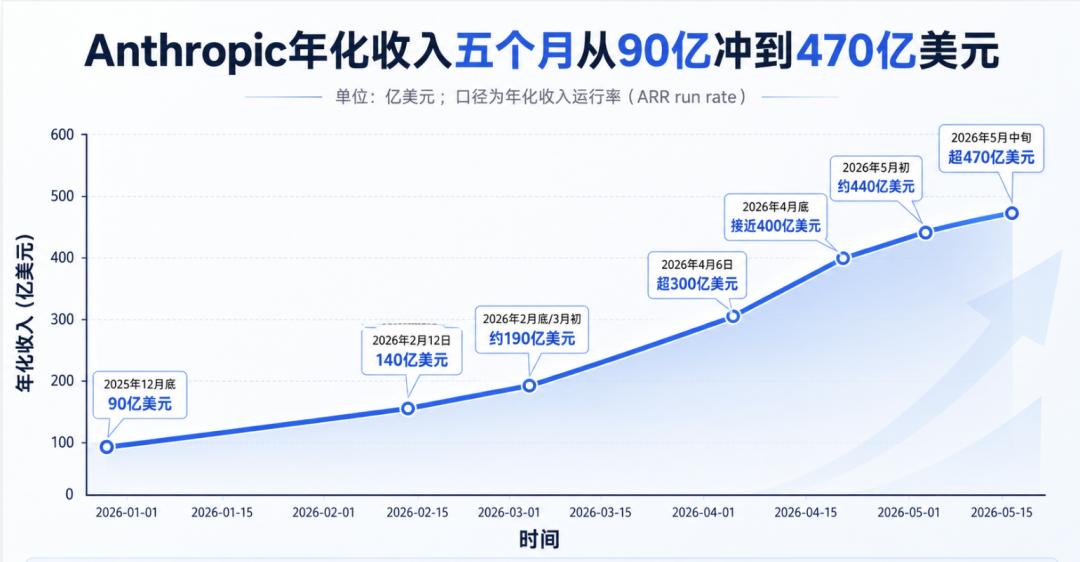
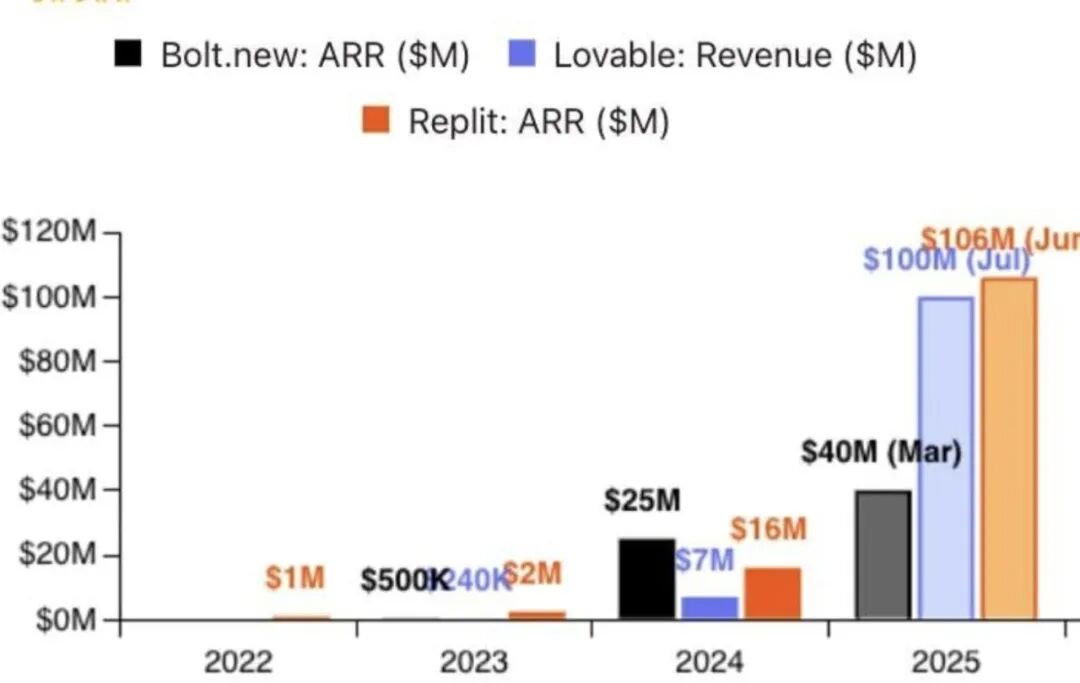
回顾2024年,AI编程领域呈现出截然不同的中美图景。美国初创公司Bolt.new在上线四周内即实现400万美元年化收入,Anthropic通过Claude 3.5 Sonmodel迅速占据市场高地,其token消耗量与收入规模呈指数级增长。相比之下,中国大厂如腾讯、阿里、字节在这一时期的表现则显得“克制”且滞后。一位业内资深人士指出,这种滞后并非单纯的技术能力问题,而是战略优先级与资源分配的结果。
在2025年中期之前,中国头部科技企业普遍以OpenAI为对标系,聚焦于通用大模型的“百花齐放”,而在C端应用与B端行业解决方案上全面铺开。在这种背景下,编程助手被视为一个垂直且看似市场规模有限的细分领域。智谱科技的早期策略便反映了这一倾向,其首款模型虽涉及编码,但随后迅速转向通用能力。与此同时,大厂内部的Coding团队往往面临资源争取的难题,部分团队甚至处于“清闲”状态,缺乏All-in的决心。
反观Anthropic,其创始人Dario Amodei在早期便确立了“编程是通往AGI的关键路径”这一战略直觉。通过训练包含大量商业软件代码的数据集,Anthropic构建了以编码为核心的数据飞轮。这种“先做窄,再做深”的策略,使其在模型推理、工具调用及软件工程自动化方面建立了深厚的护城河。正如智源研究院理事长黄铁军所言,数字世界的运行逻辑深植于代码之中,忽视编码能力的AI模型,注定在自动化进程中遭遇天花板。
商业模式的鸿沟:定制化陷阱与SaaS红利
中美AI企业在Coding赛道的差距,更深层地体现在商业模式的选择上。2024年,中国大模型企业已收到来自金融、泛互联网及制造业的明确信号,代码类AI应用需求旺盛。然而,这些需求大多转化为定制开发、驻场服务或私有化部署项目。阿里通义灵码、智谱等早期不得不承担大量定制化工作,这种“人力密集型”的交付模式导致边际成本居高不下,增长曲线平缓,难以形成规模效应。
这种定制化路径不仅消耗了研发资源,更导致数据回流受阻。定制项目往往隔离在客户内部,难以形成通用的训练数据闭环。相反,海外企业如Cursor、GitHub Copilot以及Anthropic,迅速转向基于Token消耗的订阅制SaaS模式。这种模式不仅带来了可预测的经常性收入(ARR),更重要的是,它通过海量的用户交互数据,不断反哺模型优化,形成了“产品-数据-模型”的正向飞轮。
华为云Coding产品负责人指出,当前的竞争核心已从模型训练能力转向数据飞轮的构建。Anthropic通过Claude Code收集开发者指令、测试用例及代码评审数据,这些数据的质量远高于国内大厂内部积累的“屎山代码”。这种数据维度的降维打击,使得海外模型在复杂逻辑推理与长上下文理解上保持领先。
转折与追赶:创业公司的破局与大厂的觉醒
2025年中后期,随着DeepSeek R1模型的发布以及Anthropic停止部分中国服务,行业格局发生剧烈震荡。中国科技企业开始重新评估Coding的价值,加速了从“通用助手”向“垂直生产力工具”的战略回调。
在此过程中,以智谱、月之暗面为代表的创业公司展现了惊人的爆发力。智谱在2025年9月推出迁移计划,以极具竞争力的价格承接流失用户,迅速实现ARR破亿,并明确提出对标Anthropic的战略目标。月之暗面则聚焦底层模型创新,通过引入MuonClip优化器、线性注意力机制等技术突破,推出了K2.5及K3等重磅模型。数据显示,Kimi的ARR迅速突破1亿美元,其开源模型被Cursor等国际巨头采用,反向赋能全球AI编程生态。
大厂方面亦不甘示弱。阿里通过重组团队,推出Qoder封闭开发;腾讯发布CodeBuddy;字节跳动则凭借Trae在个人端迅速积累用户。尽管大厂在多模态、搜索及通用助手领域的资源争夺依然激烈,但Coding赛道已进入“快追”阶段。业内共识逐渐形成:只要基座模型能力提升,依托中国丰富的应用场景与高水平工程师团队,Coding能力的差距可在短时间内抹平。
战场升级:从3000万程序员到10亿知识工作者
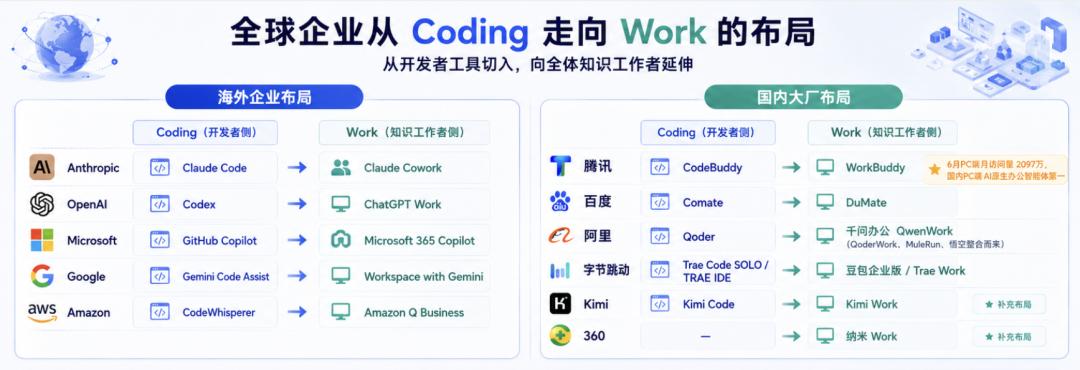
当Coding赛道趋于同质化,竞争的自然延伸便是向更广阔的知识工作者市场拓展。Anthropic推出的Claude Cowork、腾讯的WorkBuddy、阿里的千问办公以及字节的豆包产品体系,均指向这一目标。这一转变背后的逻辑,基于对市场规模、用户粘性及数据价值的重新计算。
首先,用户基数的巨大差异决定了市场天花板。全球程序员仅约3000万,而知识工作者超过10亿。月之暗面创始人杨植麟指出,编程场景虽占Token消耗大头,但Work领域的想象空间更为广阔。其次,用户行为特征截然不同。程序员群体具有较高的技术敏感度与迁移成本,倾向于货比三家;而知识工作者更关注工作流整合与结果交付,一旦形成使用习惯,粘性极强。
更为关键的是数据资产的累积效应。在Coding阶段,程序员出于隐私考虑,往往开启隐私模式,导致企业难以获取有价值的业务数据。而在Work场景下,用户主动上传文档、整理知识库、处理会议纪要,这些行为产生了丰富且高维度的企业私有数据。对于拥有云生态的大厂而言,这些数据是构建企业级AI壁垒的核心资产。
产品融合与生态闭环
当前,各巨头均在探索“Coding+Work”的双轮驱动模式。腾讯通过CodeBuddy沉淀代码生成能力,将其作为Agent内核嵌入WorkBuddy,实现从底层代码到上层办公场景的贯通。阿里则将Qoder、MuleRun等产品整合入千问办公体系,试图打造统一的AI入口。字节跳动通过合并飞书与豆包产品团队,强化对白领用户的亲和力与服务深度。
这种产品融合不仅仅是功能的叠加,更是底层架构的重塑。未来的AI助手将具备长时记忆、多模态理解及复杂任务规划能力,能够跨应用、跨平台执行端到端的数字化任务。例如,从提取邮件信息到自动生成PPT,再到同步至项目管理工具,AI将取代碎片化的工具链,成为真正的“超级个体”。
变现探索与未来展望
尽管前景广阔,Work领域的商业化路径仍在摸索中。与传统SaaS不同,AI办公助手更多体现为员工提效工具,企业采购逻辑更为谨慎。业内预测,未来的变现模式可能从单纯的订阅制,转向基于知识库存储、高级插件服务及定制化Agent训练的混合模式。例如,飞书已通过知识库付费模式验证了部分逻辑,而WorkBuddy等产品的成功,或将为打破传统企业网盘的价值困境提供新范式。
从Coding到Work,中国AI企业正在经历从“追赶”到“并跑”乃至“局部领先”的蜕变。虽然在与Anthropic等海外顶尖模型的底层能力上仍存在差距,但凭借庞大的应用场景、独特的数据生态及快速迭代的产品能力,中国企业有望在Work赛道找到新的增长曲线。这场战役的最终胜负,将取决于谁能在模型能力、数据壁垒与用户体验之间找到最佳平衡点,真正让AI融入每一位知识工作者的日常流中。