海光DCU K100部署350亿MoE编程模型:KAT-Coder全链路实战解析
国产化算力环境下的智能编程新范式
在人工智能技术迅速迭代的当下,国产算力平台的成熟为深度学习模型的落地提供了新的可能性。海光DCU(Deep Computing Unit)作为国产GPU的重要代表,其生态适配能力正在逐步完善。本次实践聚焦于在海光DCU K100_AI服务器上部署快手KwaiKAT团队开源的KAT-Coder-V2.5-Dev模型。该模型是一款专注于编程任务的智能体(Agentic Model),其核心优势在于能够在真实、可执行的代码仓库中自主运行,而不仅仅是生成单轮次的代码片段。
KAT-Coder-V2.5-Dev采用了混合专家(Mixture of Experts, MoE)架构,总参数量高达350亿,但单次激活参数量仅为30亿。这种设计在保证模型强大表达能力的同时,显著提升了推理效率。该模型基于Qwen3.6-35B-A3B进行后训练,经过12.7万条监督微调(SFT)样本及强化学习优化,原生支持262,144 token的超长上下文窗口。在权威的SWE-bench Verified基准测试中,其通过率达到69.40%,在PinchBench智能体工具调用测试中更是取得了93.43%的优异成绩,确立了其在同类参数规模模型中的SOTA(State of the Art)地位。
整体架构设计与硬件选型
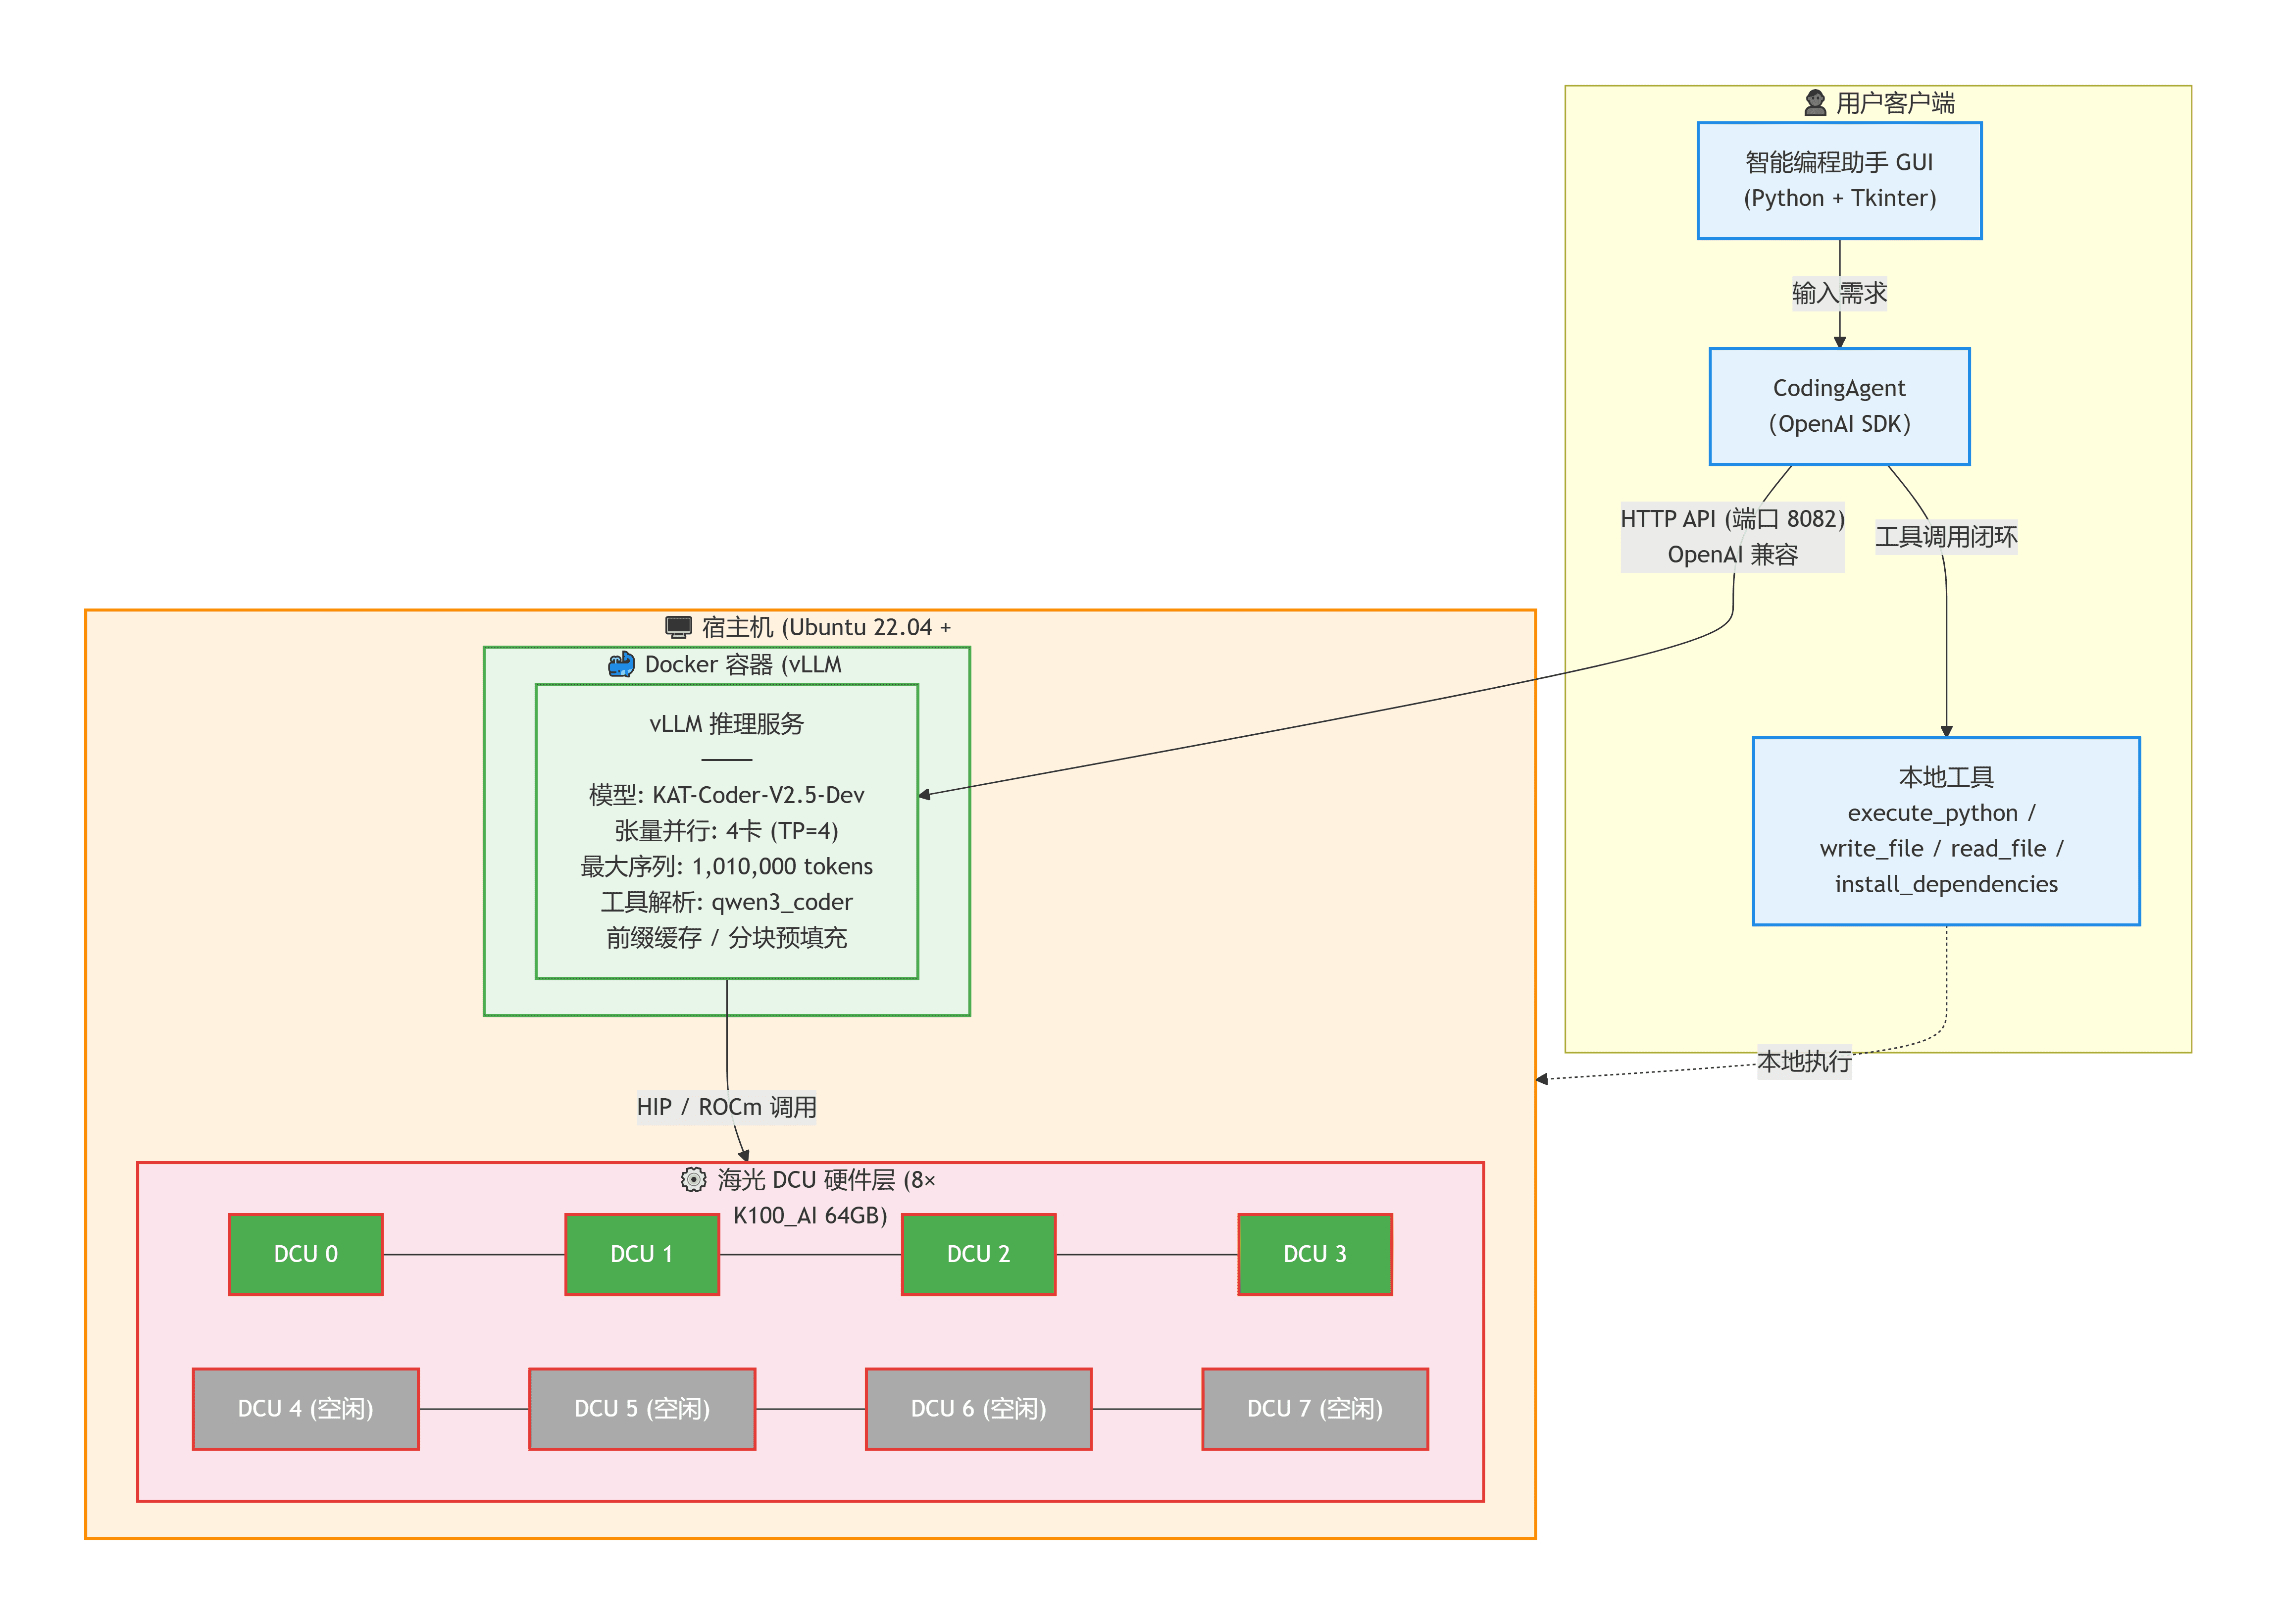
本次部署方案的总体架构划分为硬件层、推理引擎层和应用层三个核心部分,旨在构建一个高效、稳定且易于扩展的智能编程生态系统。
硬件基础设施配置
算力底座是模型推理性能的物理保障。本方案选用搭载8张海光DCU K100_AI加速卡的x86架构服务器。每张DCU拥有64GB显存,总计512GB显存资源,足以支撑大规模模型的并行计算需求。CPU采用AMD64架构,系统内存建议配置512GB以上,以应对模型加载时的数据搬运开销以及智能编程助手运行过程中的内存驻留需求。操作系统选用Ubuntu 22.04 LTS,并结合海光官方提供的DTK 26.04驱动环境,确保底层硬件指令集与软件栈的兼容性。
推理引擎层:vLLM框架的深度适配
推理引擎的选择直接决定了模型的服务化能力和吞吐量。方案采用vLLM推理框架,具体版本为针对海光DCU优化定制的vllm:0.21.0-ubuntu22.04-dtk26.04-py3.10镜像。vLLM以其高效的PagedAttention机制和连续批处理技术著称,能够大幅优化显存利用率并提升并发处理能力。
在该层中,vLLM以OpenAI兼容API的形式提供服务。这种标准化接口不仅降低了应用层的开发成本,还使得现有的开源工具链(如LangChain、Semantic Kernel等)能够无缝接入。通过配置--tensor-parallel-size参数,实现模型权重的分布式加载,从而突破单卡显存限制。
应用层:智能编程助手闭环系统
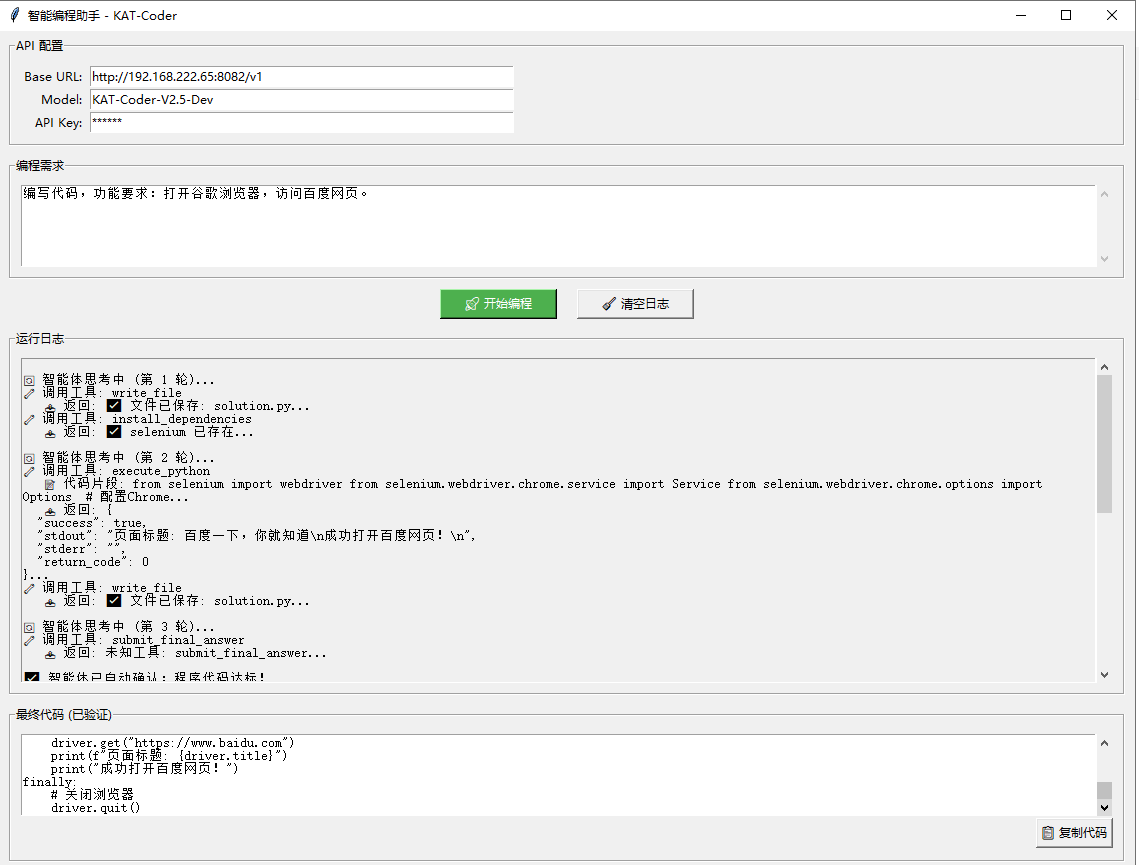
应用层是基于Python Tkinter框架开发的图形化智能编程助手。其核心设计理念是“编写→执行→验证→修正”的迭代闭环。助手通过OpenAI SDK与后端的vLLM服务通信,利用KAT-Coder-V2.5-Dev原生支持的自动工具选择能力,调用代码执行、文件读写、依赖安装等工具。用户只需输入自然语言编程需求,系统即可自动解析需求、生成代码、执行测试并反馈结果,极大地降低了使用门槛。
模型部署策略与关键技术细节
面对350亿参数的MoE模型,如何在8张64GB显存的DCU上进行高效部署,是本次实践的核心挑战。
张量并行策略的选择
MoE模型虽然激活参数少,但在加载阶段,所有专家(Expert)的权重都需要载入显存。经过实测验证,对于K100_AI配置,采用4卡张量并行(Tensor Parallelism)是最佳平衡点。
若使用2卡并行,虽然显存压力较小,但网络通信开销占比过高,且KV Cache空间有限,难以支撑超长上下文。若使用8卡全并行,虽然吞吐量最大,但单卡显存利用率波动较大,且对分布式通信带宽要求极高。4卡并行方案中,每张卡承担约1/4的权重计算,每卡需分配约35-40GB显存用于模型权重,剩余约24-29GB显存用于KV Cache和中间变量。这一配置既保证了在处理长代码序列时不出现OOM(Out of Memory),又维持了较高的推理吞吐速度。
vLLM服务启动的关键参数调优
启动脚本中的环境变量和参数配置直接影响推理稳定性。以下是关键参数的深度解析:
- 硬件可见性控制:通过
HIP_VISIBLE_DEVICES=0,1,2,3指定使用的DCU设备,避免与其他进程冲突。 - NUMA亲和性优化:设置
VLLM_NUMA_BIND=1及相关Rank绑定参数,确保计算线程与对应NUMA节点的内存带宽最佳匹配,减少跨节点访问延迟。 - Flash MLA启用:
VLLM_USE_FLASH_MLA=1启用了海光架构下的Flash Multi-Head Attention优化,显著提升注意力机制的计算效率。 - 上下文扩展:通过
--hf-overrides注入YaRN位置编码配置,将最大序列长度从默认的4096扩展至1010000 token,这是支撑长代码仓库分析的基础。 - 工具调用支持:启用
--enable-auto-tool-choice和--tool-call-parser qwen3_coder,确保模型能够准确识别并解析结构化工具调用请求。
智能编程助手的核心逻辑实现
智能编程助手不仅仅是一个聊天机器人,它是一个具备自主行动能力的代码执行代理(Agent)。其核心类CodingAgent实现了复杂的交互逻辑。
工具定义与注册
助手定义了五种核心工具,分别对应不同的执行环境:
- execute_python:核心工具。在隔离的子进程中执行Python代码,捕获标准输出和错误信息。这是验证代码正确性的唯一途径。
- install_dependencies:依赖管理工具。解析代码中的
import语句,自动识别缺失的第三方库并调用pip进行安装。这一功能解决了模型生成代码时依赖环境缺失的常见问题。 - write_file / read_file:文件系统工具。允许智能体在本地创建和修改文件,便于保存生成的复杂项目结构。
- submit_final_answer:终止工具。当智能体确信代码已通过所有测试且满足需求时,调用此工具提交最终结果,结束本轮推理。
迭代验证闭环机制
智能体的工作流程遵循严格的循环逻辑:
- 意图识别与代码生成:接收用户需求,生成初步代码。
- 工具调用与执行:智能体调用
execute_python执行代码。 - 结果分析与反馈:根据执行结果(成功或报错),智能体分析错误堆栈。若报错,则调用
install_dependencies或修正代码逻辑后重新执行。 - 最终提交:当连续多次执行均返回成功,且输出符合预期时,智能体调用
submit_final_answer。
这一机制通过引入“执行”环节,将传统LLM的“文本生成”升级为“代码工程”,大幅提高了生成代码的可执行率和准确率。
部署实战中的关键问题与解决方案
在实际部署过程中,遇到了多个典型的技术难点,以下是详细的排查与解决指南。
环境配置陷阱
DTK驱动缺失:海光DCU依赖DTK(DCU Toolkit)作为基础运行库,类似于NVIDIA的CUDA。若未安装DTK 26.04,Docker容器内将无法识别加速卡。检查命令为ls -l /opt/ | grep dtk。
容器权限不足:启动Docker容器时,必须添加--privileged参数,并挂载/dev/kfd、/dev/dri等关键设备节点,同时使用--group-add video赋予用户视频组权限,否则vLLM无法初始化DCU硬件接口。
模型加载优化
显存溢出(OOM):若加载模型时出现OOM,首先检查HIP_VISIBLE_DEVICES配置是否正确。其次,尝试将--tensor-parallel-size从4降低到2,虽然这会降低吞吐量,但能显著减少单卡显存占用。此外,适当增加--gpu-memory-utilization参数(推荐0.85-0.95),可强制vLLM更充分地利用可用显存。
工具调用失效:若模型直接输出文本而不调用工具,通常是因为未同时启用--enable-auto-tool-choice和--tool-call-parser qwen3_coder。这两个参数缺一不可,前者告诉模型可以调用工具,后者指定解析格式。
总结与未来展望
本次实践成功在海光DCU K100_AI集群上实现了350亿参数MoE编程模型的高效部署,并通过智能编程助手验证了其在真实代码场景下的自主执行能力。4卡张量并行策略在显存占用与推理性能之间取得了良好平衡,而OpenAI兼容API的设计则确保了生态的通用性。
随着国产算力生态的不断完善,海光DCU结合vLLM等先进推理框架,为企业提供了安全、可控的大模型私有化部署路径。未来,可从以下几个方向进一步深化应用:
- 并行策略精细化:探索8卡全量并行或更细粒度的流水线并行(Pipeline Parallelism),以应对更大规模的参数模型。
- 模型量化技术:引入AWQ(Activation-aware Weight Quantization)或GPTQ等量化算法,在保持精度的前提下进一步降低显存占用,提升推理速度。
- 检索增强生成(RAG):结合企业内部私有代码库,构建向量数据库,使智能编程助手能够基于特定业务逻辑生成更精准的代码。
- 多智能体协作:基于KAT-Coder的Agentic能力,构建由架构师、编码员、测试员等多个角色组成的多智能体协作系统,实现更复杂的软件工程自动化。
这一系列探索不仅验证了国产算力在AI推理领域的可行性,也为后续的大规模工业化落地积累了宝贵的实践经验。