Bekko Embedding:多语言检索模型能有多小?
在文本嵌入模型不断追求更大规模和更高精度的趋势下,一个逆向思考的问题浮现:模型能压缩到多小,同时保持实际可用的检索质量?Bekko Embedding正是对这一问题的探索成果,它包含两个模型——bekko-embedding-v1-a8m和bekko-embedding-v1-a25m,分别仅有7.67M和24.93M活跃参数,却在多语言检索任务上展现出超越许多更大模型的性能。
为什么关注小型模型
编码代理(Coding Agents)正在改变计算资源的分布。推理任务通常由云端的前沿模型完成,但本地设备仍需处理检索相关的工作:将文档嵌入为向量、构建索引、搜索上下文。这些设备往往没有GPU,甚至可能是树莓派。使用multilingual-e5-large嵌入一万个文档,在快速桌面CPU上需要约8分钟,而在树莓派5上则接近2小时。查询嵌入在每次搜索时都会计算,而非仅在索引时。
小型嵌入模型(活跃参数低于3000万)在开源多语言模型中非常稀缺。在我调研的模型中,除了Bekko,仅有multilingual-e5-small(基于2020年的MiniLM蒸馏)和granite-embedding-97m-r2(2026年发布,28.3M活跃参数)符合条件。静态嵌入如Model2Vec可以更小,但它们不是上下文模型,质量下降明显。
模型参数与计算量
多语言嵌入模型的实际计算量往往被总参数数误导。以118M总参数的模型为例,其中大部分是词嵌入表(Bekko有256,000个token),推理时仅做查找操作,不涉及矩阵乘法。真正参与每个token计算的是Transformer块中的参数,即活跃参数。Bekko是密集编码器,所有7.67M参数在推理时都会使用,只是排除了嵌入查找表。
multilingual-e5-small总参数118M,活跃参数21.6M;而bekko-a8m总参数106M,活跃参数仅7.67M。这一差距直接体现在推理速度上。活跃参数是预测吞吐量的良好指标,但并非唯一因素。
Bekko Embedding 的设计
Bekko通过将22层的mmBERT-small编码器剪枝至4层(a8m)和13层(a25m),然后在约11亿多语言句对上进行训练。模型支持100多种语言,跨语言设计使得日语查询可以直接检索英文文档。输入长度可达8192 token,嵌入维度384,并支持截断至256/128/64(Matryoshka训练)。权重采用MIT许可证,训练数据也已公开。
基准测试结果
在MMTEB Multilingual v2的18个检索任务上,bekko-a8m平均得分56.2,超过所有multilingual-e5模型和BGE-M3,而后者的活跃参数是它的3到40倍。bekko-a25m得分更高,达到57.5。在全部131个任务上,bekko-a8m为56.7,a25m为58.3。
在HAKARI-Bench的检索基准上,包括Multilingual NanoBEIR、NanoRTEB、NanoCoIR和NanoLongEmbed,bekko-a25m在长文本检索中排名第一(70.6),超过BM25(82.2)以外的所有密集模型。代码检索得分78.6,优于multilingual-e5-large和BGE-M3,但落后于EmbeddingGemma-300M(84.7)和granite-embedding-311m-r2(81.4)。

语言覆盖

在Multilingual NanoBEIR的14种语言中,bekko-a25m在所有语言上均优于multilingual-e5-small和BM25,与BGE-M3的最大差距仅为2.7点。泰语、阿拉伯语和塞尔维亚语是相对较弱的语言,仍有改进空间。

速度表现
在四种设备(树莓派5到RTX 5090)上,bekko-a8m始终是六款模型中速度最快的。在Ryzen 9 7950X上,使用OpenVINO后端,bekko-a8m每秒可处理364个文档,而multilingual-e5-large仅约12个。在树莓派5上,bekko-a8m每秒33个文档,索引一万个文档仅需5分钟,而multilingual-e5-large需要2小时。
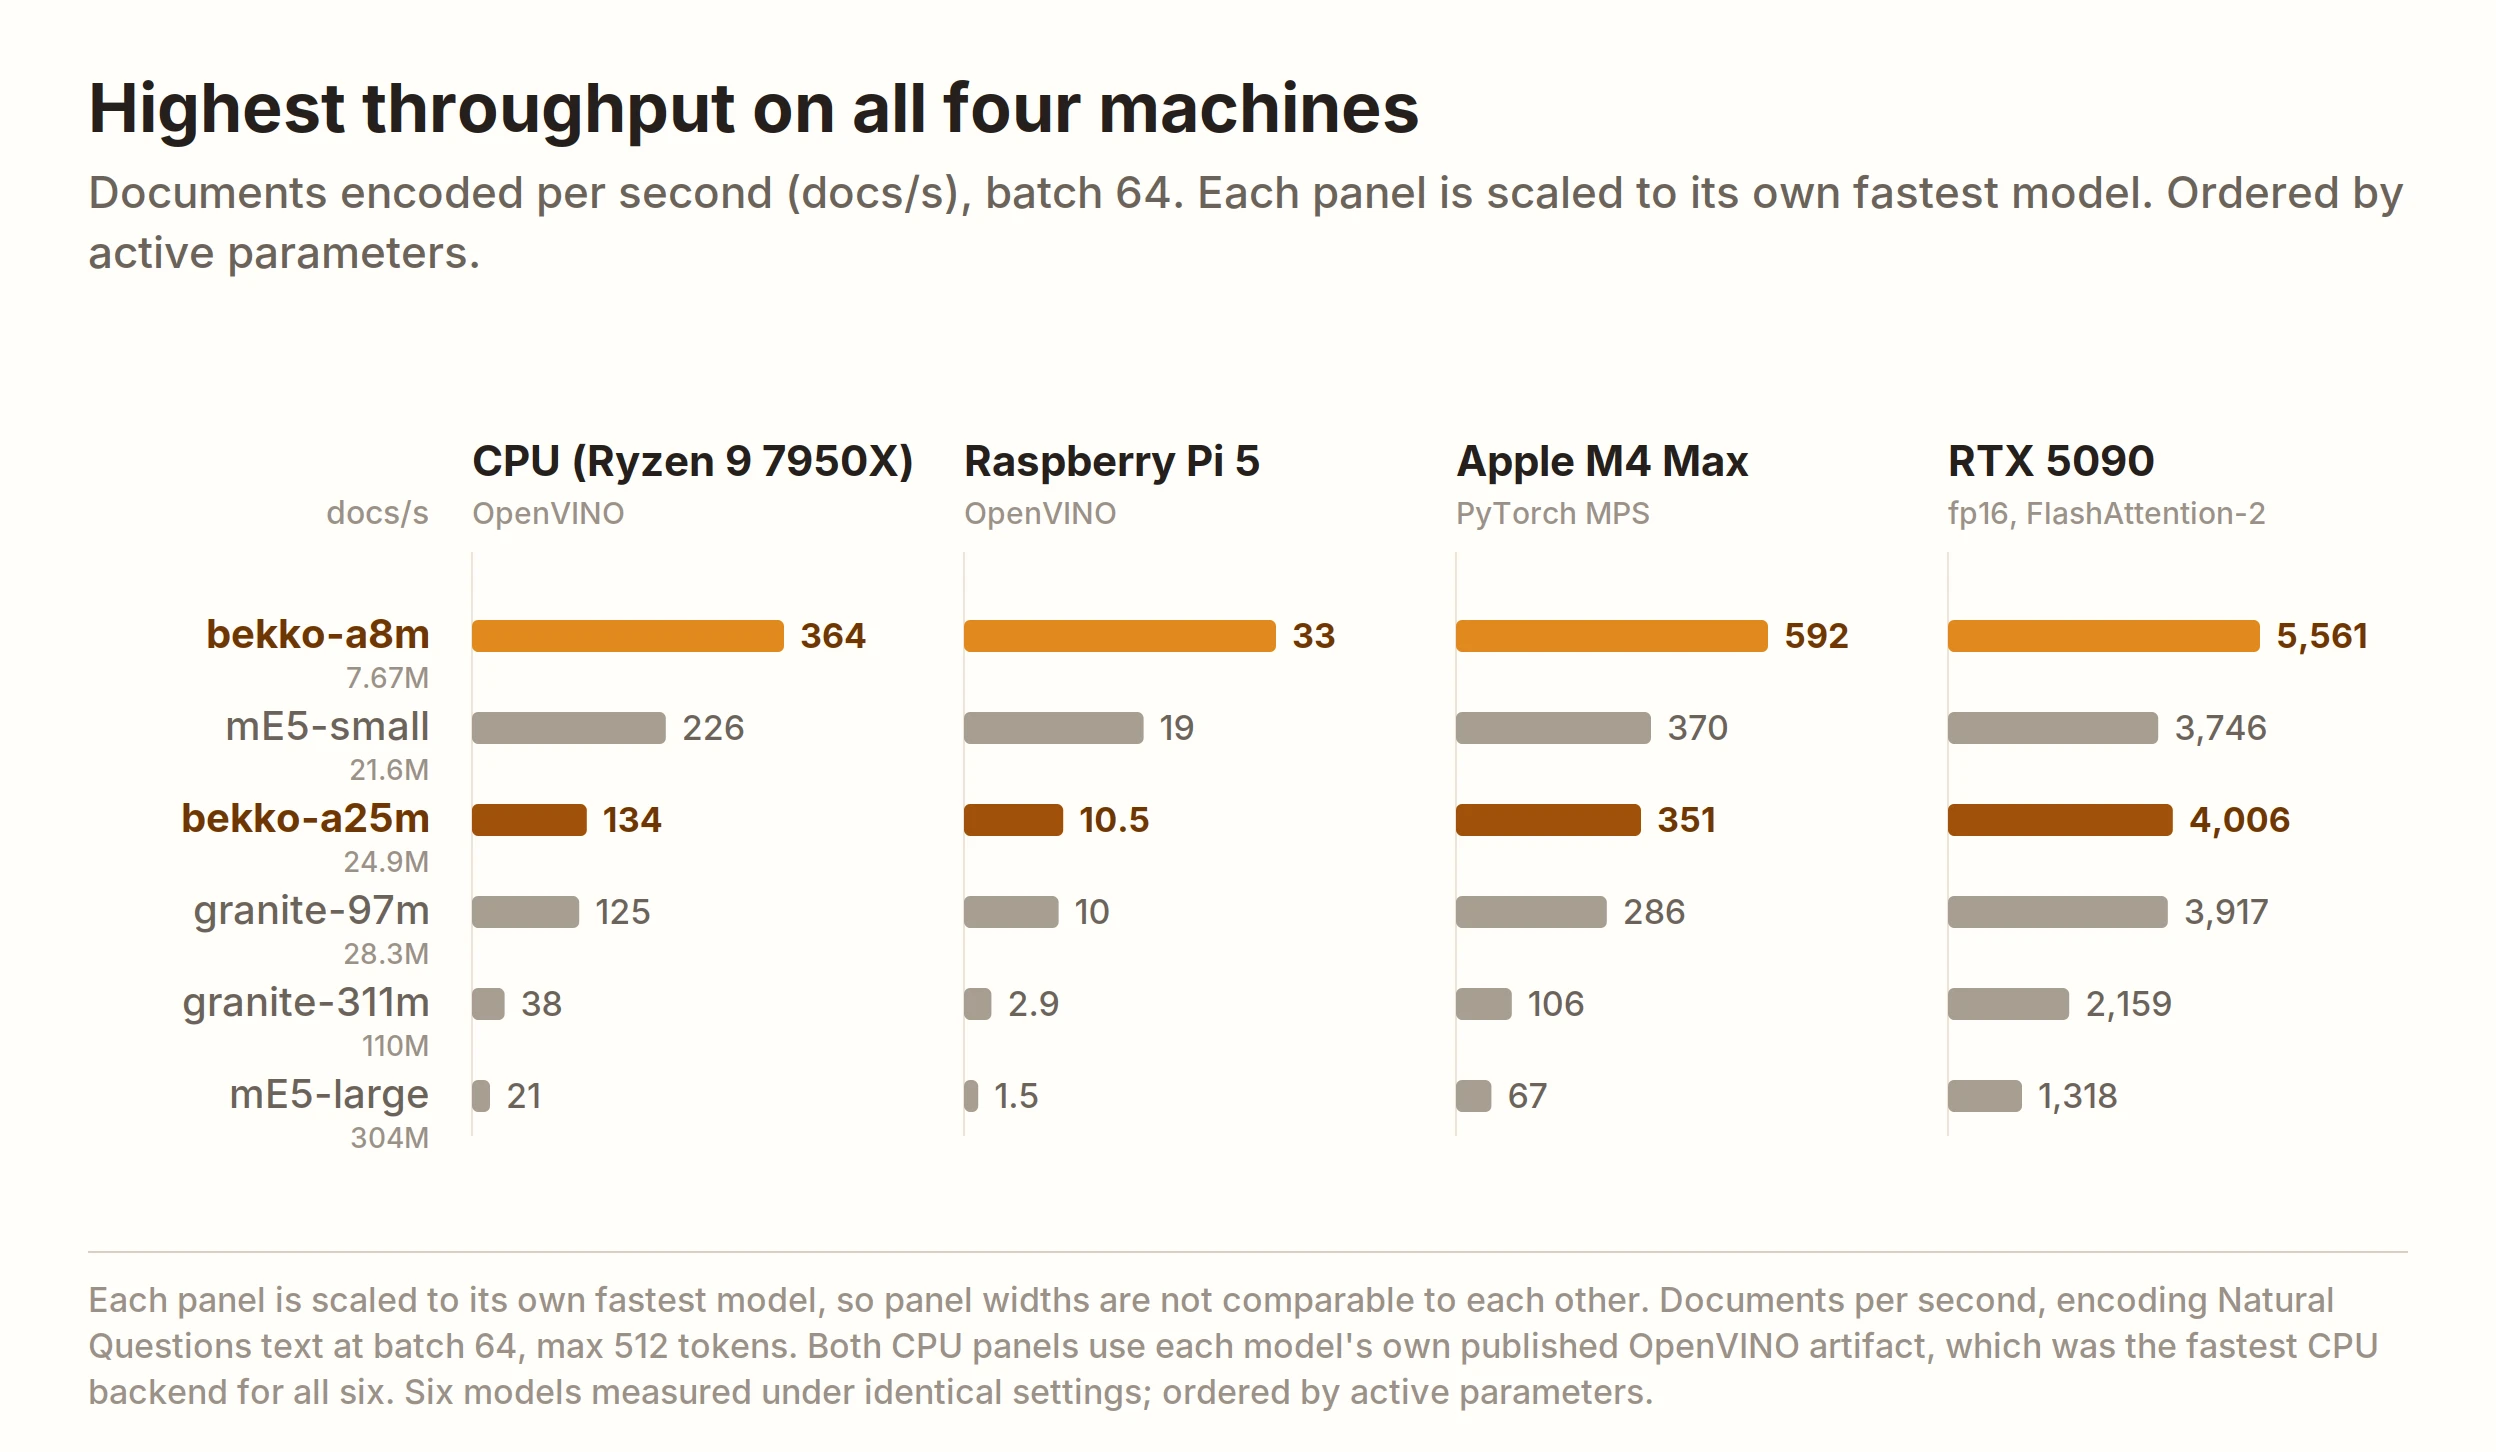
值得注意的是,活跃参数并非唯一决定因素。multilingual-e5-small的活跃参数为bekko-a25m的87%,但CPU吞吐量是其1.7倍。这可能与架构有关:ModernBERT的优化(如unpadding、可变长度FlashAttention)主要针对GPU,而XLM-R风格架构在CPU上映射更高效。
浏览器中的运行
Bekko的ONNX和OpenVINO构建将词嵌入表存储为int8,而Transformer权重保持fp32,使得bekko-a8m的紧凑ONNX工件仅124 MiB,a25m为190 MiB。这足以在浏览器中运行。在WebGPU环境下,bekko-a8m每秒处理187个文档,WASM(CPU)下为51个。浏览器演示完全在客户端运行,文本不会发送到服务器。
适用场景与替代选择
如果追求最佳检索精度且有充足计算资源,harrier-oss-v1-270m、granite-embedding-311m-r2和EmbeddingGemma-300M得分更高。对于通用句子编码任务,Bekko的分类和聚类得分中等偏弱,非检索场景可能其他模型更合适。
快速上手
推荐从a8m开始,适合CPU索引和浏览器检索;a25m适合有GPU或Apple MPS的环境。使用sentence-transformers即可加载,无需前缀。以下示例展示了基本用法:
from sentence_transformers import SentenceTransformer, util
model = SentenceTransformer("hotchpotch/bekko-embedding-v1-a8m")
query = "What are the characteristics of sushi?"
docs = [
"A warm noodle soup served in broth with sliced toppings.",
"天ぷらは魚や野菜に衣をつけて揚げた料理です。",
"Une fine crepe garnie de sucre, de beurre ou de fruits.",
"A Japanese dish made with vinegared rice, often shaped with seafood, vegetables, or egg.",
]
scores = util.cos_sim(model.encode(query, normalize_embeddings=True), model.encode(docs, normalize_embeddings=True))[0]
print("best doc:", docs[int(scores.argmax())])OpenVINO后端在x86上比PyTorch快约2.8倍,在树莓派5上快1.7倍。Transformers.js可在浏览器中运行,支持WebGPU。
训练方法
Bekko的训练分为两个阶段:首先将mmBERT-small从22层剪枝至4层和13层,保留早期层和一个深层全局注意力层;然后在约11亿多语言句对上进行对比学习,包括合成查询和硬负样本挖掘。整个训练在单张RTX PRO 6000 Blackwell Max-Q上完成,a8m约3天,a25m约8天。这展示了小模型在训练成本上的优势,无需GPU集群。
Bekko Embedding证明了在极小规模下实现高质量多语言检索的可能性。对于需要在边缘设备上部署检索能力的开发者,它提供了一个实用且高效的选择。