AI积分总是不够用?一文读懂Token、Credit与上下文窗口的计费逻辑
为什么你的AI积分总是不够用?Token、Credit、上下文窗口一次说清
如果你用过WorkBuddy、CodeBuddy这类AI工具,大概率被这几个词搞晕过:Token、Credit、上下文窗口、缓存命中……账单上扣的是Credit,但底层的计价单位是Token;明明同一个问题问了两次,为什么第二次反而更便宜?对话长了AI为什么突然“失忆”?这篇文章用「人话」把这些问题一次讲清楚。
一、Token:AI世界里的“字”
人类读书按“字”,AI读书按“Token”
我们人类读一篇文章,眼睛扫过去是一个个汉字、一个个单词。但对大模型来说,它根本不认识“字”——它只能处理数字。所以文本在喂给模型之前,必须先做一件事:分词(Tokenization),把人类语言切成一个个小块,每个小块就是一个Token。
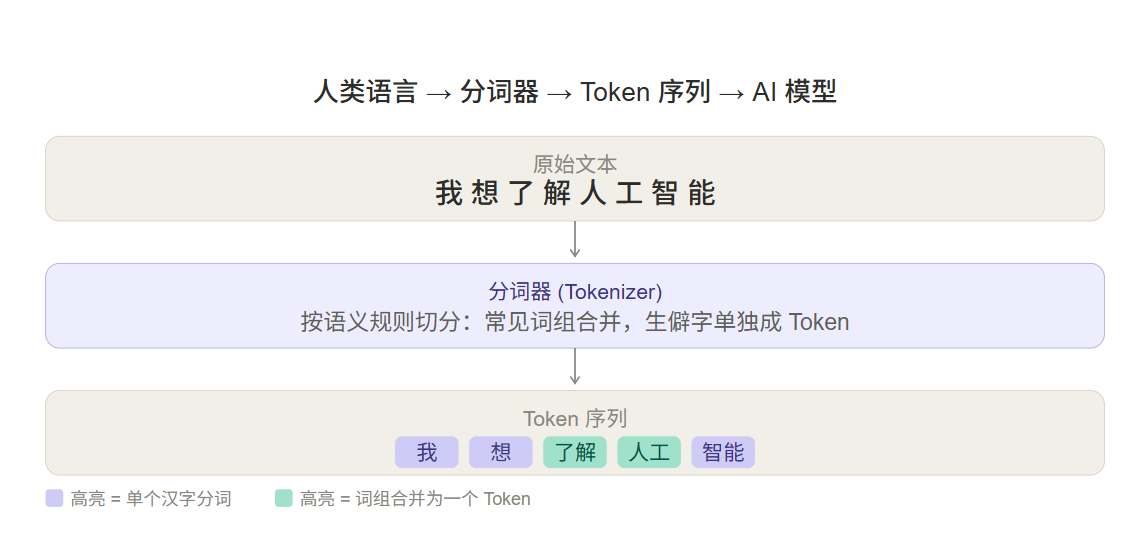
不同语言的分词规则完全不同:
| 语言 | 分词规则 | 换算比例 |
|---|---|---|
| 中文 | 大多以单个汉字为单位拆分,少数高频词组(“人工智能”“了解”)合并为一个Token | 1个汉字 ≈ 1 Token |
| 英文 | 以单词、词根、词缀为单位拆分 | 1 Token ≈ 0.75个英文单词 |
| 代码 | 按运算符、关键字、标识符拆分 | 1 Token ≈ 2-5个字符 |
| emoji/标点 | 单独计为1个Token | 🔥 = 1 Token |
2026年3月,国家数据局正式将Token的标准中文译名确定为**“词元”**。
Token是AI的“通用货币”
所有大模型服务都按Token计价,采用「输入+输出」分离计费模式。一次完整的交互包含两部分:
- 输入Token:你发给AI的所有内容(提问+历史对话上下文+系统提示词)。输入Token的计费相对便宜,因为模型只需要“看懂”这段文本。
- 输出Token:AI逐字逐句回复你的所有内容。输出Token的计费更贵,因为模型需要逐个生成每个Token——背后是一次完整的神经网络前向计算。
输出通常比输入贵2-4倍。这不是厂商随便定价,而是硬件的物理规律决定的:生成一个Token需要模型从头算到尾,而“阅读”一个Token可以利用并行计算一次搞定很多个。打个比方——你读一篇文章可以扫读、跳读,不怎么费劲;但让你自己写一篇,得一个字一个字敲,每个字都要动脑。模型也一样。
以2026年主流模型的公开定价为例:
| 模型 | 输入单价(每百万Token) | 输出单价(每百万Token) | 输出/输入倍数 |
|---|---|---|---|
| 通义千问Turbo | 0.14元 | 0.14元 | 1倍(特例,输入输出同价) |
| DeepSeek-V4-Flash | 1元 | 2元 | 2倍 |
| GPT-5 Mini | 0.81元 | 3.24元 | 4倍 |
| Claude Opus 4 | 32.4元 | 108元 | 3.3倍 |
这意味着什么? 如果你让AI写一篇1000字的文章(约1000输出Token),用GPT-5 Mini的成本约0.003元;但如果你的输入(提问+贴的参考文档)本身就5000 Token,加上1000输出Token,总成本是输入成本的4倍——输入越臃肿,总成本越高。所以精简提问、清理无关上下文能实打实地省钱。
长对话的“回头税”:为什么聊得越久越贵?
这里有一个很容易被忽略的事实:大模型每一次请求都是“无状态”的——它不记得上一轮说了什么。 为了让你感觉它在“连续对话”,系统会把整个历史对话重新打包塞进下一轮请求,让模型从头再读一遍:
第1轮输入:系统提示词 + 你的提问①
第2轮输入:系统提示词 + 你的提问① + AI回复① + 你的提问②
第3轮输入:系统提示词 + ①的完整对话 + ②的完整对话 + 你的提问③这就是Token消耗的滚雪球效应。假设每轮新增1K Token(提问0.5K + 回复0.5K),用128K上下文窗口:
| 轮次 | 输入Token(塞了多少历史) | 输出Token | 本轮合计 |
|---|---|---|---|
| 第1轮 | 0.5K | 0.5K | 1K |
| 第2轮 | 1.5K(含第1轮全部) | 0.5K | 2K |
| 第3轮 | 2.5K(含前2轮全部) | 0.5K | 3K |
| 第10轮 | 9.5K | 0.5K | 10K |
| 第50轮 | 49.5K | 0.5K | 50K |
| 第128轮 | 127.5K | 0.5K | 128K |
注意:第50轮和第一轮问的内容可能毫无关系——但前49轮的所有对话照样原封不动塞进去。系统不判断相关性,它只是机械地把窗口里的一切搬过去。
不过大可放心——上述是极端场景。日常几百字的问答聊天,几十轮下来累计Token也就一两毛钱、折合不到1个Credit。只要你不是一个窗口从早挂到晚、每轮都在贴大文件,聊天的Token账单增长很慢的;
以DeepSeek-V4公开API定价为例:输入1元/百万Token,输出2元/百万Token。
WorkBuddy专业版58元=2000 Credits,也就是1 Credit的“成本价”约0.029元。
粗略计算:1 Credit ≈ 2万Token(DeepSeek-V4对话场景)。
但这只是“API原价倒推”的理论值。WorkBuddy后台有平台溢价、多模型混用、推理加成等变量,实际可能在这个数量级的附近波动。日常聊天一次几百Token,一个Credit能撑几十轮,不用担心。
二、上下文窗口:AI的“短期记忆”
什么是上下文窗口?
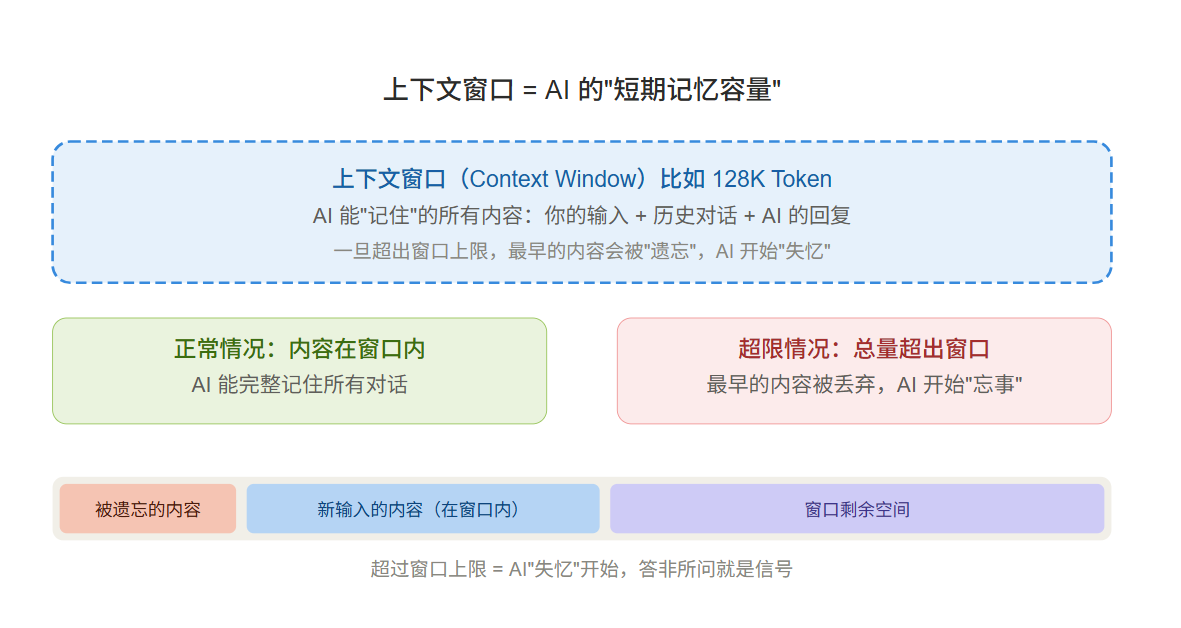
在你和AI的每一次对话中,AI并不是“读完就忘、只回答最后一句话”——它会把你之前说的所有内容(包括它自己的回复)都打包放在一个叫“上下文窗口”的地方。这个窗口能放的内容总量是有限的,就是“上下文长度限制”。
打个比方:上下文窗口就像AI面前的“临时便签纸”。每轮对话都会往这张纸上写字,纸写完就不能再加了——AI会自动擦掉最上面的内容,给新内容腾地方。所以当对话变得特别长时,你会发现AI开始“忘事”——那是因为最早的内容已经被擦掉了。
各大模型的上下文窗口有多大?
| Token上限 | 约等于汉字数 | 能做什么 |
|---|---|---|
| 4K Token | 约3,000汉字 | 短对话、简单问答 |
| 32K Token | 约2.4万汉字 | 长文档总结、代码分析 |
| 128K Token | 约10万汉字 | 一次性处理长篇小说,复杂多轮对话 |
| 1M Token | 约70-80万汉字 | 超长篇文档与大规模知识库检索 |
WorkBuddy中如果你发现AI突然“答非所问”“忘记前面说过的话”——这就是上下文窗口溢出的信号。 此时应该开新对话,而不是继续在当前对话里追问。
为什么上下文窗口不能无限大?
核心原因是注意力机制(Attention Mechanism)的计算复杂度为O(n²)。
这句话用人话翻译就是:模型在处理文本时,需要计算每两个Token之间的“关联度”——第1个Token和第2个、第3个……一直到第n个,全都要两两配对算一遍。所以如果有n个Token,就要做n × n = n²次计算。如果Token数量翻倍,计算量不是翻倍,而是翻4倍;翻10倍,计算量翻100倍。
具体地看:
| Token数 | 需要计算的“关联对”数量 | 相比4K的倍数 |
|---|---|---|
| 4K (4,096) | ~1,678万对 | 基准 |
| 32K | ~10.7亿对 | 64倍 |
| 128K | ~16,384亿对 | 1,024倍 |
| 1M | ~10,000亿对 | 62,500倍 |
这就是为什么越大的上下文窗口,一次对话消耗的Credits越多:不仅Token数量在涨(线性),单个Token的处理成本也在暴涨(平方级)。 128K窗口不是4K窗口的“32倍成本”,而是接近“1000倍”。这也解释了为什么现在所有大模型都在拼命优化注意力机制(FlashAttention、稀疏注意力等)——不是为了让窗口变大,而是为了让大窗口用得起。
三、缓存机制:为什么同一个问题问第二遍更便宜?
这是本次最有意思的知识点。先看一个场景:
你上传了一份5000字的合同让AI分析,问:“帮我总结关键条款”。AI读完合同、给出总结,消耗了约8000 Token。 紧接着你又问:“第三个条款有没有风险?”AI这次没有从头读合同——因为它已经把合同的处理结果“缓存”起来了,直接复用。
这就是缓存机制的核心:同样的内容不重复计算,省时间又省钱。
缓存命中 vs 缓存未命中
当我们说“缓存”时,指的是KV缓存(KV Cache):模型在处理文本时,会为每个Token生成K(Key)和V(Value)两组向量数据。这些数据占显存,但未来如果遇到相同的前缀内容,可以直接复用而不用重新计算。
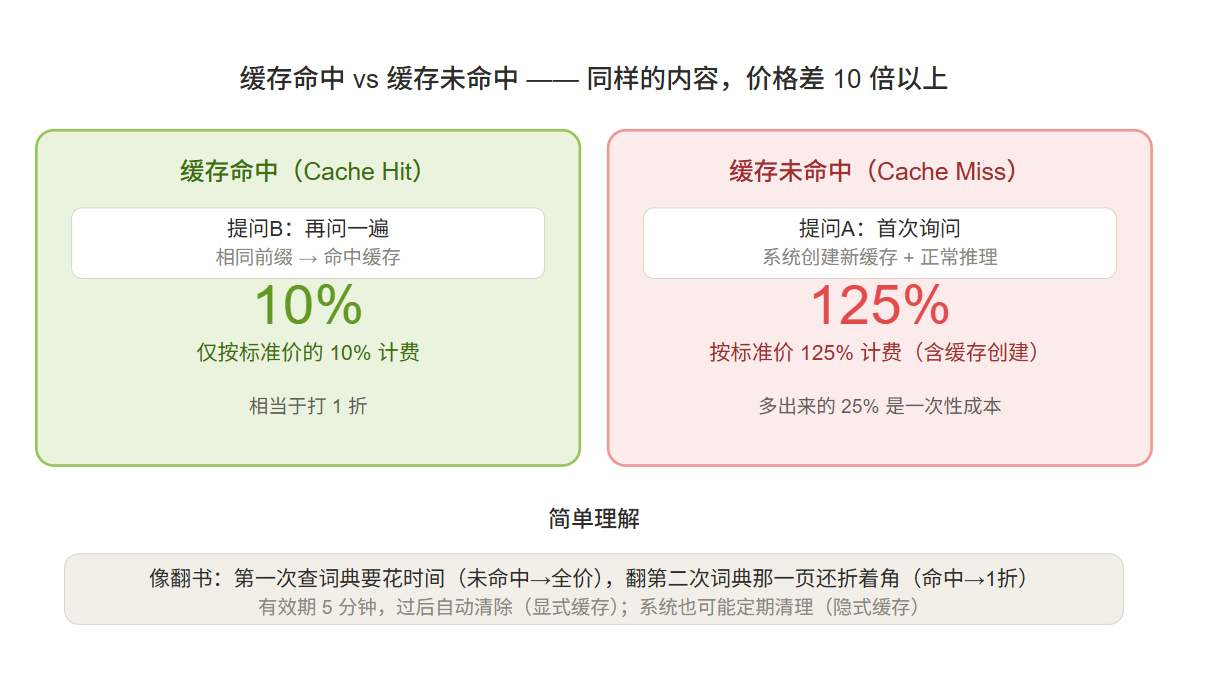
| 状态 | 含义 | 计费(显式缓存) | 计费(隐式缓存) |
|---|---|---|---|
| 缓存命中 | 请求的文本前缀与已有缓存匹配 | 标准价的10% | 标准价的约20% |
| 缓存未命中 | 文本前缀无匹配,需新建缓存 | 标准价的125% | 标准价的100% |
一句话理解:第一次问按全价(甚至多收25%建缓存费),第二次问同样的前缀按1折,比第一次便宜10倍以上。
翻词典的比喻
这就像翻词典:第一次查一个生词,你要翻开目录,找到页码,翻到那一页,读解释——这是“缓存未命中”(全价+建缓存成本)。如果你马上又查同一个词,手指还夹在那一页——这是“缓存命中”(1折),因为你没有重新走全套流程。
缓存的几个关键规则
- 有效期5分钟(显式缓存):命中后重置,5分钟没人用就过期
- 最少1024 Token才能触发显式缓存;最少256 Token触发隐式缓存
- 前缀必须一致:缓存只匹配“开头相同的部分”,如果改动了系统提示词的第一句话,整个缓存就失效了
- 账号间隔离:你的缓存只有你自己能用,不会跟别人共享
这个对WorkBuddy用户意味着什么?
- 多轮对话天然省钱:你在同一对话里连续追问,AI缓存了之前的内容,后续请求的输入Token命中率高得多
- 复制粘贴后追问也是省钱的:你贴了一份长文档让AI分析,再追问几次,第二次开始自动命中
- 不要随便改动前几句话:如果每次提问都先换系统提示词,缓存就白建了
四、Credit:套在Token外面的“壳”
为什么要多这一层?
如果WorkBuddy直接按Token计价,会出现一个问题:同样是1000 Token,用便宜模型只要几分钱,用高端模型可能要几毛钱。 作为用户,每次都要算“我用的是什么模型、这个模型多少钱、我这次对话花了多少Token”——太累了。
所以WorkBuddy引入了一层封装:Credit(积分)。它把所有模型的差异打包进去,用户只需要看一个数字。
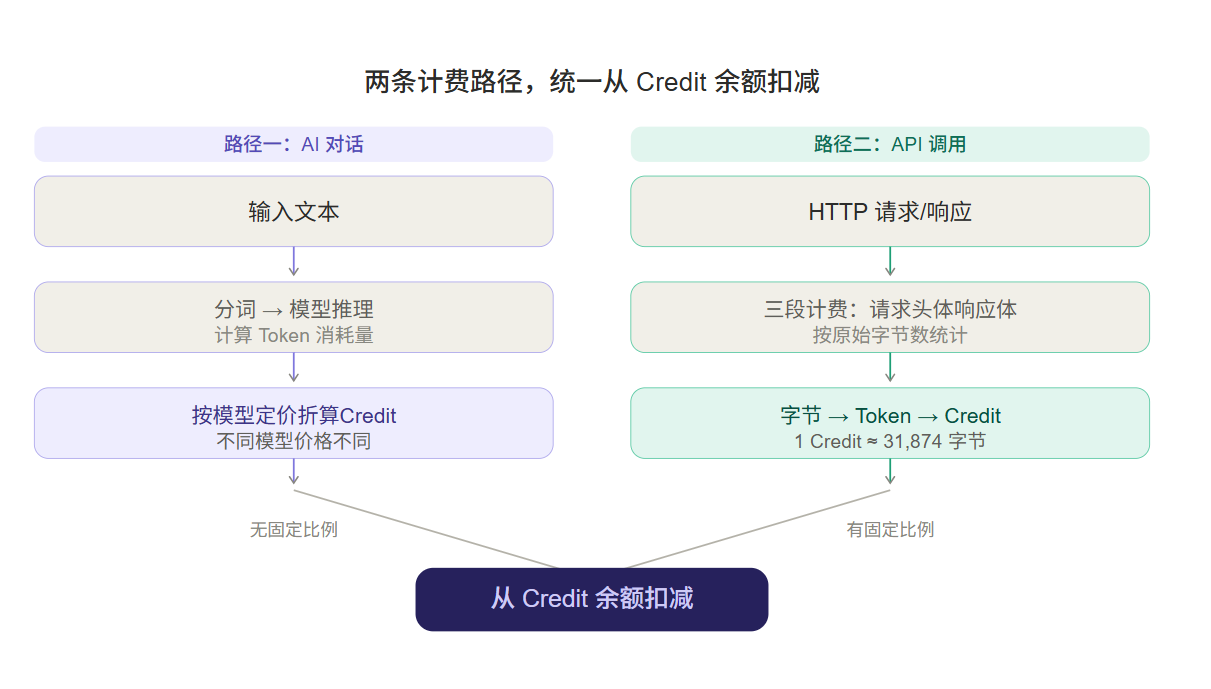
两条完全不同的计费路径
这里是最容易混淆的地方:WorkBuddy内部其实有两条完全不同的计费路径,换算比例天差地别。
路径一:AI对话——因模型而异,没有固定比例
这是你日常使用的场景:和AI聊天、让它写代码、分析文档。
同一个问题用不同模型问,同样的Token数,Credit消耗完全不同:
| 场景 | 使用模型 | Token消耗 | Credit消耗(估算) |
|---|---|---|---|
| 问“今天星期几” | DeepSeek-V4-Flash(轻量) | ~50 Token | ~0.02 Credit |
| 问同一个问题 | GLM-5.0-turbo(强力) | ~50 Token | ~0.5 Credit |
| 分析一篇3000字长文 | DeepSeek-V4-Flash | ~8,000 Token | ~2 Credit |
| 分析同一篇长文 | Claude(推理增强) | ~8,000 Token | ~10 Credit |
结论:对话场景里,没有“1 Credit = 多少Token”的固定答案。 官方文档原文也说:“具体消耗数量因任务复杂度及所用高级模型而异。”
路径二:API连接器调用——按字节折算,有固定比例
这是你在WorkBuddy里调用飞书、GitHub、企业微信等外部接口时的场景。这里的计费逻辑完全不同——不算模型、不算推理,纯按HTTP请求/响应的字节数来算。
API调用的“三段计费模型”:
| 组成部分 | 计费方式 |
|---|---|
| 请求头+URL+查询参数 | 按字符数折算为Token |
| 请求体(Body) | 按UTF-8原始字节数折算 |
| 响应体(Response Body) | 按原始字节数全额计入(无论你是否用到) |
三步相加→折算为Token→再折算为Credit:
1 Credit ≈ 31,874字节
一个具体例子:
| 操作 | 数据量 | Token消耗 | Credit消耗 |
|---|---|---|---|
| 发一条飞书消息(URL+请求体+响应≈232字节) | ~232字节 | ~232 Token | <0.01 Credit |
| 调用一个返回1MB JSON的内部API | ~1,048,576字节 | ~100万Token | 30+ Credits |
同样的Credit,在对话场景可能聊好几轮,在API场景可能一个重响应就没了。 这也是为什么很多人觉得Credits跑得莫名其妙快——很可能是因为工作流里某个连接器返回了大量不必要的数据。
五、一张图看清完整模型
回到最核心的问题:为什么WorkBuddy不直接说“1 Credit = X Token”?
因为给了反而误导。真实原因是:
Credit消耗 = 模型单价 × 任务复杂度 × Token数量
              ↑            ↑            ↑
          可选的         变化的        可衡量的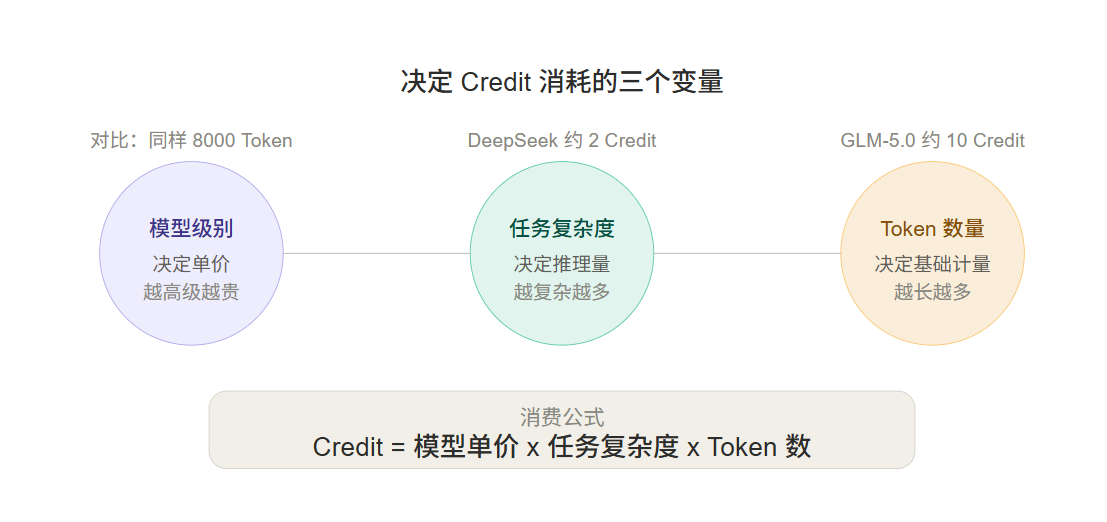
Token是唯一的确定量,另外两个变量在每次对话中都可能不同。 再加上上下文窗口越用越满、缓存有时命中有时不命中——实际消耗是一个动态的、多变量叠加的结果。所以任何固定比例都只能是参考值。
六、实际使用参考
与其纠结换算公式,不如看实际效果。以下是社区实测的大致参考:
| Token消耗量 | 典型场景 | Credit消耗(DeepSeek-V4) |
|---|---|---|
| ~50 Token | 轻量对话(问路、问天气) | ~0.02 Credit |
| ~1,000 Token | 中等任务(写函数、改Bug) | ~0.5-2 Credit |
| ~8,000 Token | 长文档分析(3000字文章) | ~3-10 Credit |
| ~50,000 Token | 大型项目(重构模块+多轮对话) | ~20-60 Credit |
关于缓存的实际效果:如果你在同一对话里连续追问同一个长文档,第二问开始的Token大多数会命中缓存,实际Credit消耗只有第一问的10%-20%。这也是为什么“多轮追问”比“每次开新对话然后贴文档”更省钱。
七、六个省钱的实用技巧
对话场景
- 经常开新对话:历史对话越长,每次请求的输入Token越多。长对话不会因为缓存而完全免费——缓存的只是KV数据(算力成本),Token本身的计价依然存在。
- 轻量模型先试、强力模型再求精:用DeepSeek-V4-Flash先跑思路,确认没问题了再用高端模型优化输出。
- 开启推理(Thinking)会显著增加Token消耗:能用普通模式搞定的就别开推理。
API调用场景
- 精简请求体:删掉
"timestamp"、"debug": true这种无关字段。 - 限制响应大小:在连接器里勾选「仅提取指定路径」,手动填入
$.data——避免加载整棵JSON树。 - 关掉不必要的「失败重试」:一次失败×3次重试=3倍费用,而且错误响应(如500页面的HTML)往往比正常响应更大。
八、一句话总结
| 概念 | 一句话 |
|---|---|
| Token | AI世界里的“字”,1000汉字≈1000Token,输入和输出分开计价 |
| 上下文窗口 | AI的“临时便签纸”,写满了最早的内容就会被擦掉,越大越贵(O(n²)) |
| 缓存命中 | 同样的内容第二遍只收1折,因为读缓存不重算 |
| 缓存未命中 | 初次计算要加收25%建缓存费,但下次就便宜了 |
| Credit | WorkBuddy套在所有概念外面的统一消费单位,你不需要关注底层怎么算 |
| 二者的关系 | 对话无固定比例,API有固定比例。记住:轻量模型省钱、短上下文省钱、缓存命中更省钱 |