DriveTeach-VLA:如何让自动驾驶模型真正“看懂”路况?
引言:VLA模型的“知行不合一”困境
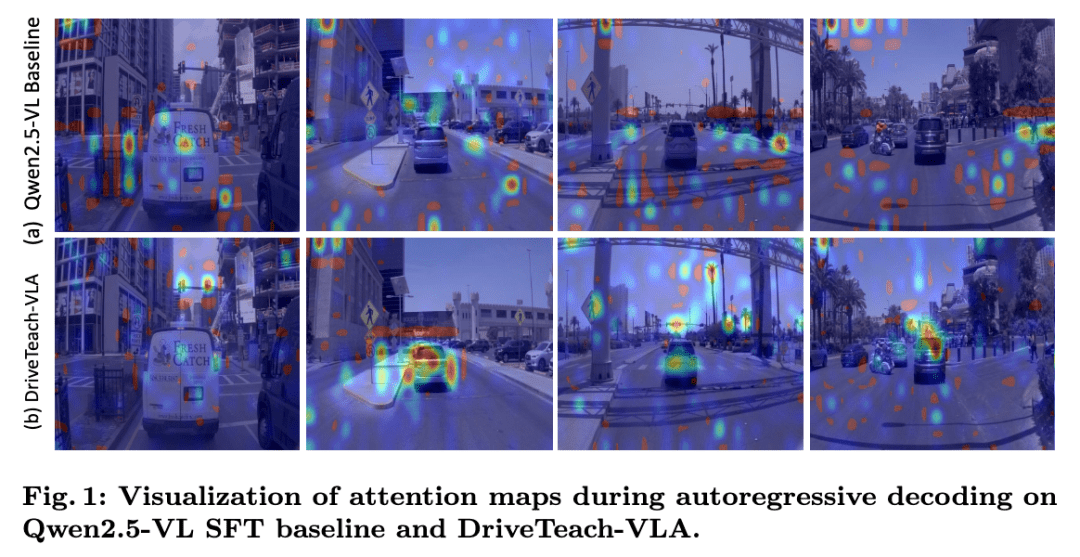
想象一个场景:自动驾驶车辆准备左转,右侧有行人靠近斑马线,前方大车遮挡部分视野。得益于多模态大模型的强大预训练能力,视觉-语言-动作模型(VLA)能流畅描述应对措施:“减速、观察、礼让行人,再左转”。但真正决定安全的,是模型生成轨迹时究竟“看”向了哪里——它有没有盯住行人?有没有理解被遮挡区域?所谓“左转”,是否对应到画面中真实可行驶的车道?
论文通过直观例子展示了这一机制的必要性。图(a)中,一个基于Qwen2.5-VL的VLA基线模型,其注意力分布分散,没有明确焦点。作者分析,这种注意力失焦源于现有VLA训练方式:将大语言模型当作大型拟合器,独立学习输出思维链和轨迹,却未真正理解两者间的关联。
研究背景:VLA训练的数据偏差
当前VLA训练依赖大量以文本为中心的视觉问答(VQA)和思维链(CoT)数据,这类数据强调语言推理,而非基于动作的规划。模型学会了“说”,却未必学会“做”。清华、北航、滴滴等机构的研究团队提出DriveTeach-VLA,旨在纠正这一偏差,让模型在轨迹推理时关注语言推理中涉及的视觉要素,从而影响轨迹生成。
方法:三阶段教学
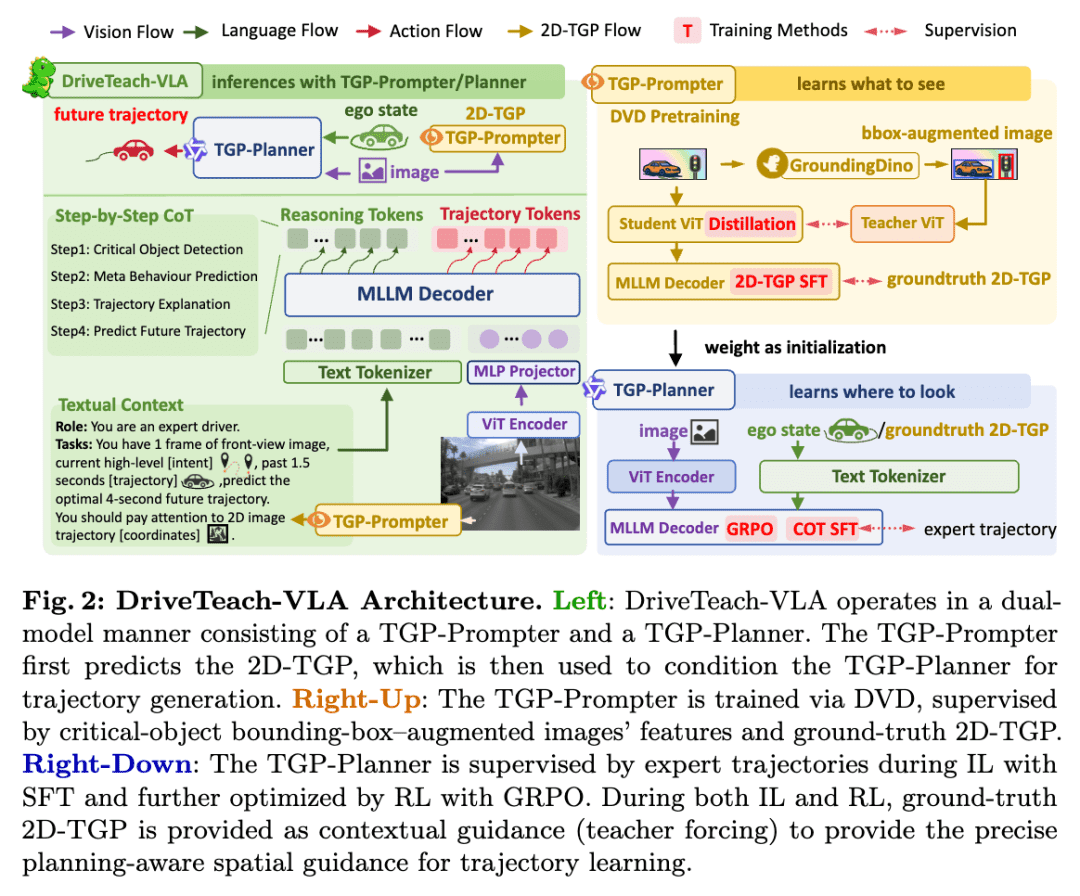
DriveTeach-VLA将训练拆解为三件事:先教模型识别什么值得看(What to See),再告诉它未来应看向哪里(Where to Look),最后校正它怎么开(How to Drive)。
第一课:驾驶知识蒸馏(DVD)
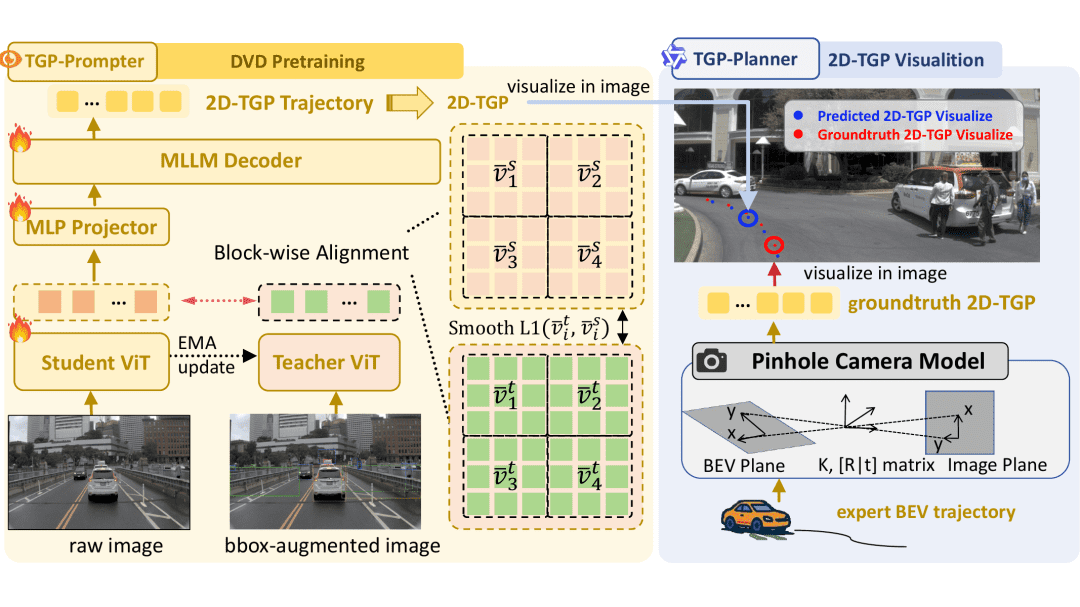
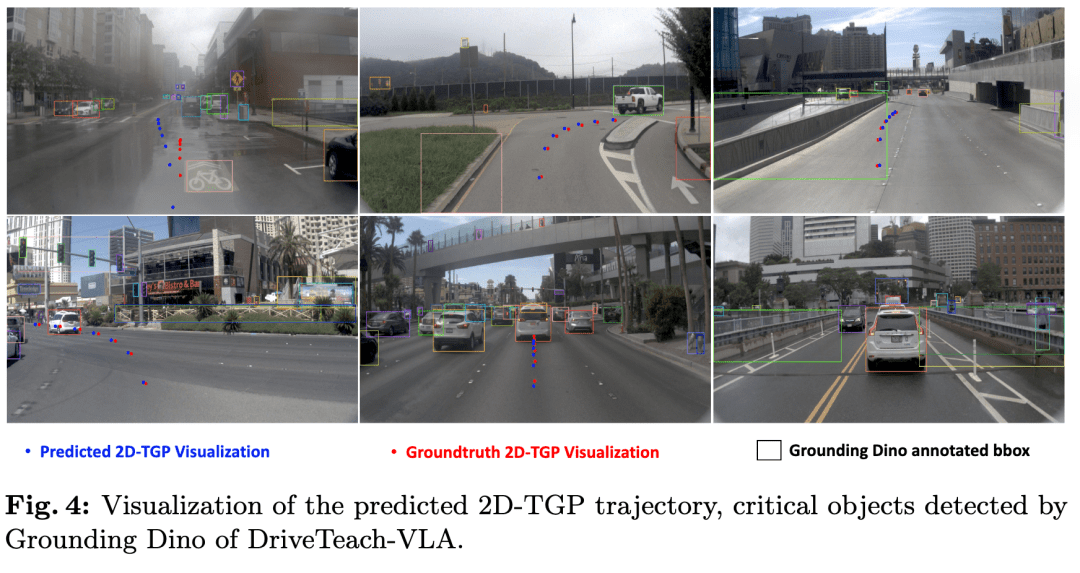
VLA基座在预训练中见过海量图片,但并非所有视觉信息对驾驶同等重要。DriveTeach-VLA设计驾驶感知视觉蒸馏(Driving-aware Vision Distillation, DVD),利用GroundingDINO标注车辆、行人、路障等关键对象,通过自蒸馏将注意力引导至这些交通要素。
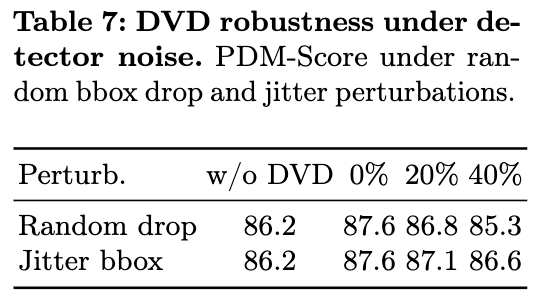
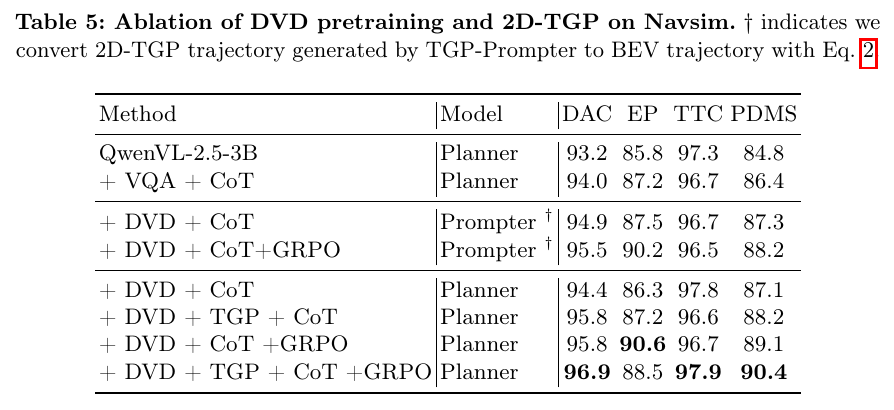
具体实现:将VLA基座的ViT复制为学生和教师两个分支。教师ViT接收带有边界框标注的图像,注意力自然偏向标注区域;学生ViT仅读原图,通过块级感知蒸馏学习教师矫正后的特征。实验表明,DVD带来约1.4 PDMS提升,且对标注噪声鲁棒。
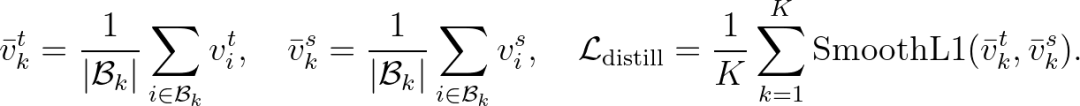
第二课:2D轨迹引导提示(2D-TGP)
多模态基座受益于预训练,对交通场景理解易适配,但自动驾驶规划通常在鸟瞰(BEV)坐标系输出轨迹,这种坐标对基模而言难以直接理解。DriveTeach-VLA引入2D轨迹引导提示(2D-TGP):利用相机内外参,将专家轨迹从BEV投影到图像平面,得到像素坐标序列,再组织成文本提示输入VLA。
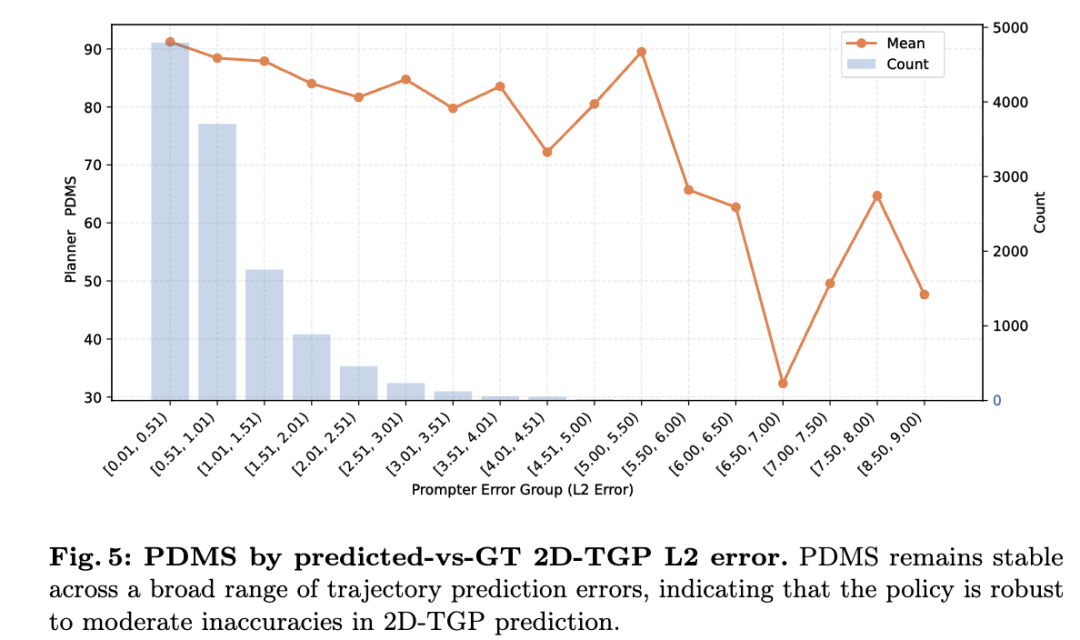
系统采用两个Qwen2.5-VL-3B模型:TGP-Prompter预测图像平面上的2D-TGP,TGP-Planner结合图像、状态、指令及2D-TGP生成BEV轨迹。训练时使用真值2D-TGP,推理时使用预测值,存在teacher-forcing差距,但实验表明图像轨迹预测准确,且对最终性能影响可控。
实验与结果
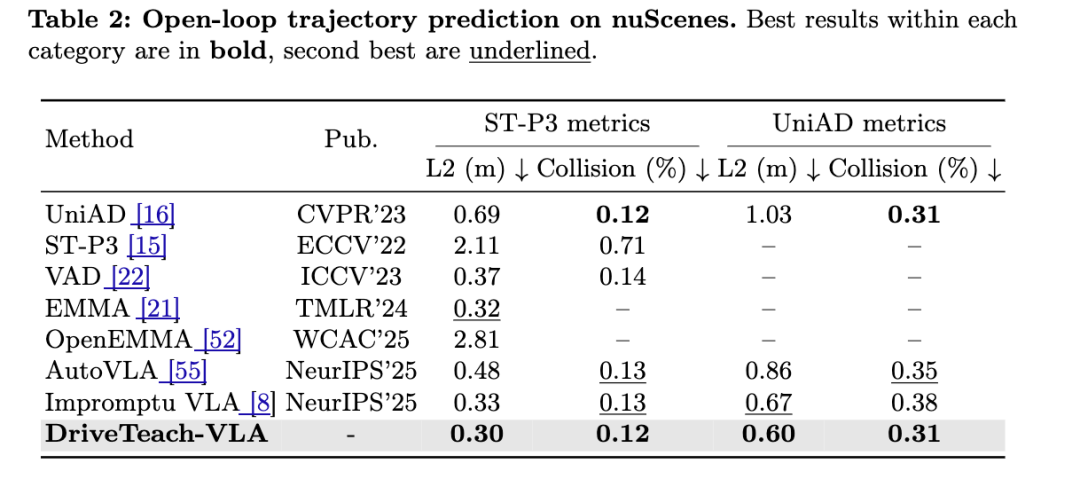
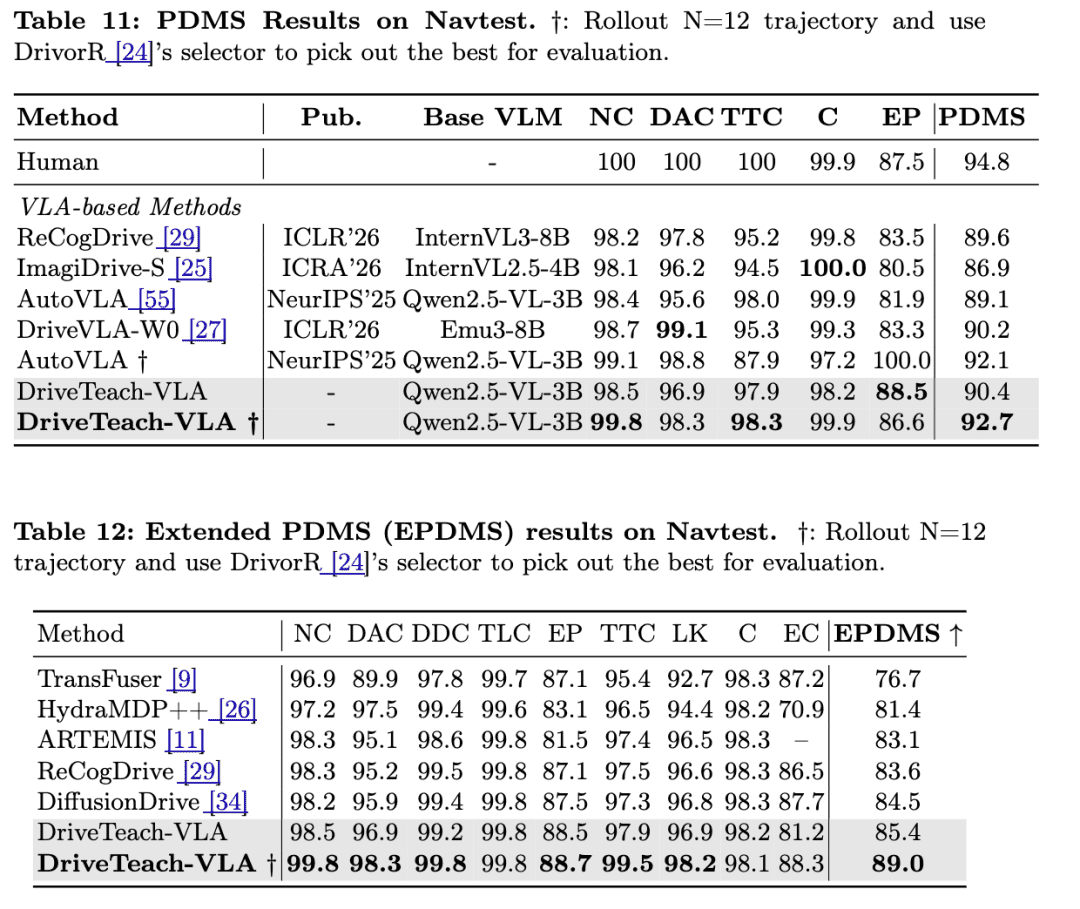
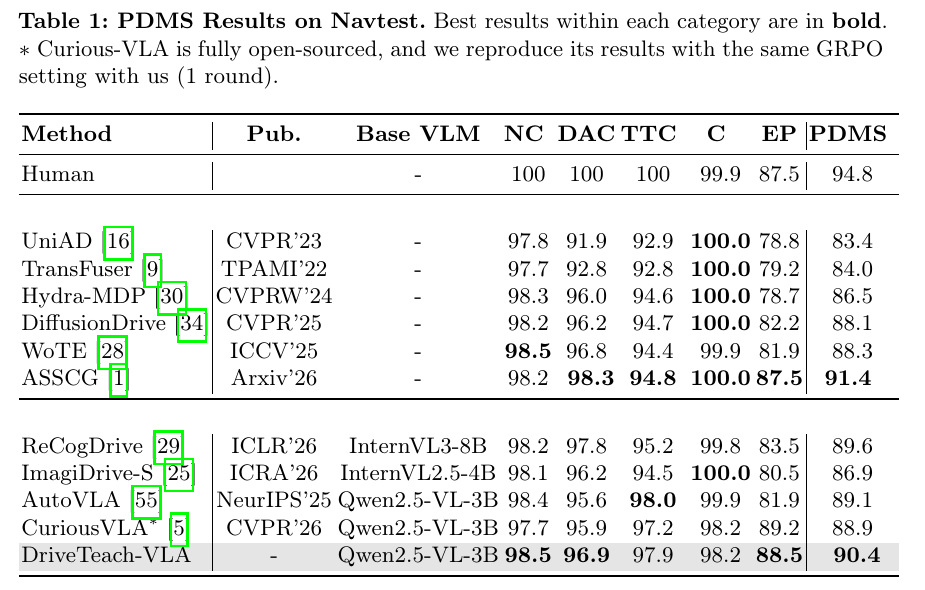
在NAVSIM上,Qwen2.5-VL-3B基线PDMS为84.8;加入VQA与CoT后升至86.4;继续加入DVD达87.3;加入2D-TGP后为88.2;经GRPO行为对齐,完整系统达到90.4 PDMS、85.4 EPDMS。在nuScene上,L2误差仅0.3。
值得注意的是,提升并非来自模型规模(仍为3B),而是监督方式和中间接口的改变。当模型具备基本语言推理能力后,直接的空间监督比增加文本更高效。此外,DriveTeach-VLA未引入扩散或连续MLP映射层,仅靠基模自回归推理,继承了大语言模型的采样特性。若允许每场景生成12条候选轨迹,再由DrivorR选择器挑选,PDMS可提升至92.7,EPDMS达89.0,虽实际运行不可行,但为后续蒸馏研究指明方向。
总结与展望
DriveTeach-VLA的核心价值在于建立了BEV轨迹与基模识图能力之间的桥梁,降低了对大规模标注数据的依赖,使模型直接理解轨迹的空间含义。结合前作CuriousVLA(纯多模态大模型路线),提供了一种VLA scaling蓝图:用多模态基座承担场景理解,用显式空间提示连接BEV与图像,最终通过自回归推理实现规模化。
这项研究为VLA训练提供了新视角:与其堆叠更长的思维链,不如教会模型“看哪里”。未来,如何进一步优化2D-TGP预测精度,以及如何将候选轨迹选择策略融入单次推理,将是值得探索的方向。