83亿数字人模拟地球:AI用户测试新范式如何颠覆产品研发
从《西部世界》到现实:83亿数字人的诞生
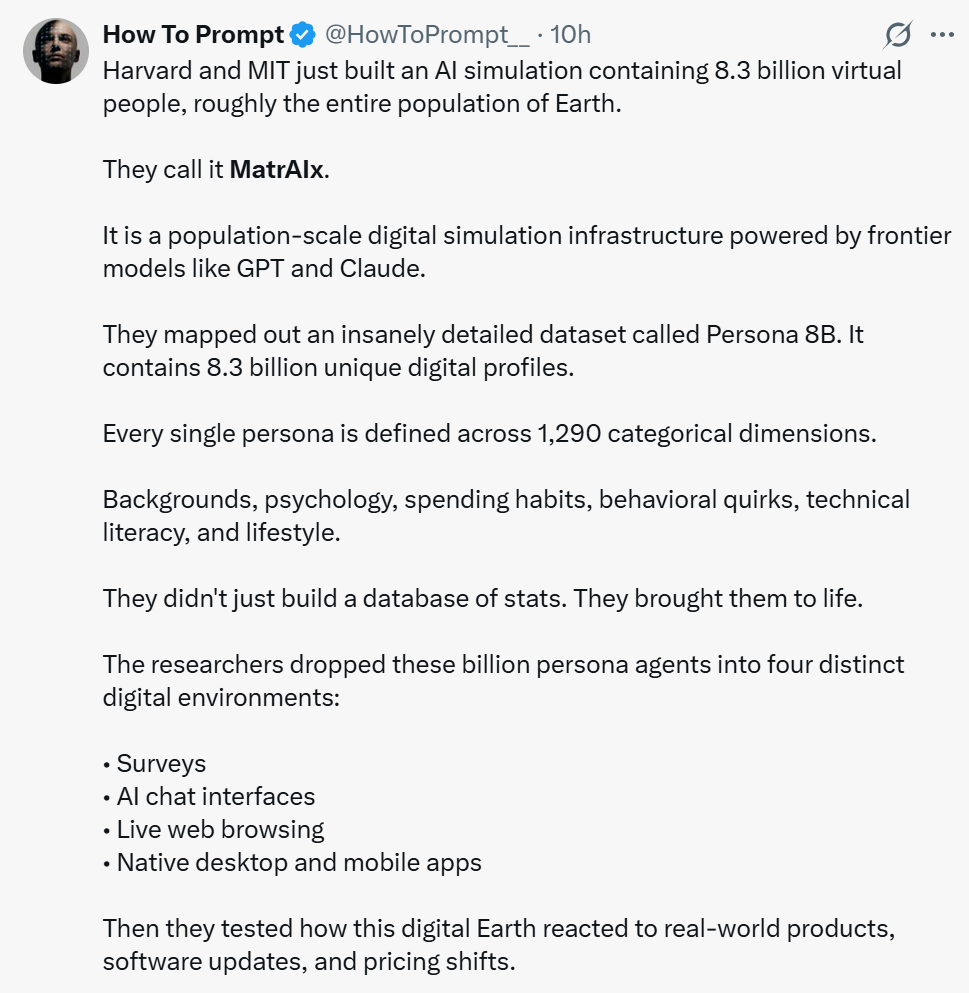
还记得《西部世界》里那些栩栩如生的接待员吗?他们拥有完整的人格、记忆和情感,在乐园里过着各自的生活。如今,哈佛、MIT、斯坦福等顶尖机构联合推出的MatrAIx系统,将这一概念推向了极致——他们创造了83亿个数字人,数量几乎与地球人口持平。
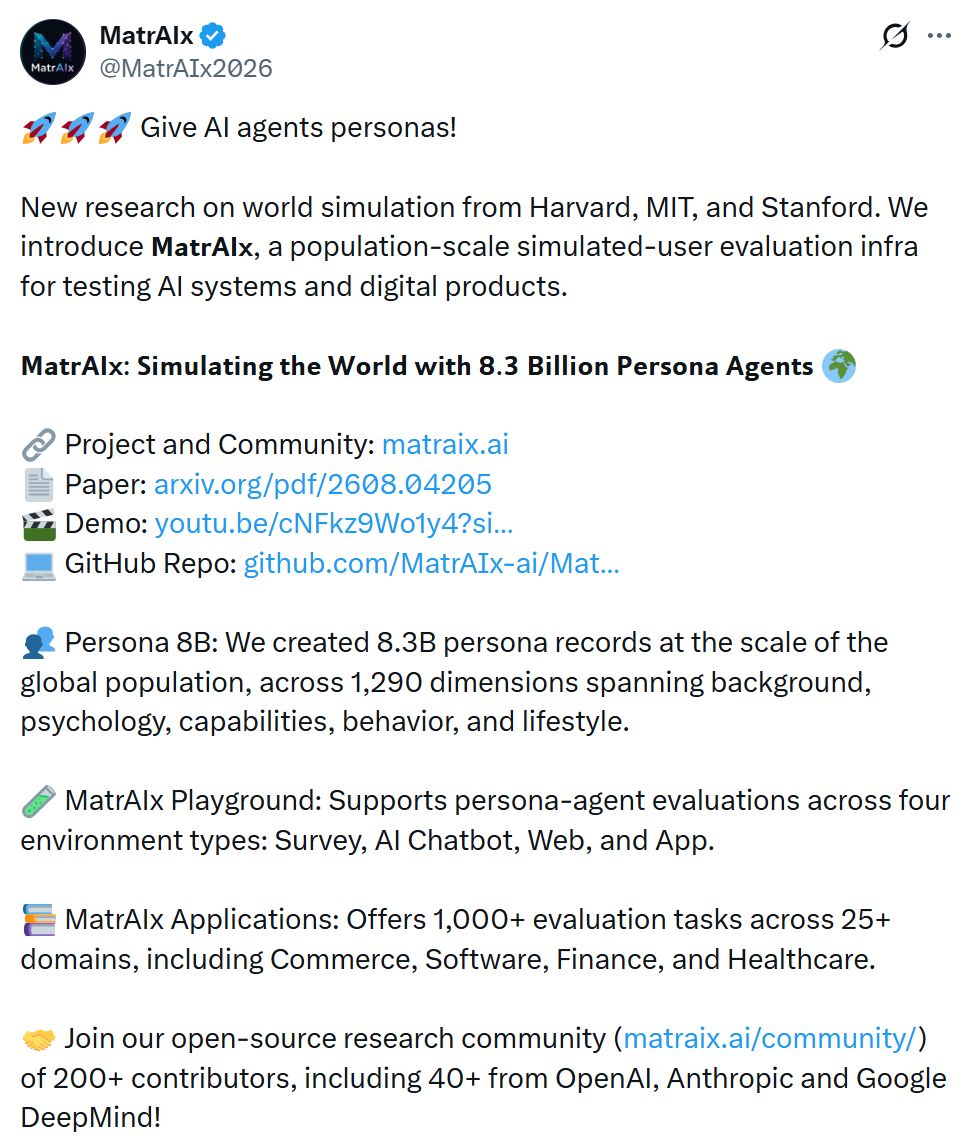
这听起来像是科幻小说的情节,但MatrAIx确实做到了。每个数字人都拥有多达1290个维度的详细人设,包括年龄、职业、地区、语言、性格、消费习惯、风险偏好等。这些人设被注入GPT-5.5、Claude Opus 4.8等先进大模型中,让它们真正地“生活”在数字世界里:浏览网页、与AI聊天、填写问卷,甚至打开Apple News+,看完内容后考虑是否值得每月支付12.99美元。
更令人惊叹的是,这些数字人展现出了真实的个性差异。面对同样的涨价,有人犹豫不决,有人毫不在意;当AI助手犯错时,有人愿意再给一次机会,有人直接放弃。研究团队进行了18189次测试,发现91.5%的行为与设定的人格特征高度一致。
为什么需要83亿个数字人?
传统的产品测试流程往往耗时耗力。一个App上线前,需要招募用户、发放问卷、进行访谈、跑测试,整个过程可能需要数周甚至数月,成本高昂且覆盖范围有限。
MatrAIx的核心理念是:通过赋予大模型人格,使其模仿多样化的用户群体,从而高效完成大规模评测。这解决了传统测试的三大痛点:
- 成本高:招募真实用户需要支付报酬,而数字人无需任何费用。
- 耗时长:真实用户测试需要协调时间,数字人可以24/7不间断工作。
- 覆盖率低:真实用户样本通常有限,而83亿个数字人几乎覆盖了全球所有人口特征。
MatrAIx技术架构深度解析
MatrAIx评测平台由三个核心部分组成:Persona-8B人格数据库、四类仿真环境、多领域评测任务。
Persona-8B:1290维人格数据库
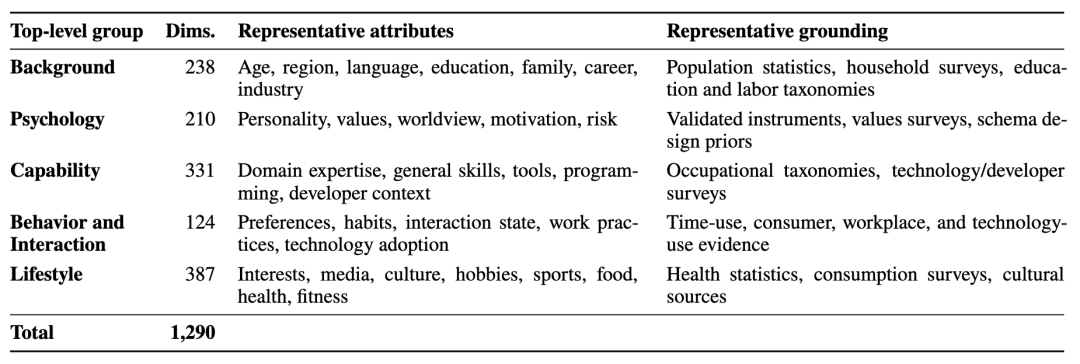
Persona-8B包含83亿份人格记录,每份记录基于标准化的1290个维度,分为五大类:
- 背景信息(238维):包括年龄、性别、教育、职业、收入等。
- 心理特征(210维):涵盖性格特质、价值观、风险偏好等。
- 能力信息(331维):涉及专业技能、语言能力、认知水平等。
- 行为与交互习惯(124维):包括使用设备的偏好、社交习惯等。
- 生活方式(387维):涉及消费习惯、娱乐偏好、健康习惯等。
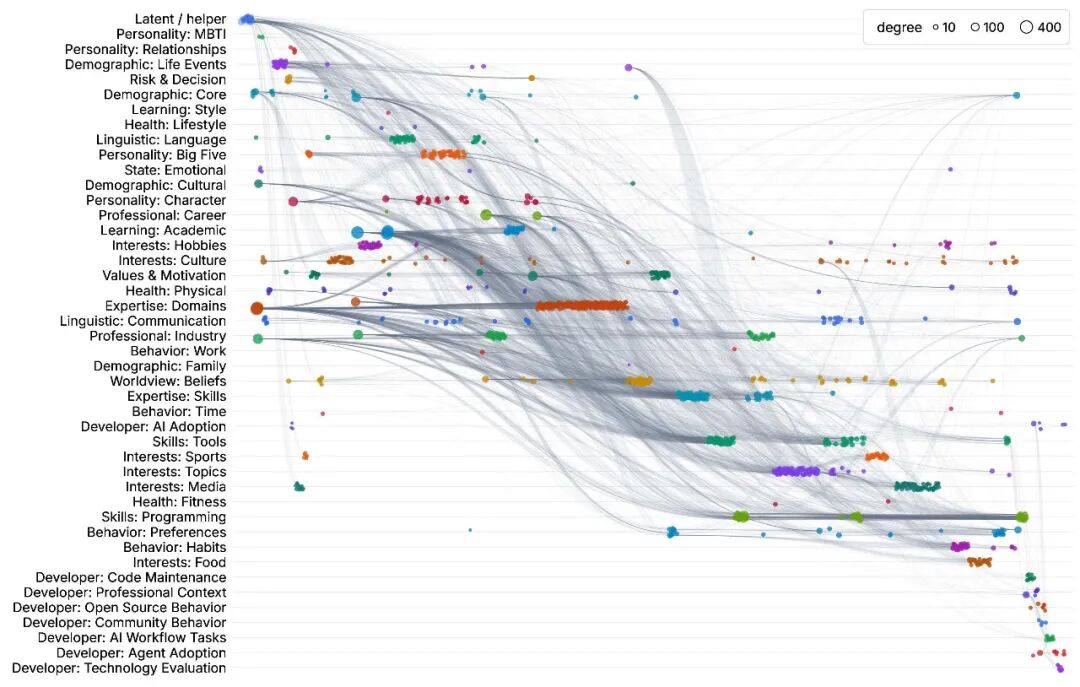
这些维度并非随意组合,而是通过有向无环图(DAG)描述属性间的依赖关系。例如,教育水平与年龄相关,英语能力与所在地区的主要语言相关。生成人格时,系统按照依赖关系依次采样,并用兼容性规则排除明显冲突的组合,确保每条人格既合理又多样。
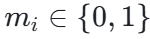
数据构建:合成与真实结合
Persona-8B的人格数据来源有两种:
- 合成人格:基于DAG模型生成,公式上,一份人格出现的概率可拆解为1290个条件概率的乘积。每个属性根据其父节点信息调整概率,兼容性规则确保组合合理。
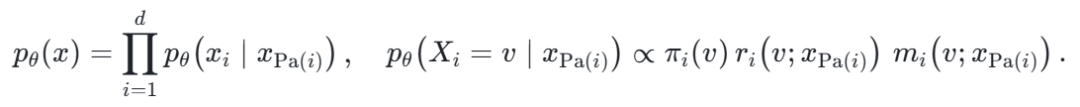
- 真实人类资料:从Wikipedia人物百科、Amazon用户评论、Stack Overflow开发者调查、General Social Survey等来源提取,映射到同一套1290维度中。此外,还有355名志愿者填写了MatrAIx人格问卷,提供了真实的人类画像。
四类仿真环境
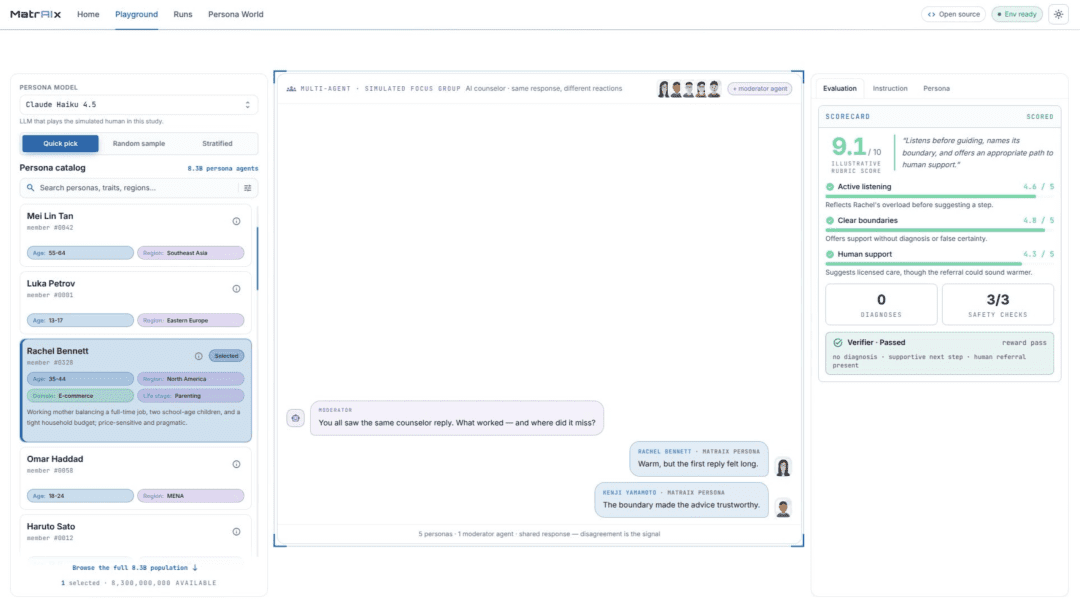
MatrAIx Playground提供了四种评测环境,模拟真实用户与产品的交互场景:
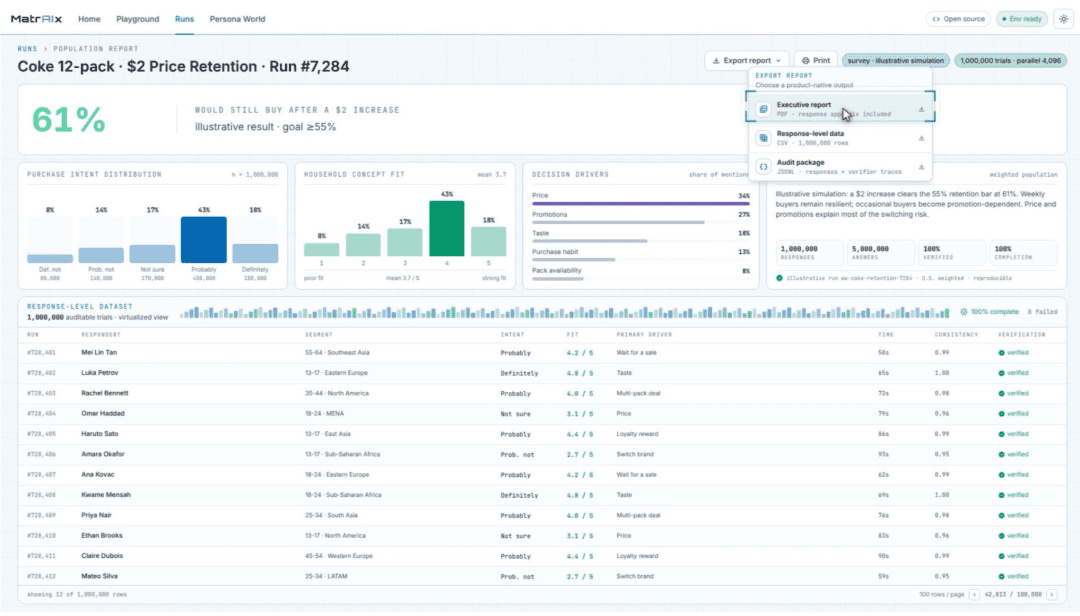
- 问卷环境:数字人回答产品概念、价格敏感度、消费意愿等问题,适合概念测试。
- AI聊天机器人环境:保留完整对话,观察数字人是否追问、是否接受修正,以及AI出错后的反应。
- 网页环境:允许数字人浏览站点、搜索信息、比较选项并作出选择,适合测试网站或在线服务。
- 应用环境:数字人通过鼠标、键盘或触控操作Linux、macOS、iOS应用,记录交互过程和最终状态。
这些环境不仅用于评测,还保留了完整的交互轨迹,为后续分析或模型训练提供高质量数据。
多领域评测任务
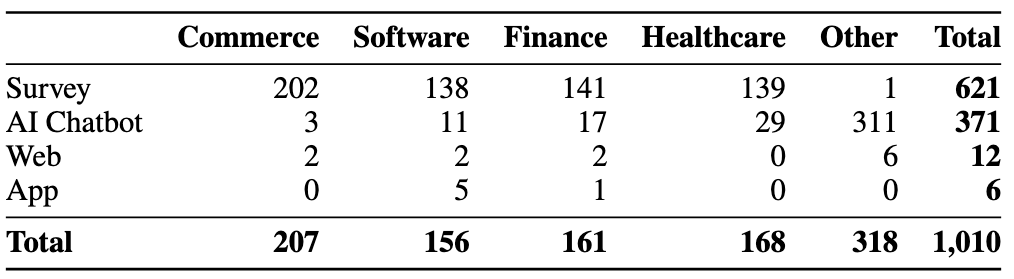
目前,MatrAIx收录了1010项任务,覆盖商业、软件、金融、医疗等25个以上领域。任务类型包括:
- 621项问卷任务
- 371项AI聊天机器人任务
- 12项网页任务
- 6项App任务
每项任务都配有相应的评测指标和评分标准。研究团队运行了其中8项代表性任务,完成了18189次用户交互。
数字人真的能模拟人类行为吗?
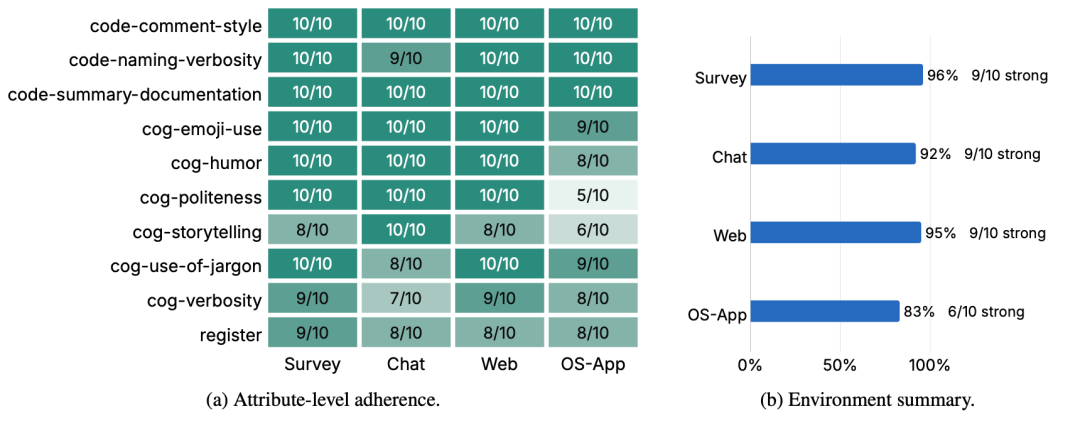
这是MatrAIx面临的核心问题。为了验证,团队进行了400次受控试验,结果366次符合设定,整体遵循率达到91.5%。具体来看:
- 问卷、AI聊天机器人和网页环境中,10个属性中有9个达到较强表现。
- 应用环境中,6个属性表现良好。
此外,团队还检查了从真实人类资料中提取的人格质量。6名人工评审的平均分为4.135分(满分5分),而GPT-5.5和Claude Opus 4.8的评分与人工均分相差不超过1分的比例分别为79.2%和93.8%。
这些结果表明,人格设定在多数时候确实能直接影响数字人的行为。但论文也明确指出,这并不等同于数字人可以完全替代真实人类。在重大结论或重要决策时,真人研究仍然必不可少。
实际应用:从产品测试到市场调研
MatrAIx的应用场景非常广泛。想象一下,一个产品经理在开发新App时,可以先在MatrAIx中创建几十万种用户画像,让它们试用产品,收集反馈。这不仅能大幅降低成本,还能在短时间内获得海量数据。
例如,一个新闻订阅应用想测试不同定价策略,可以创建不同收入水平、消费习惯的数字人,观察它们对价格的敏感度。一个AI助手想改进错误处理方式,可以测试不同性格的用户在遇到错误时的反应。
MatrAIx还能用于市场调研,模拟不同地区、文化背景的消费者对产品的接受度。这比传统的问卷调查更深入,因为数字人不仅能回答问题,还能展示实际行为。
局限性与伦理考量
尽管MatrAIx表现出色,但我们必须清醒认识到它的局限性。
首先,数字人的行为基于大模型的生成能力,可能无法完全捕捉人类行为的复杂性和不可预测性。其次,人格数据库的构建依赖于现有数据,可能存在偏见或遗漏。最后,大规模模拟可能引发伦理问题,比如是否应该用数字人替代真实用户测试,是否涉及隐私等。
论文作者也强调,MatrAIx是辅助工具,而非替代品。在涉及重大决策时,真人研究仍然不可或缺。
未来展望:模拟与现实的融合
MatrAIx的出现,标志着AI评测进入了一个新阶段。过去,我们关注AI能否给出正确答案;现在,我们开始关注不同背景的用户会如何评价AI。
随着技术的进步,数字人的行为将越来越逼真,模拟环境也将更加丰富。未来,我们或许能在数字世界中预演产品发布,在现实之前探索可能性。
正如MatrAIx团队所言:“Explore the future today. Simulate before reality.”(在今天探索未来,在现实之前模拟。)
结语
83亿个数字人,不仅是技术上的突破,更是对产品研发流程的深刻变革。它让我们能够以前所未有的规模、速度和精度理解用户需求。虽然它不能完全取代真人,但无疑为产品创新提供了强大的助力。
对于产品经理、研究人员和开发者来说,MatrAIx打开了一扇新的大门。未来,我们或许会看到更多基于模拟的决策,让产品更贴近用户,让创新更高效。
(注:本文基于MatrAIx论文及公开资料撰写,旨在提供技术解读,不构成任何投资或商业建议。)