AI Agent算力亲和:KV Cache从被动管理到主动协同的突破
从被动缓存到主动协同:AI Agent推理的算力亲和之道
随着AI Agent从简单问答走向复杂任务执行,推理引擎正面临前所未有的挑战。一个Agent任务可能持续数十分钟,期间需要调用工具、读取文件、反思修正,甚至多个Agent分工协作。这种长周期、多会话的推理模式,让KV Cache的管理成为性能瓶颈。传统推理引擎只看到请求和缓存,却无法理解Agent的任务状态,导致缓存资源错配:该释放的没释放,该保留的却被淘汰。
华为openJiuwen平台提出的算力亲和方案,正是为了解决这一断层。它通过Agent Hint在Agent与推理引擎之间建立语义通道,让任务状态转化为算力可执行的调度信号。本文将深入解析这一机制,探讨它如何让KV Cache从被动管理走向主动协同。
推理引擎的困境:看得见缓存,看不懂任务
模型推理时,KV Cache存储了已计算的中间结果,避免重复计算。但上下文越长、并发会话越多,KV Cache占用的显存就越大。显存是GPU、NPU上最昂贵的资源,而当前推理引擎主要依赖LRU等通用策略管理缓存,无法区分Agent执行中的复杂状态。
Agent任务中,推理、工具调用、等待、恢复反复切换,上下文会增长、压缩甚至回退。多个子Agent各有独立上下文,又共享公共前缀。会话“暂时不用”和“彻底结束”需要不同处理。如果引擎无法区分这些状态,只能被动依赖超时或淘汰策略,导致无效占用和重复计算并存,显存容量、首token时延和系统吞吐同时承压。
因此,Agent推理优化不能只停留在引擎内部,也不能只在应用侧压缩上下文。真正的突破口是打通Agent任务状态与底层资源调度。
openJiuwen算力亲和:Agent与推理引擎的语义协同
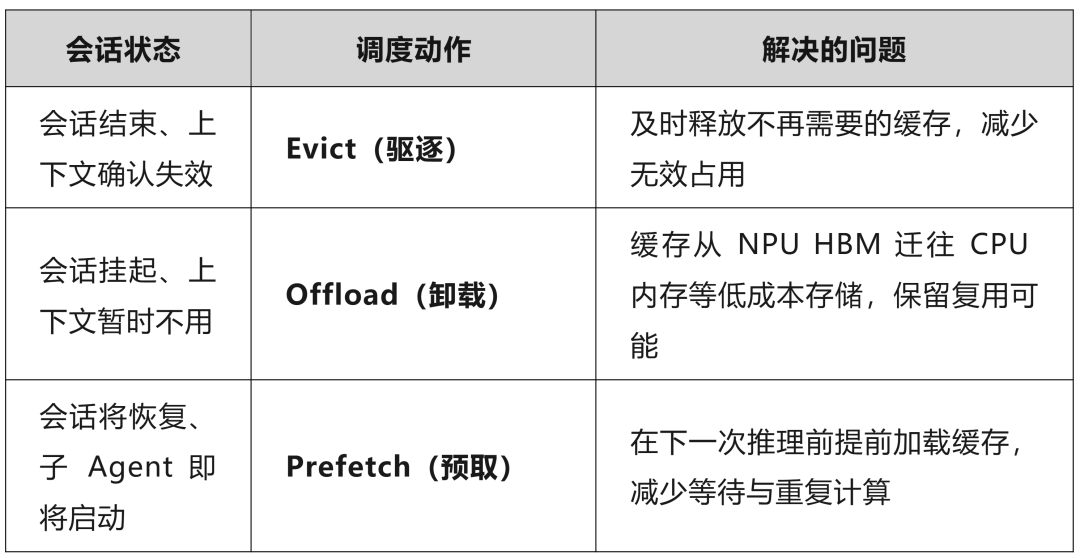
openJiuwen的解法是让Agent在状态变化时实时同步给推理引擎,这就是Agent Hint——Agent与推理引擎的“状态契约”。它不是额外的API调用,也不是新系统,而是给推理引擎下发的一段语义,告诉引擎:我是哪个会话、隶属于哪个父任务、我的缓存接下来会怎样。
Agent在关键状态变化时发出Hint,引擎据此执行对应的缓存动作。这套协同围绕三个动作展开:驱逐、卸载、预取,共同构成KV Cache的生命周期闭环。缓存不再只有“留在显存”或“排队等淘汰”两种命运,而是随任务节奏在存储层级间主动流动。
落到接口上,一条带Hint的请求大致长这样:
{
"agent_hint": {
"session_id": "...",
"parent_task_id": "...",
"action": "prefetch"
}
}
一次蜂群任务里,缓存如何跟着任务走一圈
机制讲完,看它在一次典型的多Agent任务里如何运转。
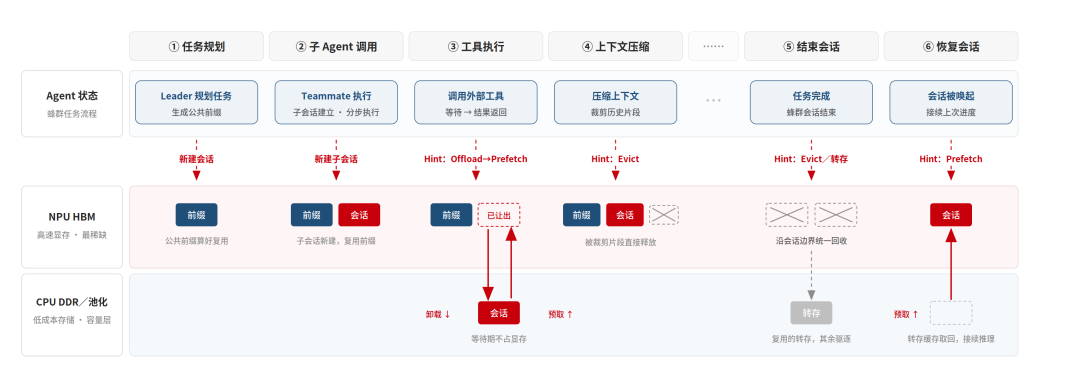
任务规划
Leader接到任务、完成拆解。系统提示词、工具定义这些所有成员都要用的公共前缀被算好并缓存,供后续子Agent复用。
子Agent调用
多智能体协同过程中,各子Agent可能会存在分步执行,每次再被调起前,JiuwenSwarm提前发出Prefetch信号,把上一轮的缓存取回显存。
工具执行
某个子Agent调用外部工具、进入等待,它的KV Cache从HBM卸载,为活跃任务腾出显存;工具结果一返回,框架抢在下一次推理请求之前发起预取,恢复推理时缓存已经回到显存。
上下文压缩
长任务中,每个Agent都可能压缩、裁剪自己的上下文。被移出上下文的部分同步发出卸载信号,对应缓存随之下移到低成本存储。
结束会话
任务完成,仍需复用的缓存转入低成本存储,确认不再需要的直接驱逐;整个蜂群任务结束时,所有关联资源沿会话边界统一回收。
恢复会话
已结束的会话也可能被重新唤起。框架在恢复前发出预取信号,转存的缓存被提前取回显存,任务接着上次的进度继续。
回头看,调度的依据已经变了:不再是“哪块缓存最久没被访问”,而是“哪个任务正在跑、哪个只是暂停、哪段上下文马上要用”。这使KV Cache管理从通用的访问热度判断,升级为面向Agent执行工作流的语义级调度。
三层协同:从蜂群智能体到昇腾算力
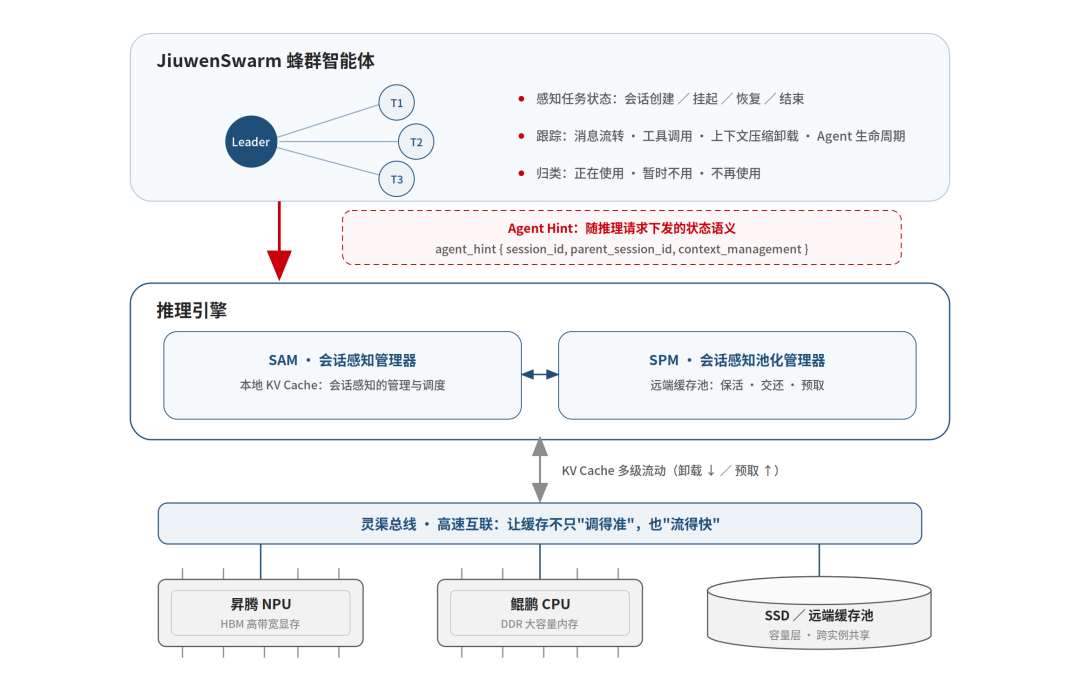
算力亲和并非孤立功能,而是openJiuwen联合昇腾专家团队打造的从Agent延伸到本地显存和池化存储的协同架构。以JiuwenSwarm蜂群智能体为例:
JiuwenSwarm感知上下文与生命周期
它本来就掌握消息流转、工具调用、上下文压缩、子Agent创建与销毁的全部状态。对Agent来说这是任务流程,对推理系统来说,这些就是现成的调度信号。框架把资源状态归成三类:正在使用的保护好,暂时不用的挪下去,不再使用的放掉。
SAM精细管理本地KV Cache
推理引擎内新增的SAM(Session-Aware Manager,会话感知管理器),把无状态的前缀缓存升级为会话感知的管理与调度:它维护会话与缓存的归属关系,为活跃的长会话保住思考过程、工具中间结果这些独有前缀,为已结束的会话沿清晰边界快速回收——本地显存的每一次分配与淘汰,都带上了会话语义。
SPM协同管理池化缓存
到了多实例部署,业界已经开始把KV Cache汇入Mooncake这类分布式缓存池,但远端存储并不认识“会话”。SPM(Session-Aware Pooling Manager,会话感知池化管理器)把会话语义继续传到池化层:活跃会话持续保活,会话结束即交还,将恢复时提前预取。
昇腾算力承载多级流动
在昇腾平台上,这套机制复用了推理引擎既有的缓存加载与池化接口,降低了系统改造成本;缓存的跨层级迁移,借助昇腾灵渠总线的高速互联,在NPU HBM、鲲鹏CPU的DDR内存、SSD与远端缓存池之间快速流动——Hint负责“调得准”,灵渠总线负责“流得快”。
一句话总结:JiuwenSwarm识别任务状态,Agent Hint负责传递语义,SAM与SPM负责精准调度,灵渠总线为跨层级、跨设备的数据流动提供高速通道。任务启动,缓存提前准备;任务暂停,缓存有序让位;任务恢复,缓存及时回归;任务结束,资源随即释放。
这么做,能换来什么?
算力亲和带来的价值,最终体现在整个Agent系统的运行效率上。
更高的缓存利用效率
已结束或闲置的会话不再长期占用NPU HBM,省出的高速存储可以服务更多活跃上下文。
更稳定的多轮推理
活跃会话的独有前缀得到针对性保护,减少因误淘汰导致的缓存失效和重复计算与prefill。
更快的会话恢复
预取把缓存加载前移到任务状态切换阶段,降低恢复后的首轮等待。
更强的多Agent承载能力
Leader与多个Teammate并行工作时,缓存随任务活跃度动态进出高速存储,同等硬件承载更复杂的协作流程。
更可控的工程成本
方案通过标准接口和事件机制衔接Agent与推理系统,兼容既有缓存管理链路。
openJiuwen基于SWE-bench Verified数据集做了一组对比测试:覆盖Bug修复、功能开发、代码重构等典型场景,模拟10个用户并发使用JiuwenSwarm执行任务,对比开启与不开启算力亲和的效果。结果显示:开启算力亲和后,首token时延(TTFT)降低57.46%,模型请求端到端(E2E)时延降低27.61%,Prefix Cache命中率提升33%,池化缓存使用量峰值降低25.24%。
让算力从“响应请求”走向“理解任务”
面向Agent的缓存策略,必须理解一个任务是正在执行、暂时等待,还是已经结束。只有让应用层的语义真正进入资源调度,长上下文、多会话、多Agent并发带来的存储压力,才能从被动应对变成主动管理。
openJiuwen算力亲和给出的协同范式,落在工程上是两个方向:向上,以开放的Agent Hint接口规范承接任务语义;向下,把从本地显存到分布式缓存池的整条缓存调度链路升级为会话感知。
归结成一句话:Agent读懂任务,算力读懂Agent。同样的硬件、同样的任务,首token时延降低57%以上,推理存储峰值直接省出约25%!
当前这套能力即将开源,感兴趣的开发者可以关注openJiuwen开源社区尝鲜与体验:
- GitHub: https://github.com/openJiuwen-ai
- AtomGit: https://atomgit.com/openJiuwen