连续自回归TTS新突破:dots.tts开源基座模型深度解析
语音合成的新范式:连续自回归的崛起
语音合成领域正经历一场深刻的范式转移,类似于大语言模型早期的探索阶段。当前主流技术路线分为两派:一派采用非自回归的扩散模型,能够并行生成整段语音,但受限于离线应用场景;另一派则沿用大语言模型的离散Token预测方式,将语音压缩为离散符号后逐个生成,然而语音的连续性使得这种量化方法存在难以突破的信息瓶颈。
在此背景下,小红书dots团队与上海交通大学X-LANCE实验室联合开源的dots.tts,选择了一条截然不同的路径:在连续隐空间中执行自回归生成。这一决策不仅避开了离散Token的信息损失,还保留了自回归模型在长程依赖和上下文建模上的天然优势。
技术架构:全连续自回归的完整链路
dots.tts是一个拥有20亿参数的端到端TTS基础模型,其核心创新在于完全摒弃离散声学Token,直接在连续隐空间中逐块预测声学特征。整个生成链路包括三个关键组件:
- AudioVAE:负责将48kHz波形压缩为25FPS的连续潜变量序列,通过语义化训练(包括重建损失、WavLM对齐、ASR/情绪/说话人多任务监督)塑造出信息完整且结构清晰的隐空间。
- 因果Semantic Encoder:在自回归过程中,实时提取已生成语音的语义摘要,作为稳定的历史条件回灌给模型,有效缓解连续误差的累积。
- 自回归LLM:基于文本BPE编码和语义历史,在连续隐空间中逐步预测下一个声学块,实现流式生成。
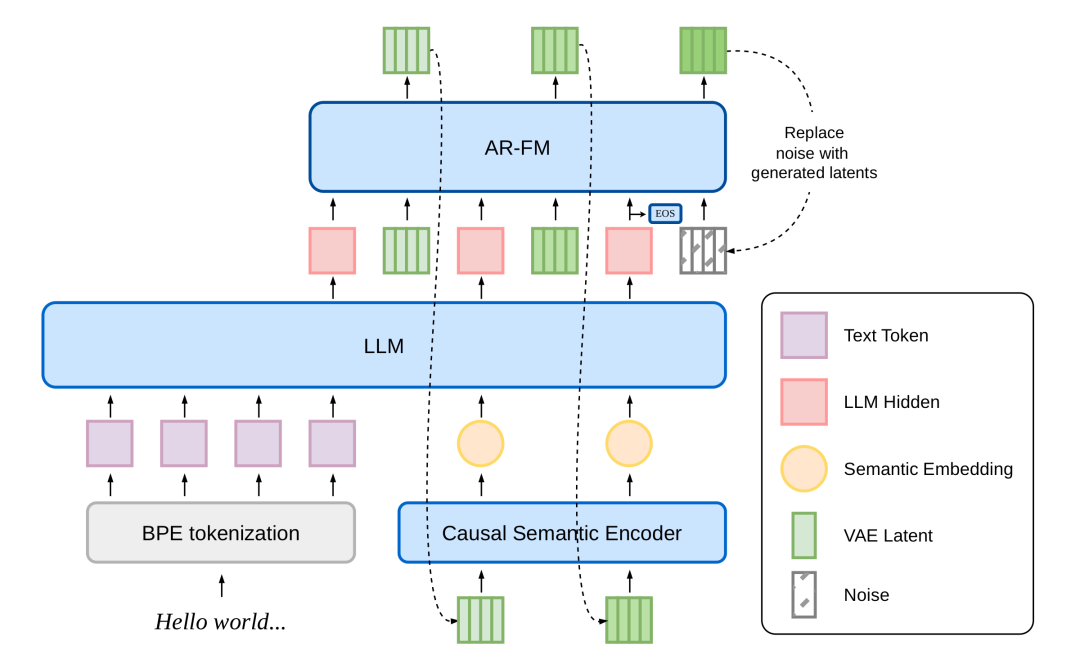
这种设计使得模型既能享受自回归的灵活性和上下文学习能力,又能保留连续表示对音色、韵律等细节的高保真度。
性能表现:多项评测刷新SOTA
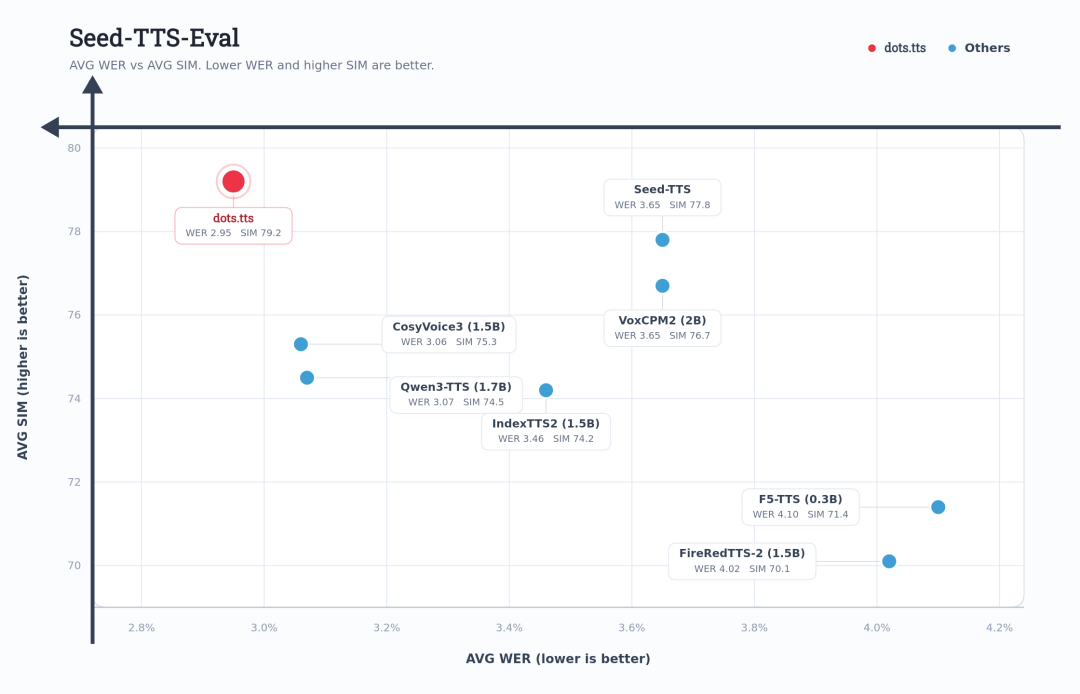
在Seed-TTS-Eval零样本克隆评测中,dots.tts SOAR版本在中文、英文和困难集上分别取得0.94%、1.30%和6.60%的WER/CER,以及81.0、77.1和79.5的SIM分数,平均SIM达到79.2,平均WER/CER仅为2.95%,均优于现有开源和闭源系统。
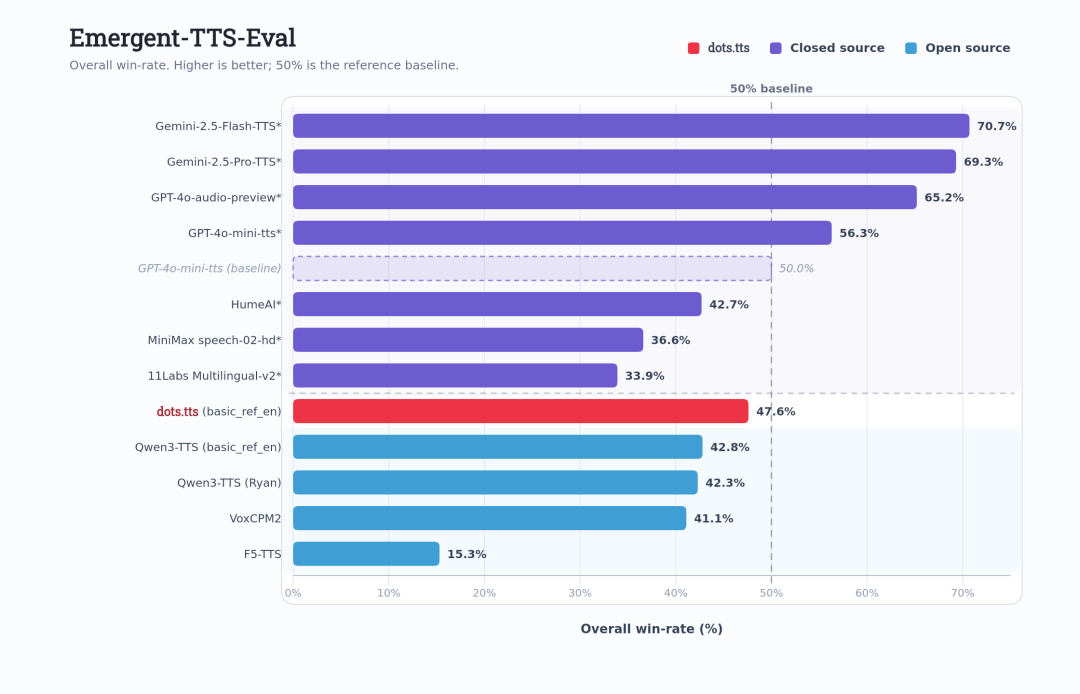
在MiniMax-Speech的24语种测试中,dots.tts自纠正对齐版本的平均说话人相似度达到83.9,并在19个语种中取得单项第一。在EmergentTTS-Eval表现力评测中,dots.tts SOAR版本的句法复杂度得分65.7%,超过所有闭源系统;Base版本的情绪表现力得分72.7%,为开源系统最佳。
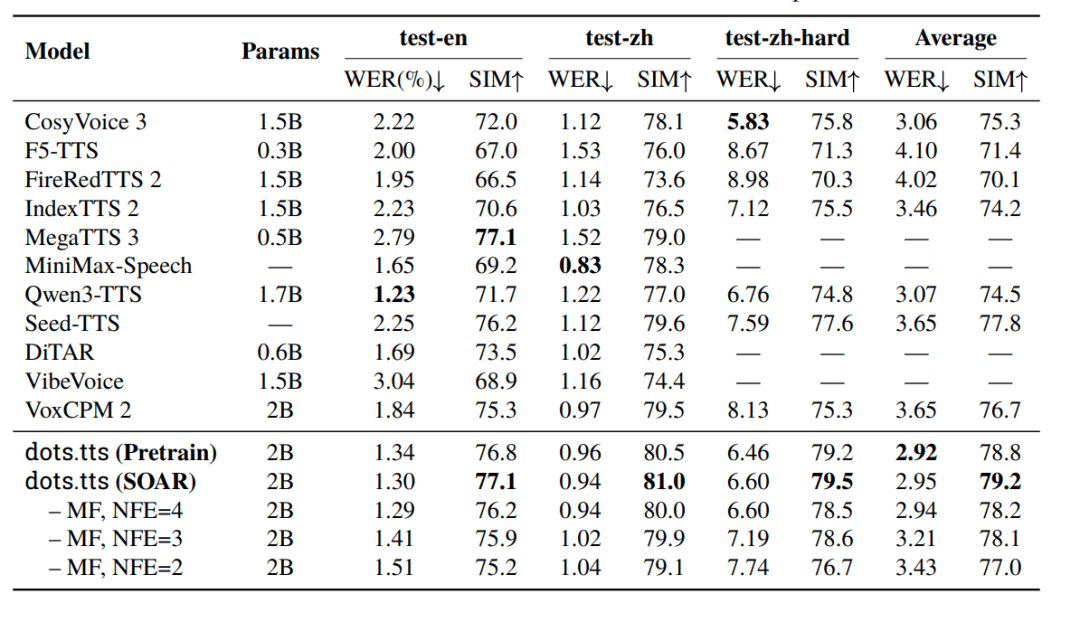
这些结果验证了连续自回归路线的可行性,也展示了其在音色克隆和内容准确性上的强大潜力。
连续表示的优势:细节保留与信息上限
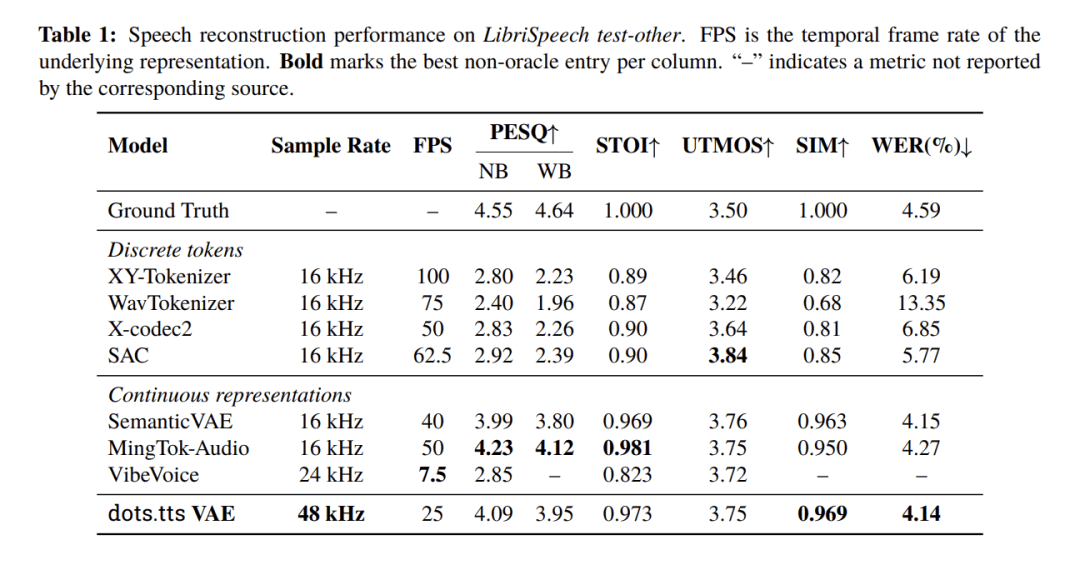
语音本质上是连续的,说话人的身份特征分布在频谱质感、气声、音高微变、停顿节奏等大量细节中。离散Token通过量化将连续变化映射到有限词表,不可避免地造成信息丢失。重建评测显示,离散表征的PESQ-NB仅为2.40-2.92,SIM为0.68-0.85;而连续表征的PESQ-NB达到4.09-4.23,SIM高达0.95-0.97。
dots.tts的AudioVAE在48kHz下将序列压缩至25FPS,仍能取得4.09的PESQ和0.969的SIM,在信息保留和序列长度之间取得了平衡。这种高保真表示使得模型能够捕捉并复现参考音频中的细微声学特征,如回声、空间感等,从而在克隆时表现出色。
解决连续自回归的误差累积难题
连续自回归面临的核心挑战是误差累积:由于缺乏离散码本的约束,前一步的微小偏差会逐步放大,导致音色漂移或文本错位。dots.tts通过两项关键设计解决此问题:
- 语义化AudioVAE:通过多任务监督(ASR、情绪、说话人)为隐空间注入结构化信息,使模型更容易学习稳定的预测模式。
- 因果Semantic Encoder:在生成过程中,将已生成的连续潜变量压缩为语义摘要,作为长程条件,减少局部噪声对后续步骤的影响。
实验表明,这种设计显著提升了长句生成的稳定性,使得模型能够保持一致的音色和韵律。
后训练与推理优化:从多步到单步
dots.tts不仅关注基础模型性能,还针对推理效率进行了系统优化。团队采用无奖励的自纠正对齐(SOAR)修复预训练与多步推理之间的误差,然后通过MeanFlow蒸馏将生成步数从数十步压缩至四步,再结合简化一致性模型(sCM)和奖励感知的分布匹配蒸馏(Reward-Aware DMD)实现双步和单步生成。
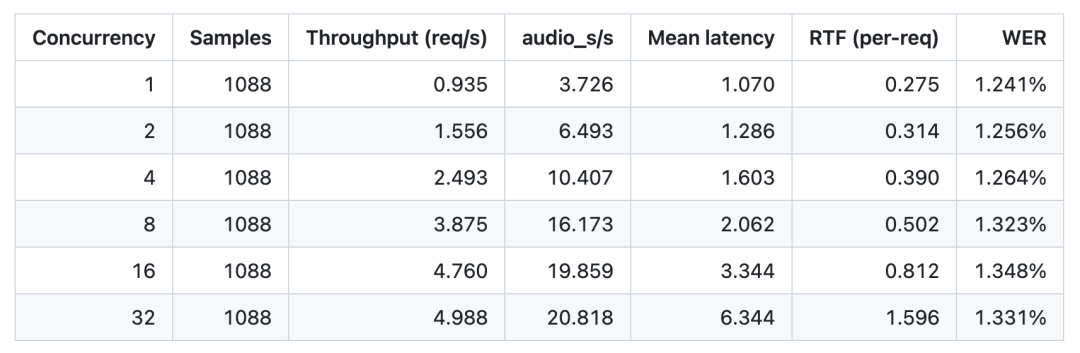
在1T1A双流模式下,模型支持与上游LLM协同工作,首包延迟低至54.4毫秒,适合实时交互场景。SGLang-Omni引擎已支持dots.tts推理,单卡最高可并行16路,为大规模部署提供了便利。
开源基座:可扩展的语音基础设施
dots.tts的开源程度在TTS领域堪称典范,共开放六个检查点,覆盖基础训练、自纠正对齐、MeanFlow四步/两步/单步以及1T1A双流模式。同时提供完整的训练、推理、微调和蒸馏代码,采用Apache 2.0许可。
这种开放性使得研究者可以复现和验证连续自回归路线,开发者可以进行领域适配和低延迟优化,产品团队能够将其集成到语音Agent、创作工具等应用中。
扩展能力:dots.tts.edit的精确编辑
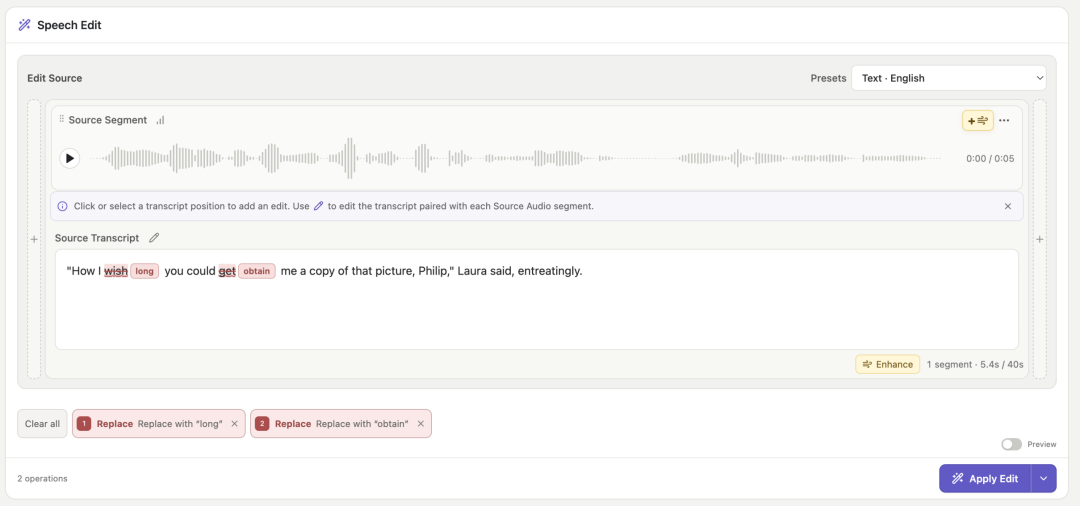
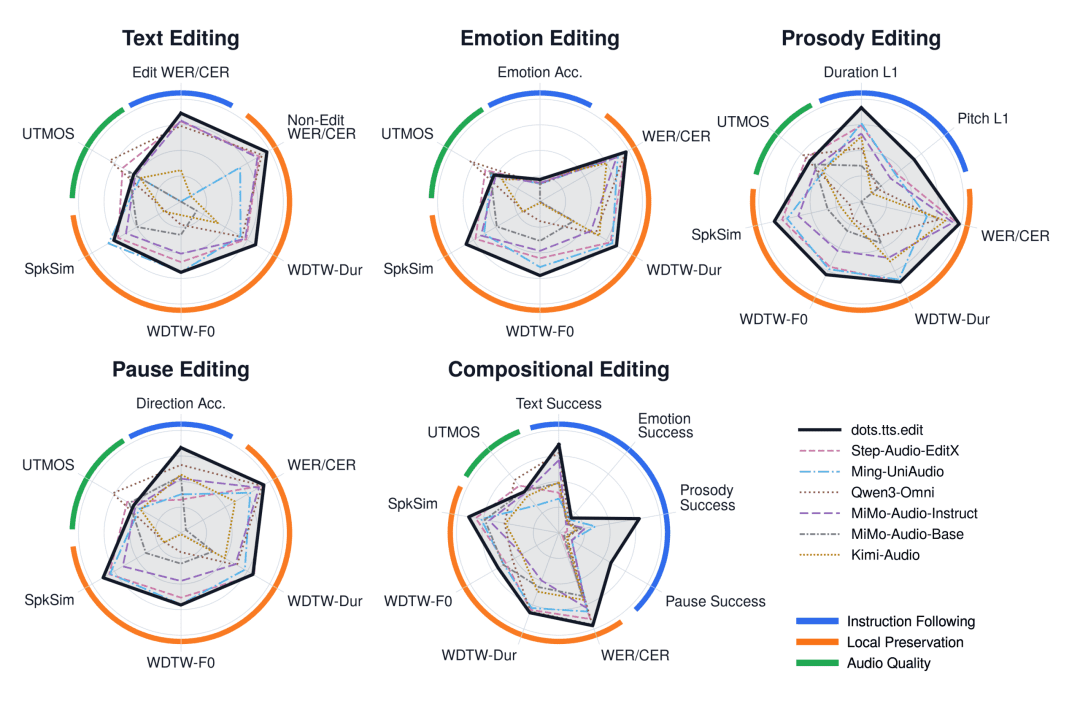
基于dots.tts基座,团队进一步训练了dots.tts.edit,支持文本、情绪、韵律和停顿四类编辑操作,并能组合执行。在doteBench评测套件上,dots.tts.edit在指令遵循和局部保持方面均领先于现有开源模型,同时保持了与基座相当的零样本克隆能力。
这一扩展证明了连续自回归架构的统一建模潜力,为语音编辑、个性化定制等高级应用奠定了基础。
结语:语音合成基座的新形态
dots.tts的开源不仅提供了一个高性能的TTS模型,更展示了一种可扩展的语音合成基础设施。通过连续自回归路线,它实现了高保真音色克隆、流式输出和精确编辑,同时保持了训练和推理的灵活性。
对于语音合成领域而言,dots.tts的意义在于证明了连续表示与自回归生成的结合能够突破传统离散Token的局限,为未来语音大模型的发展提供了新的方向。随着开源社区的参与,这一基座有望在更多场景中落地,推动语音合成技术向更自然、更智能的方向演进。