OlmoEarth嵌入向量:从地球观测数据到下游分析的定制化导出
从像素到向量:OlmoEarth嵌入如何重塑地球观测分析
地球观测数据正在以指数级速度增长,但如何从海量遥感影像中提取有意义的信息,始终是地理空间分析的核心挑战。传统方法依赖人工设计的特征或逐像素分类,不仅耗时,而且难以捕捉复杂的空间模式。OlmoEarth Studio近期推出的嵌入向量导出功能,为这一问题提供了全新的解决思路——通过基础模型将原始影像转化为紧凑的数值表示,让下游分析变得高效且灵活。
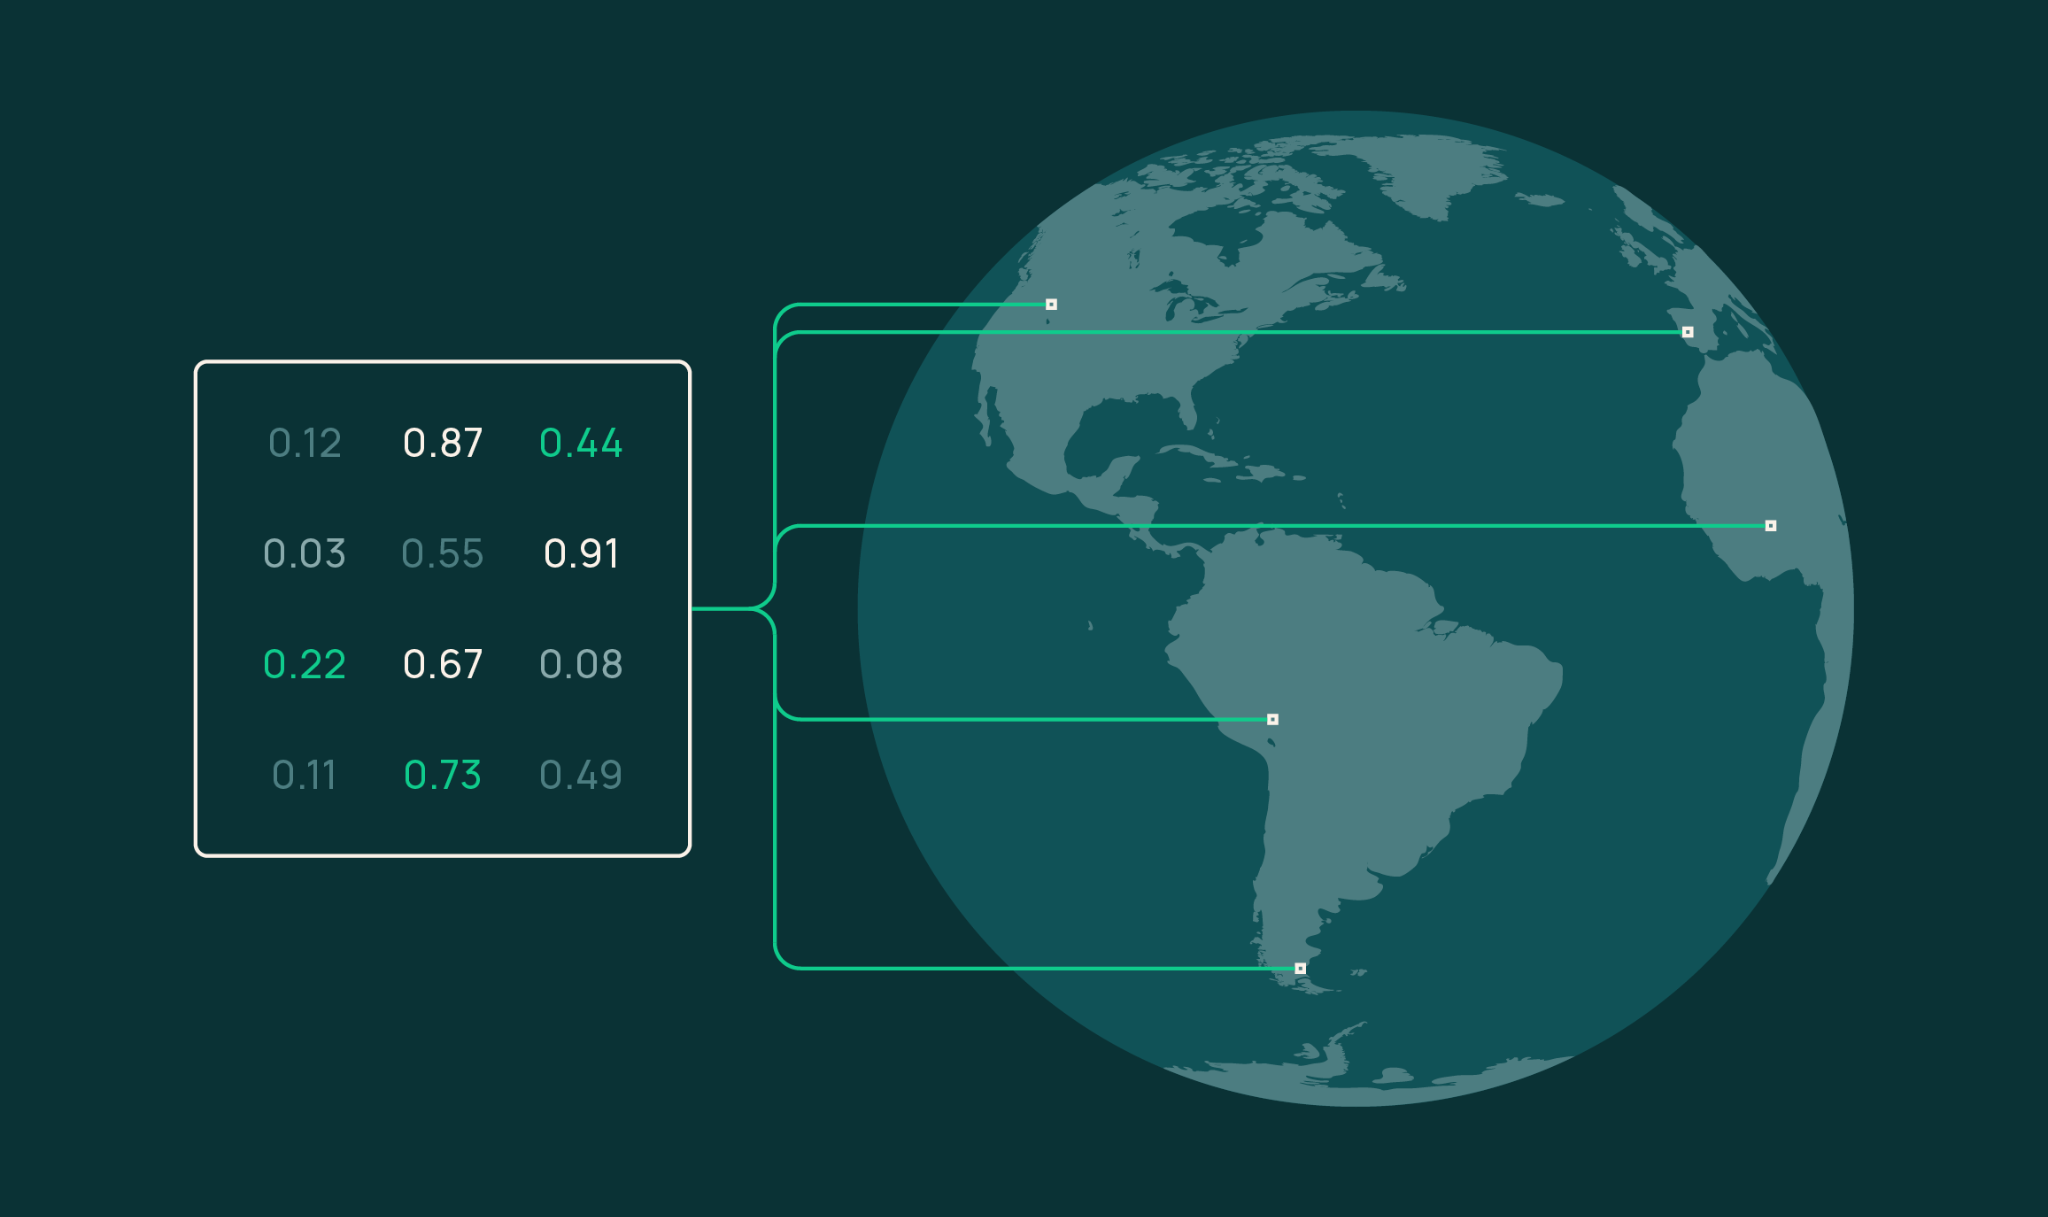
嵌入向量:地球观测的通用语言
嵌入向量的核心思想是:将高维的影像数据映射到一个低维向量空间,使得具有相似地表特征的区域在向量空间中彼此靠近,而差异显著的区域则相距较远。OlmoEarth基础模型在数百万个全球样本上进行了预训练,学习到了丰富的空间和光谱特征。这些嵌入向量不仅保留了原始影像的关键信息,还去除了冗余噪声,使得后续的相似性计算、分类和聚类等操作变得异常简单。
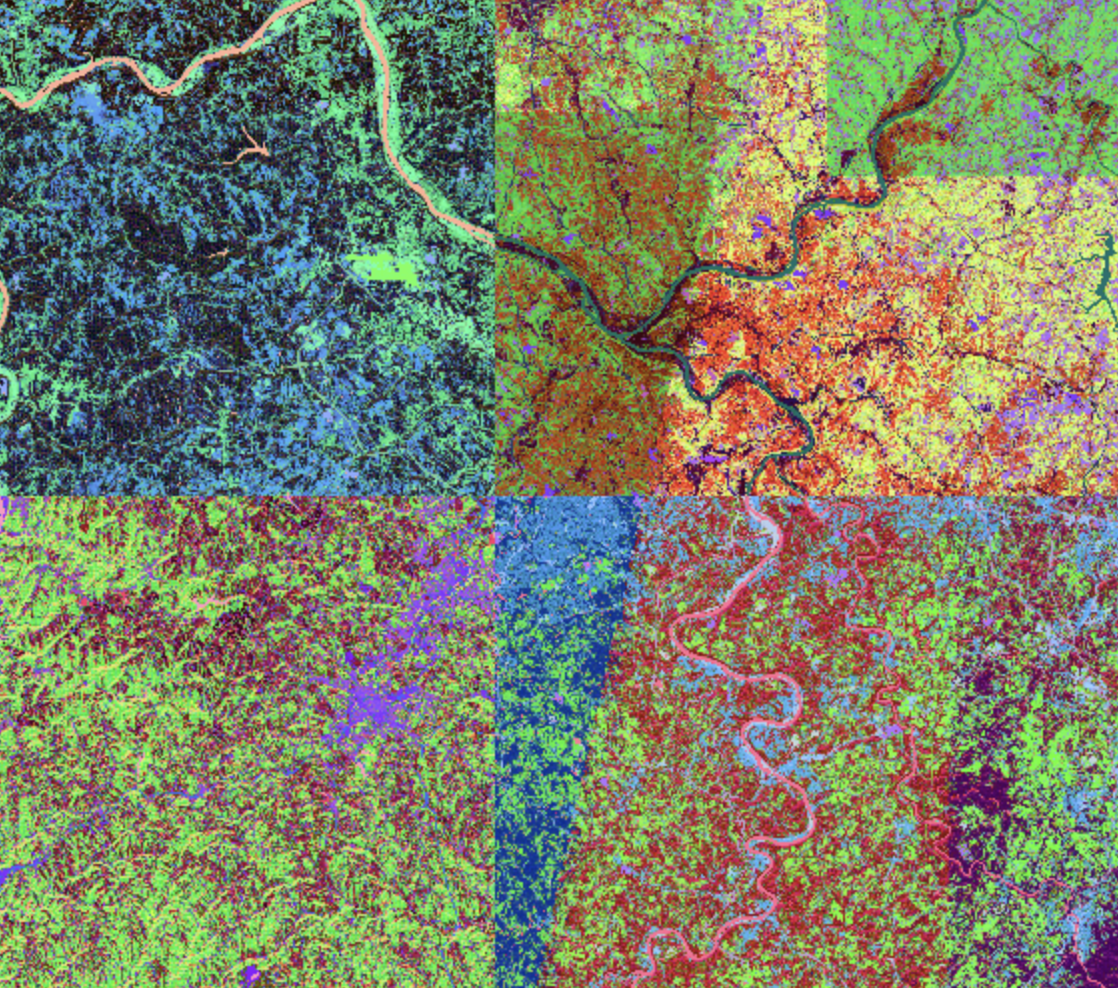
与传统的逐像素分析相比,嵌入向量具有显著优势。首先,它大幅降低了数据维度,例如OlmoEarth-v1-Tiny模型仅需192维即可表示一个像素,而原始的多光谱影像通常包含数十个波段。其次,嵌入向量是通用的,同一组向量可以用于多种任务,无需针对每个任务重新训练模型。最后,嵌入向量的计算是高效的,在Studio中按需生成,避免了大规模预计算存储的负担。
在Studio中计算嵌入:灵活的参数配置
OlmoEarth Studio将嵌入向量的计算流程简化为几个直观的步骤。用户首先需要定义一个感兴趣区域,可以手动绘制多边形或上传GeoJSON文件。Studio会自动处理影像获取和分块,无需用户关心底层的数据管道。接下来,用户需要选择时间范围,从1个月到12个月不等,这为捕捉季节性动态提供了可能。例如,可以分别生成2023年9月和2024年9月的月度嵌入,以对比不同年份同一时期的景观变化。
编码器变体的选择直接影响嵌入向量的维度和性能。Studio提供了三种预训练模型:Nano(128维,140万参数)、Tiny(192维,620万参数)和Base(768维,8900万参数)。Tiny模型在计算效率和性能之间取得了良好平衡,适合大多数应用场景;而Base模型则能捕捉更细微的差异,但需要更多的存储和计算资源。空间分辨率同样可调,支持10米、20米、40米和80米每像素,用户可以根据分析精度需求进行权衡。
影像源的选择也至关重要。Studio支持Sentinel-2 L2A(光学)和Sentinel-1 RTC(雷达)数据,或两者的组合。光学影像提供了丰富的光谱信息,而雷达数据则对地表结构和湿度敏感,两者结合可以更全面地刻画地表特征。所有参数配置完成后,Studio会生成一个Cloud-Optimized GeoTIFF(COG)文件,每个波段对应一个嵌入维度,以int8格式存储,范围从-127到+127,-128表示无数据。用户可以通过提供的反量化函数将其转换为浮点向量。
相似性搜索:发现“更多类似”的区域
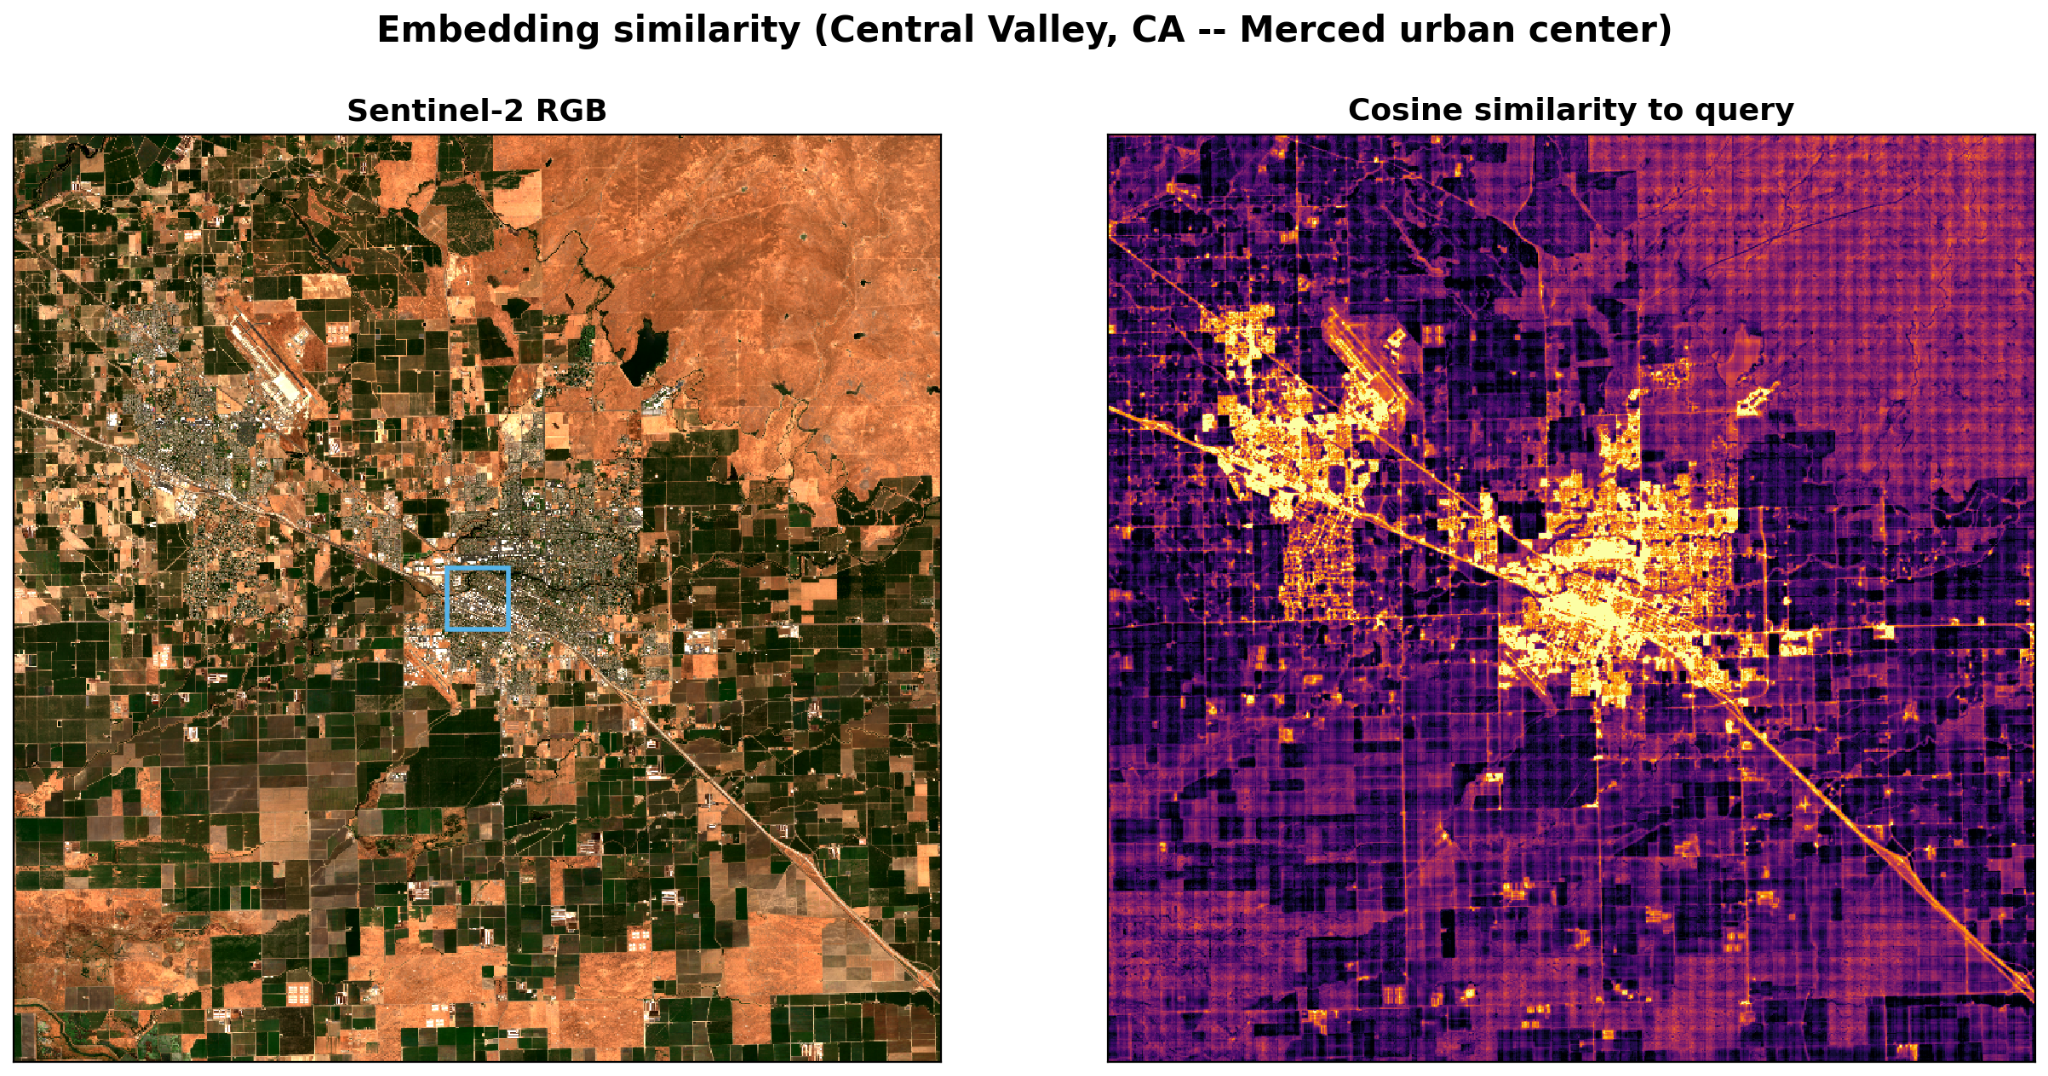
嵌入向量最直观的应用之一是相似性搜索。用户可以选择一个查询像素,提取其嵌入向量,然后计算该向量与区域内所有其他像素的余弦相似度。结果是一个热力图,高亮显示与查询点最相似和最不相似的区域。
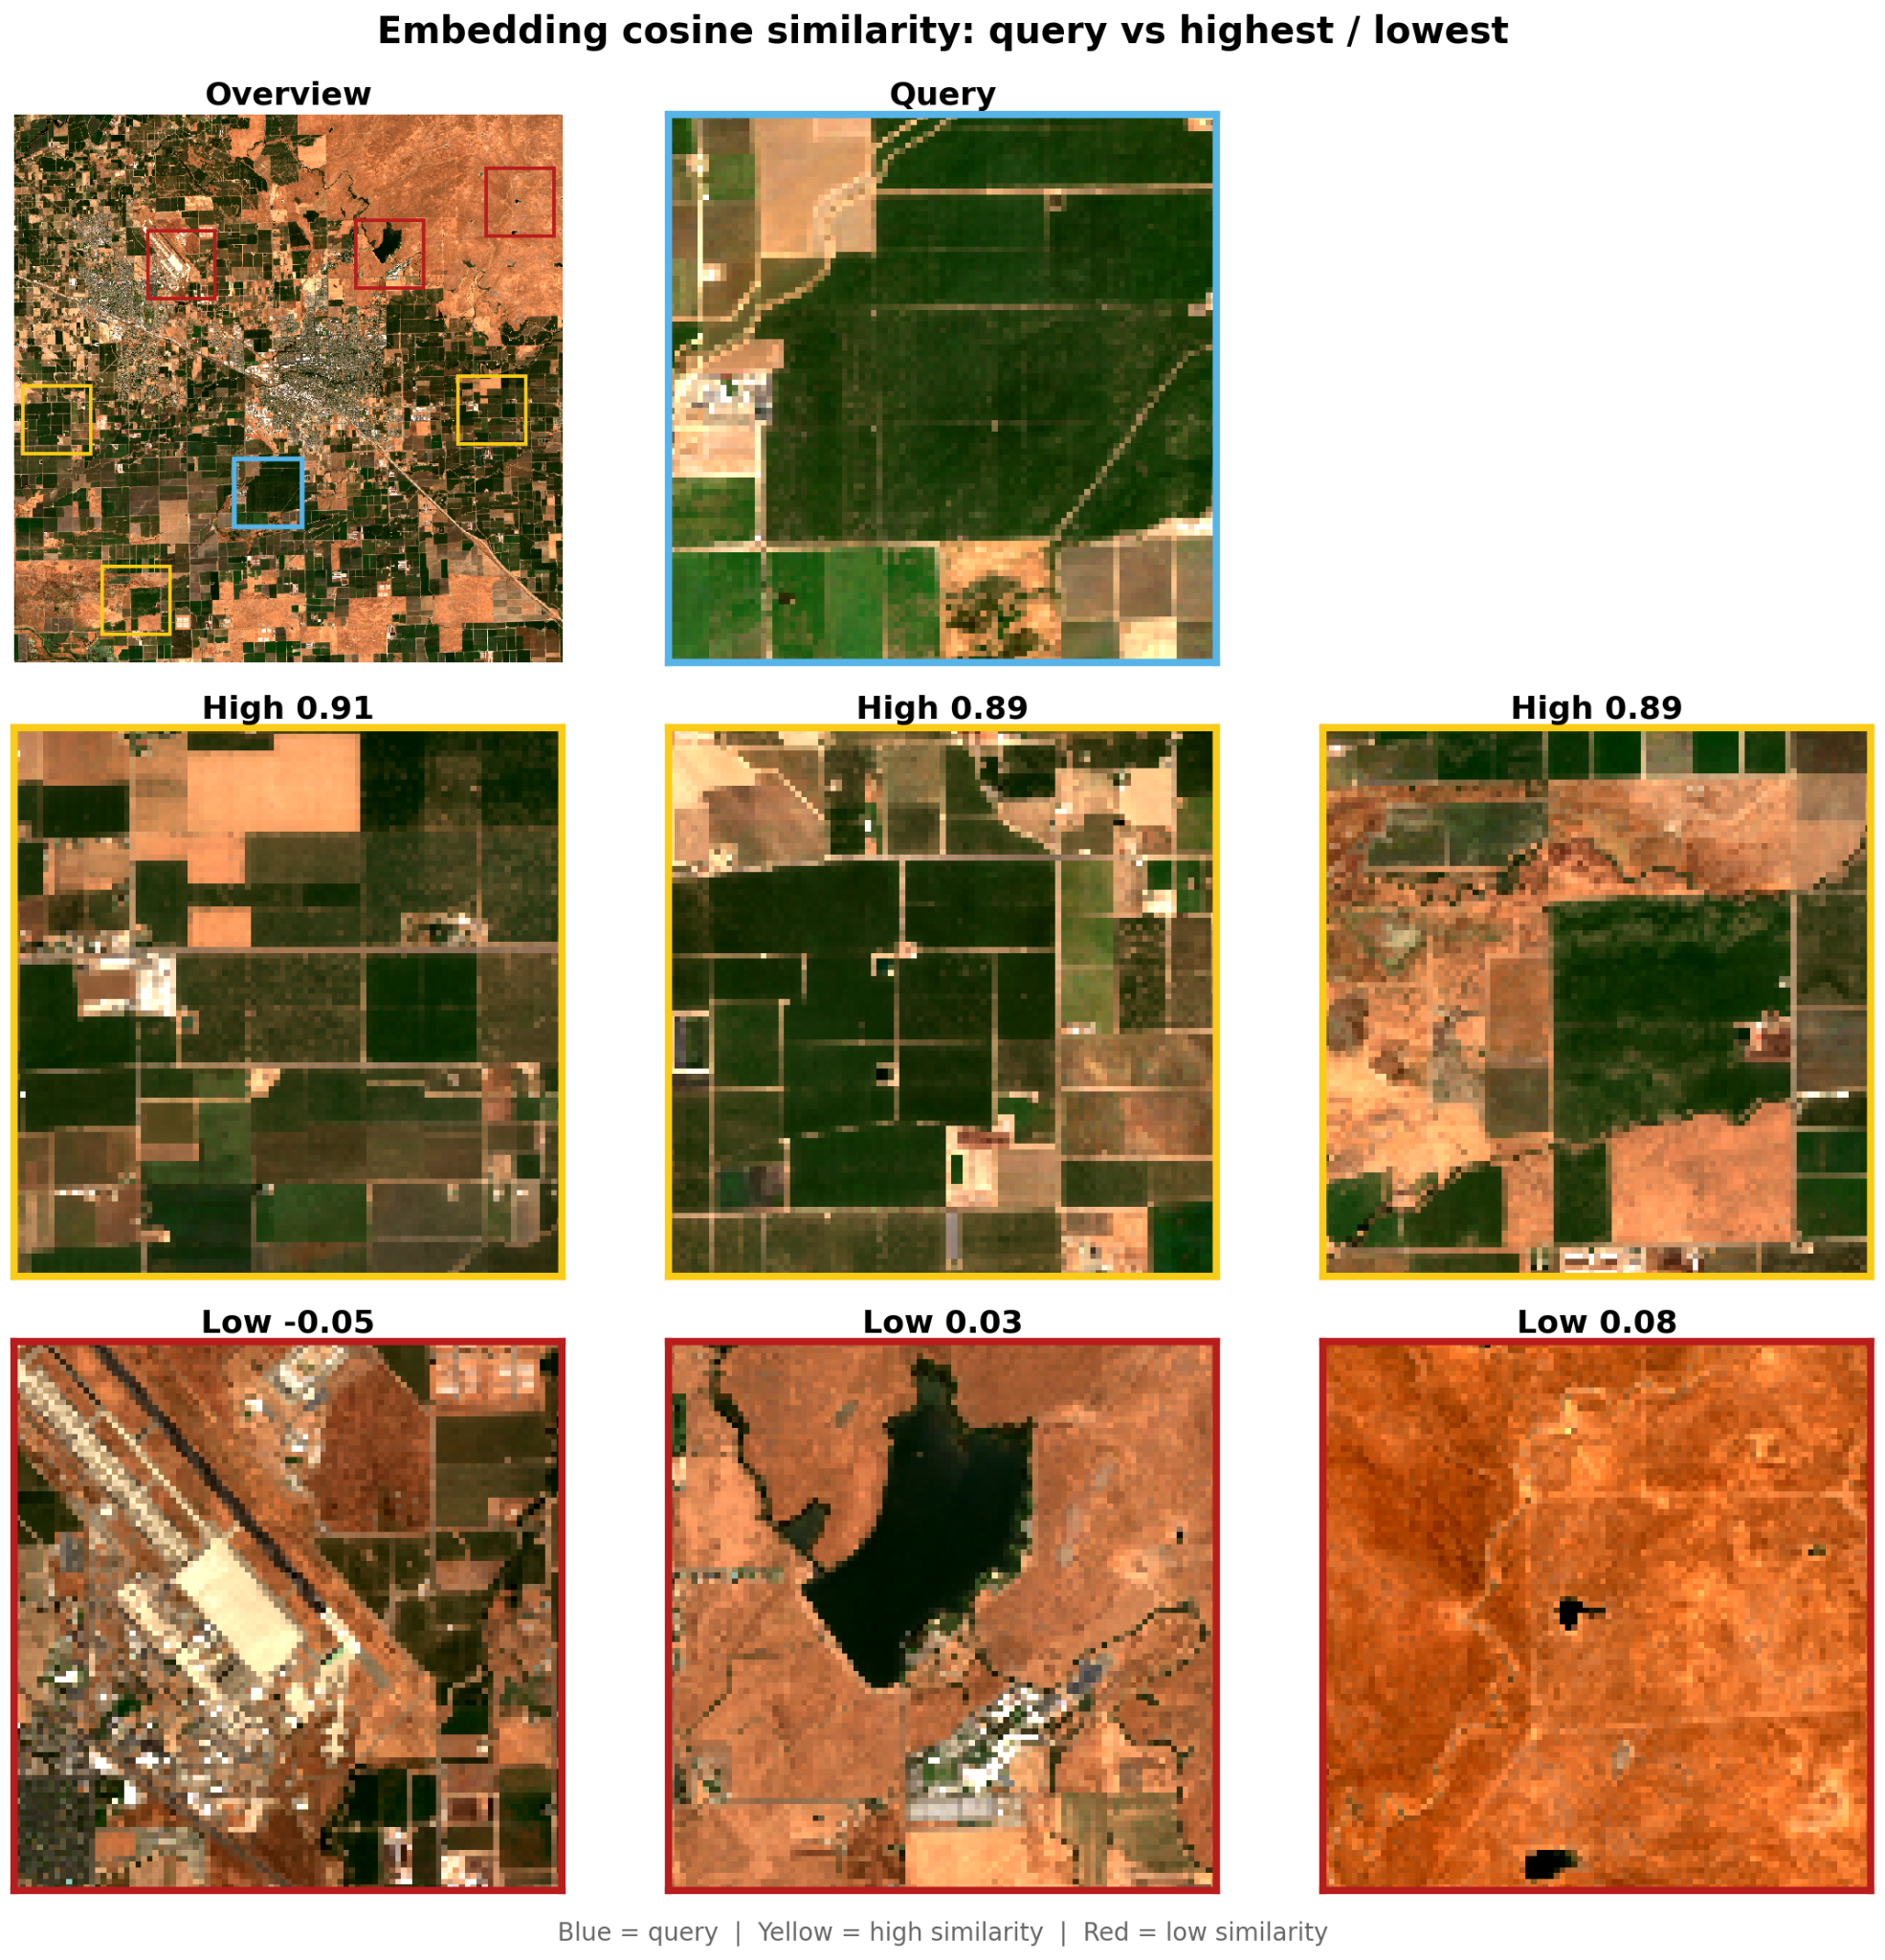
例如,在加利福尼亚州默塞德市附近,选择城市中心的一个像素作为查询点,相似性热力图清晰地勾勒出城市建成区和道路走廊,而农业地块则呈现暗色。这表明模型在没有标签的情况下,成功区分了人工建筑与农田。类似地,如果选择一个小型农业地块,并取其嵌入向量的平均值作为查询向量,最相似的区域(相似度0.89以上)都是灌溉农田,而最不相似的区域(相似度接近0)则包括机场、水库和干旱牧场。这种能力对于土地覆盖分类、生态监测和城市规划等应用极具价值。
少样本分割:用极少量标签绘制土地覆盖图
在许多实际场景中,获取大量标注数据是昂贵且困难的。嵌入向量的另一个强大之处在于,它使得少样本学习成为可能。由于嵌入向量已经包含了丰富的语义信息,一个简单的线性分类器就能从极少的标注像素中学习到有效的决策边界。
我们在越南金瓯省的一个沿海红树林区域进行了实验。该区域包含红树林、水体和陆地三类地表。我们从ESA WorldCover 2021数据中随机选取了每类20个像素,共60个标注像素,训练了一个逻辑回归分类器,并对整个区域进行预测。结果令人印象深刻:加权F1分数达到0.84,红树林、潮汐水道和开阔水域被清晰地划分出来。更值得注意的是,当标注像素从30个增加到300个时,分类精度几乎没有提升,这表明嵌入向量已经承担了大部分特征提取工作,分类器只是简单地利用了这些特征。
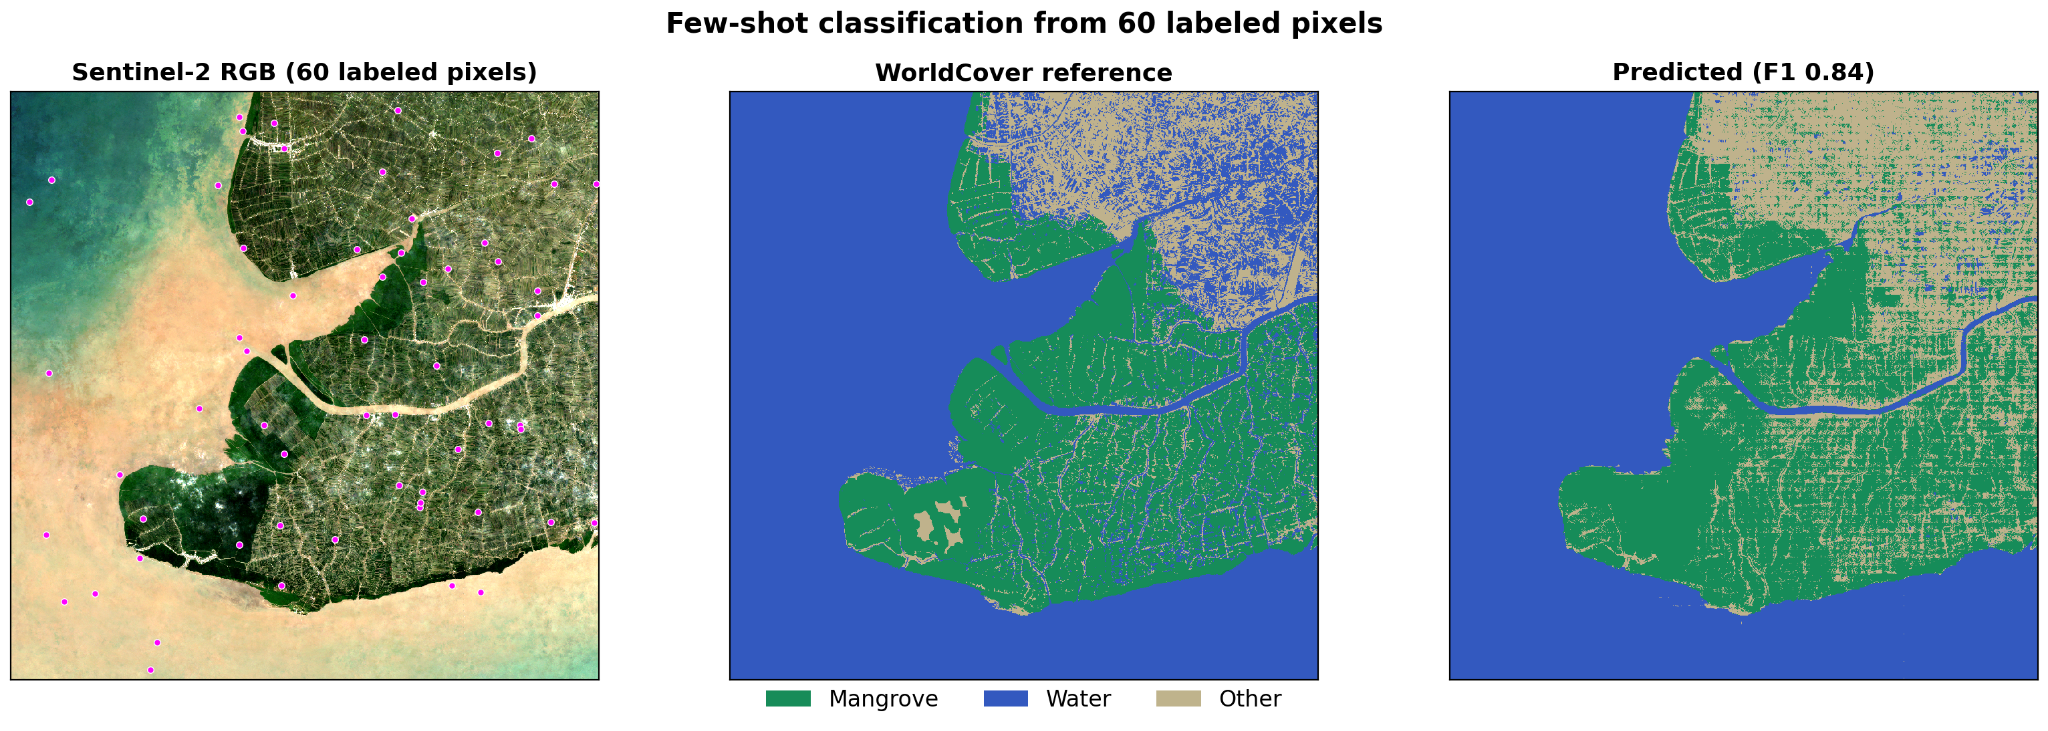
实现这一过程的Python代码非常简洁,仅需几行:加载嵌入COG,重塑为二维数组,训练分类器,然后预测所有像素。这种线性探针方法已成为评估基础模型的标准方式,而OlmoEarth嵌入在如此少的标签下就能取得良好效果,证明了其预训练阶段已经内化了生态学上的区分。
变化检测:捕捉地表动态
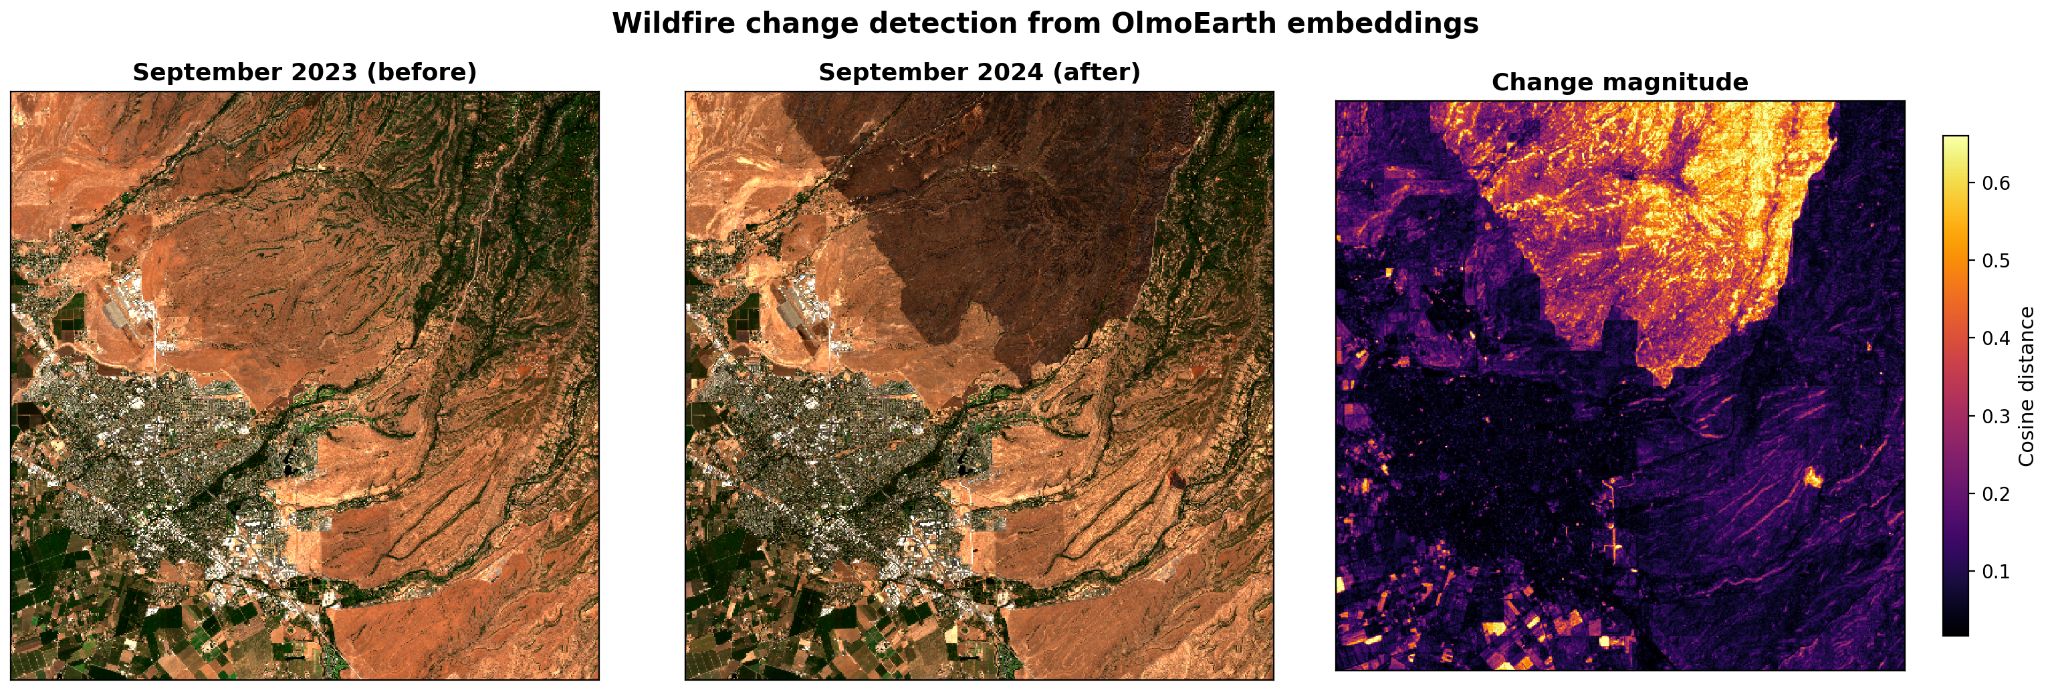
由于Studio支持按月生成嵌入向量,因此可以轻松比较不同时间点的嵌入,以识别地表变化。我们计算了2023年9月和2024年9月同一区域的月度嵌入,并计算了每个像素的余弦距离。在加利福尼亚州比尤特县,2024年7月至9月发生的帕克火灾的烧伤疤痕在差异图中立即显现出来。整个过程无需任何标签或训练,仅需两个嵌入COG和几行Python代码。
这种变化检测方法不仅适用于火灾,还可用于监测洪水、城市扩张、植被变化等。由于嵌入向量对地表特征进行了压缩表示,因此对细微变化也较为敏感,能够捕捉到传统指数(如NDVI)可能遗漏的信息。
无监督探索:揭示模型眼中的景观结构
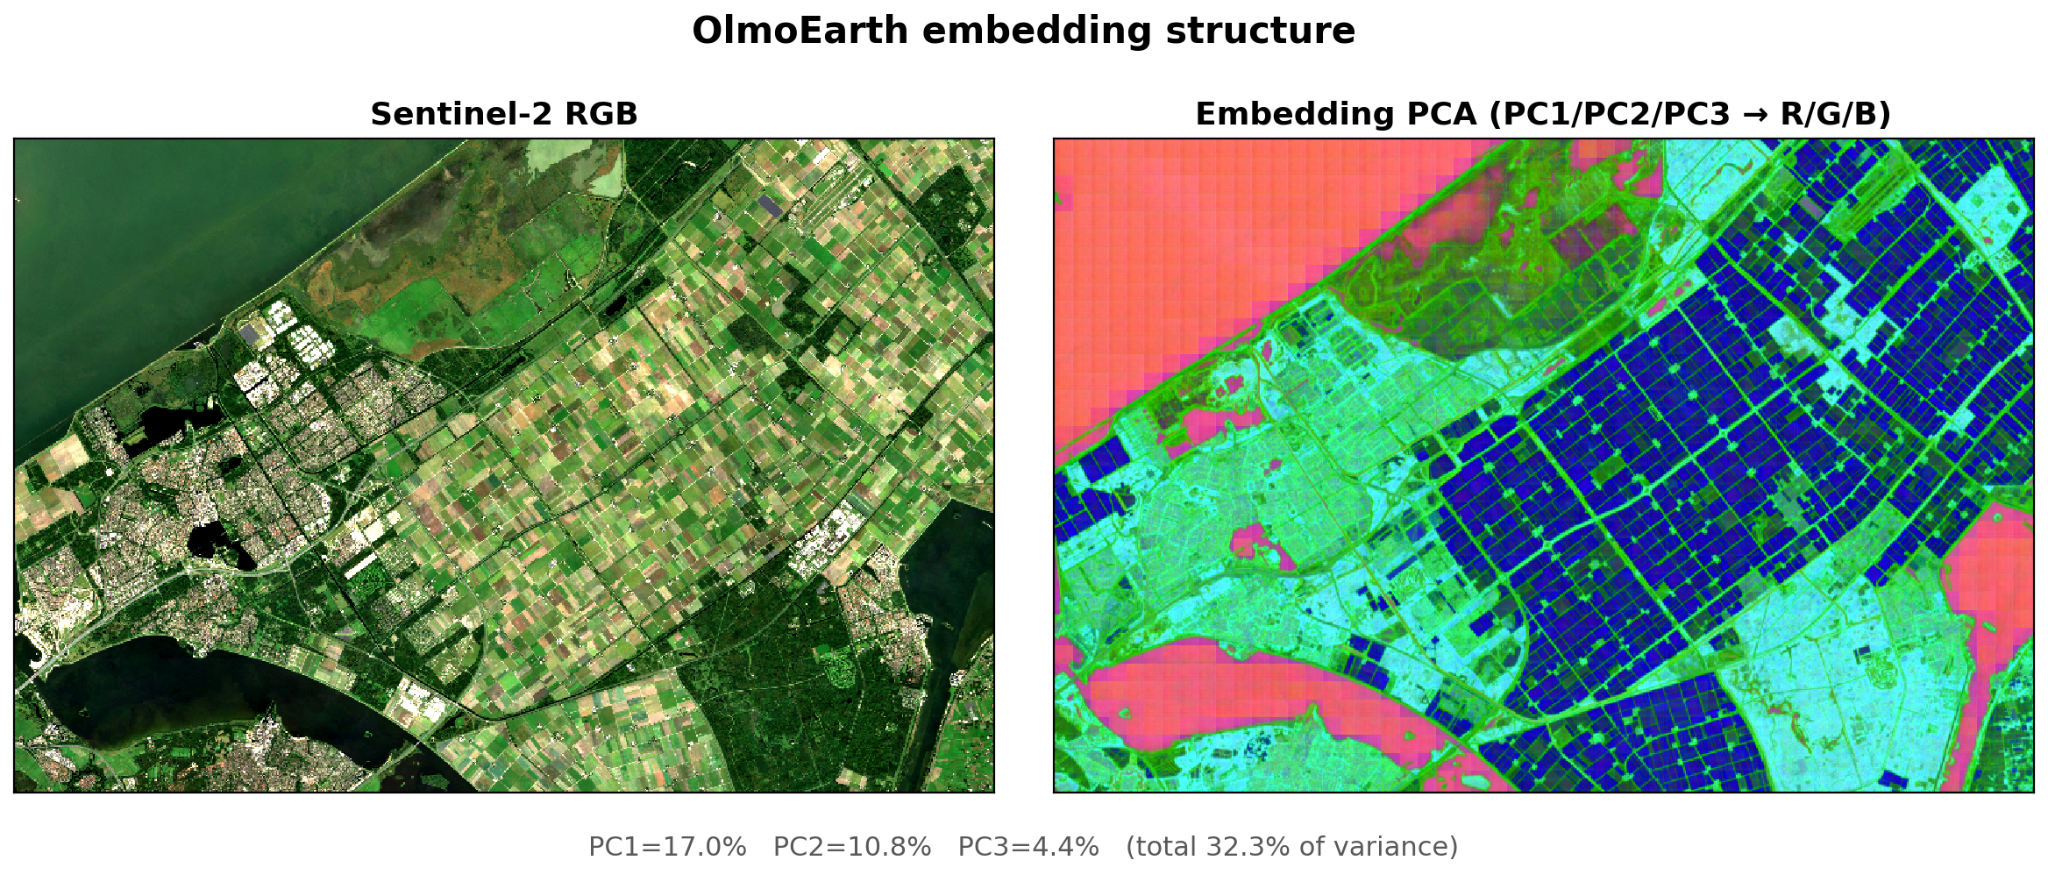
在没有查询点或参考标签的情况下,用户可以通过主成分分析(PCA)来探索嵌入向量的内在结构。将嵌入向量降至三个主成分,映射为RGB颜色,即可生成一幅假彩色图像。相似的嵌入向量会呈现相似的颜色,从而自动揭示地表类型的分布。
以荷兰的弗莱福兰省为例,这是一个经过围海造田形成的圩田景观,具有规则的农业地块网格。PCA假彩色图像完美地再现了这些地块边界,不同的作物类型、水体和城市区域呈现出不同的色调。这表明模型在预训练过程中已经学习到了景观的布局规律,无需任何人工标注。这种无监督视图是快速了解模型在特定区域学到了什么结构的有效手段。
从导出到洞察:实际应用与进一步微调
上述所有应用——相似性搜索、少样本分割、变化检测和PCA可视化——都是对标准栅格数据的简单操作,运行时间仅需几秒。其核心价值在于嵌入向量本身:它们是从数百万个训练样本中学习到的压缩表示,能够捕捉多传感器、多时相的地表特征。
对于需要更高性能的应用,OlmoEarth Studio还支持监督微调(SFT)。用户可以在自己的标注数据上训练任务特定的模型头,这通常比在冻结特征上使用线性探针获得更好的结果。例如,在土地覆盖分类中,微调后的模型可以更精确地识别复杂类别。
当然,嵌入向量的质量也受到输入影像质量的影响。持续的云覆盖、大气伪影或合成期内缺失观测都可能降低向量的准确性。因此,在应用嵌入向量之前,建议使用上述技术进行质量检查,确保其符合预期。
结语
OlmoEarth嵌入向量为地球观测分析提供了一种高效、灵活的新工具。它降低了进入门槛,使得即使没有深度学习背景的研究者也能利用基础模型的力量。通过Studio的定制化导出,用户可以快速生成针对特定区域、时间和分辨率的嵌入,并应用于各种下游任务。随着模型的不断改进和社区的持续探索,嵌入向量有望成为地理空间分析的标准组件,推动遥感应用向更智能、更自动化的方向发展。