Agent记忆赛道迎来ImageNet时刻:AML首期榜单深度解读
当上下文窗口不再是万能药
2026年,大模型上下文窗口已轻松突破200万token,但一线Agent开发者却遭遇了新的瓶颈:将海量历史记录全盘塞给模型,不仅带来指数级增长的API成本,更让模型在冗长、充满噪音的信息中产生严重幻觉。失效的规则被反复执行、过期的偏好无法清除、上一轮会话的教训在下一轮重演。
长期记忆(Long-term Memory)成为Agent实现长期协作的关键,决定了它能否摆脱“永远从头开始”的困境。2026年8月12日,由牛津大学、清北等近30所顶尖研究机构联合发起的Agent Memory Leaderboard(AML,中文名“记忆之巅排行榜”)在Hugging Face Space正式揭榜。首期榜单发布不到48小时,便在全球技术社区引发爆发式讨论,标志着Agent长期记忆赛道迎来了属于自己的“ImageNet时刻”。
现象级热度:一场席卷Agent圈的“记忆大考”
过去两周,AML无疑是Agent领域最受关注的评测。它致力于统一记忆系统之外的关键变量,使不同参评系统在一致条件下接受测试,从而公平、公正、公开地针对记忆系统进行评测。
AML发布之初便引爆了全球开发者社区。官方站点上线两周,点击量突破20万次,首届赛事累计收到超过100个团队的参赛申请。8月12日首期榜单在HuggingFace和官网同步揭晓,放榜不到24小时,微信公众号、Twitter/X等海内外技术媒体相关话题阅读量迅速冲破数十万。
技术讨论的焦点不仅停留在分数与名次,更延伸至评测范式的建构逻辑——评测契约的标准化、评测流程的公正性、评测数据的完整性等。社区不再只是围观名次,而是在认真审视评测机制本身的长期价值。一个首期发布的榜单,能同时收获现象级流量与范式级讨论,印证了两点:其一,Agent记忆已经走向舞台中央;其二,行业对一套可信、公正的记忆度量衡渴求已久。
为什么是AML:三重隔离,打造丈量记忆的权威标尺
AML的诞生源于一个行业共识:大模型的上下文窗口越开越大,但Agent的长期记忆能力并未随之水涨船高。过去,评价一个Agent记性好不好,往往没有统一的数据集、回答模型、提示词和判别模型。最终的高分可能只是因为使用了更强的下游生成模型,或是针对特定Prompt做了过拟合优化,不同记忆系统之间极难进行直接、客观的横向对比。
AML凭借三大硬核设计,建立了目前业界最为严苛且公正的记忆评测体系:
隔离接口边界,让记忆归记忆,生成归生成
AML将参评系统的职责严格收敛到Add(写入)与Search(检索)两类接口——记忆系统只负责接收长周期历史,并在问题到来时返回相关记忆证据;Answer与Eval则由平台以统一的模型、流程和聚合规则完成。只有固定了回答与评分的条件,成绩差异才能最大程度上归因于记忆系统本身。
隔离单一数据集的偶然性——多源数据,能力重构
AML整合PersonaMem、LoCoMo-Refined、BEAM等10余个业界主流基准与平台私有测试集,覆盖超过1500个对话与任务、约1.5亿字符的长程历史、近5000道评测题目。更关键的是,所有题目经人工重构,被映射到统一的记忆能力维度。参评者最终得到的不只是一个名次,而是一张可诊断的能力剖面图。
隔离人为操作空间,可复核、可追溯的评测治理
一个具有行业公信力的榜单,必须对评测契约的可复现性与防刷机制给出透明的工程答复。AML评分环节采用多评审系统(Multi-Agent Judging System),以保证评测结果准确度和一致性;平台统一封装模型、参数与日志,完整保留检索证据、平台答案与评审记录,配合私有测试集与人工标注校准,刷榜与过拟合的空间被压至最低。
统一的接口链路保证公平比较,多源的数据映射保证完整剖面,透明的治理机制保证长期可信——AML正朝着成为全行业公认的Agent记忆能力统一标尺的方向迈进。
榜单深度解读
工业榜单:MemoraX断层领跑,MemOS稳居第二,网易MEMORY-SMART成为黑马
根据AML官网,工业榜前十名中既有头部大模型厂商的闭源产品,也有多家记忆领域创业公司的API服务。
**MemoraX以58.0分总成绩位列第一,在全部七个能力维度中均排名第一,写入、检索效率也稳居第一梯队。**公开报道显示,与传统向量数据库相似度检索的路线不同,MemoraX构建了以“可学习记忆策略引擎、记忆基模、自演进Agent Harness”为核心的Agent记忆技术体系。前者更像是给Agent配了一本可搜索的笔记本,而MemoraX强调的是记忆的持续自进化、动态更新和跨场景复用。这一技术体系的核心目标是解决大模型在长周期、海量级个性化碎片信息处理中的局限性,通过内化记忆能力,解决大模型失忆症痛点,为AI智能体提供原生长效记忆能力。
第二名MemOS在事实召回、多跳推理、时间推理和记忆治理方面表现稳定,但个性化与规则执行相对偏弱。第三名,来自网易的NTES-MEMORY-SMART则成为一匹黑马,其个性化能力达到57.0分,事实召回、多跳推理和规则执行也均位居前列。它呈现出的并非绝对平均的能力结构,而是以“理解和适应用户”为核心优势,同时在主要基础能力上保持中上水平。这种能力结构,可能更适配长期陪伴、个性化客服、内容服务、虚拟角色和个人助理等需要持续理解用户的产品。
此外,最近很火的TencentDB Agent Memory虽以41.5分排名第八,但其规则与工作流执行能力达到28.7分,位列工业榜第二。这代表它返回的记忆更能还原并遵循历史规则、操作流程、组织约束与SOP,因而可能更适合企业知识库、工单、审批和流程型Agent。而海外平台热度较高的Mem0、MemPalace、Supermemory在工业榜仅分别位列第9、10、15名,在高阶记忆能力上暴露出明显短板。
开源方法榜单:InvMem优势登顶,但各家方法竞争胶着
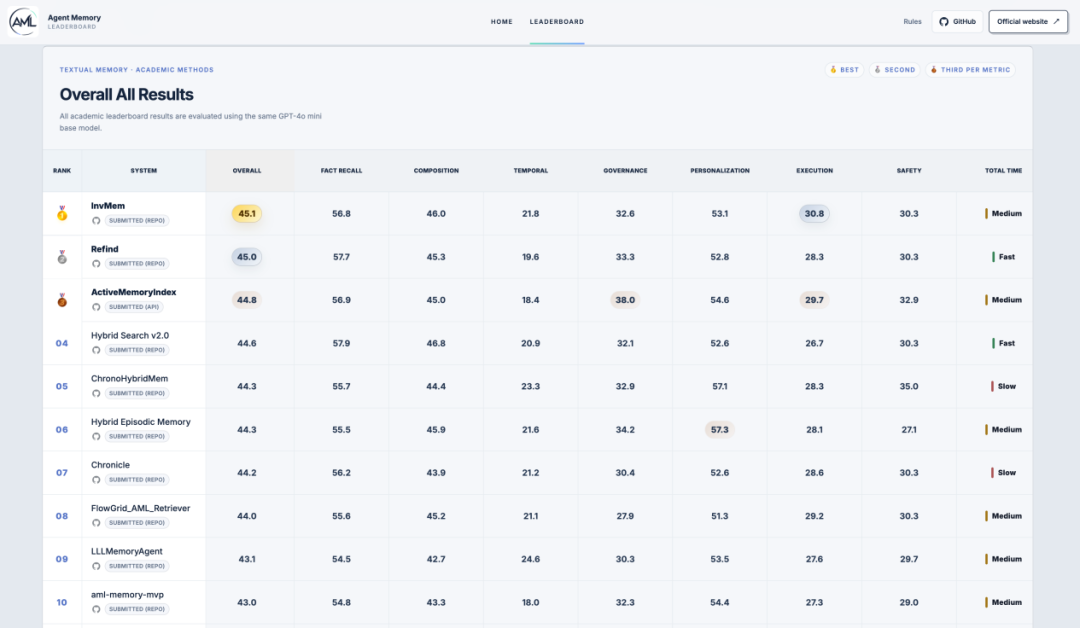
开源方法榜没有出现工业榜式的断层领先。InvMem、ReFind和ActiveMemoryIndex分别以约45.1、45.0和44.8分位列前三,三者也代表了不同的技术取向。从开源榜单公布的代码与结果来看,InvMem在多跳推理、时间推理和规则执行方面更强,其核心仍是经过精细优化的混合检索;ReFind通过模型驱动的迭代式搜索持续调整检索方向,证据定位能力较强,而其代价是额外的模型调用、延迟与费用。ActiveMemoryIndex则在记忆治理、个性化与安全隔离上表现突出,通过细粒度查询改写提供了出色的作用域控制能力。
有技术社区观察人士指出,AML榜单的引爆,标志着Agent长期记忆赛道正式迎来了属于自己的“ImageNet时刻”——它标志着这一领域从各自为战走向标准化评测的开端。
记忆赛道:从附属品走向基础设施层
海内外产学界对AML的热烈关注,折射出记忆正在从大模型的附属功能,蜕变为Agent生态中不可或缺的独立基础设施层。而AML榜单呈现出的多元竞争格局,正是这条赛道想象空间的最佳注脚。
支撑这一判断的信号近期也正在密集出现。AWS、Azure等云巨头已将记忆管理模块内置进自家Agent开发平台,把记忆抬升为平台级能力;Mem0、Graphiti、Supermemory等开源项目则达到数万到数十万星标,创业与融资持续升温。从平台到生态,业界对记忆赛道的布局已经全面铺开。
从本次评测及技术圈的讨论中,可以观察到Agent Memory赛道的三个重要演进趋势:
从“被动存储检索”走向“主动记忆治理”
行业已经跨过“存得多、找得准”的初级阶段,未来核心竞争不再是向量检索,而是记忆的自主理解、筛选、压缩、遗忘、归纳。AI将具备自动淘汰冗余信息、沉淀长期知识、弱化无效短期交互等人类记忆行为,实现记忆生命周期自主治理。这是通用Agent智能跃迁的核心瓶颈。
从“混放共处”走向“工程级隔离管控”
Agent进入生产线后,记忆污染与信息串扰便从算法问题升级为安全事故。下一代记忆系统将像操作系统管理进程一样精细化管理记忆——用户、任务、场景、仓库多维隔离成为默认架构,权限、隐私、生命周期实现精确管控。谁能实现记忆工程级可控,谁才有资格承接企业级市场。
从“单点指标”走向“真实场景全链路闭环”
召回率一个数字定义不了记忆的好坏。行业标准正在升级为融合时序演化、状态迭代、逻辑一致性、隐私约束、动态纠错的全链路评测闭环,更贴近真实商用场景。谁的评测体系更接近真实世界的复杂度,谁就掌握了定义记忆的话语权。
一条赛道走向成熟的标志,从来不是出现了多少玩家,而是出现了公认的度量衡。AML首期榜单的发布,标志着Agent记忆领域正式进入可量化、可比较的标准化阶段,大模型的记忆能力自此有了刻度,而真正的较量,现在才拉开序幕。