端侧AI下半场:端云协同系统设计的五大关键趋势
端侧AI的范式迁移:从"能不能跑"到"怎么跑好"
2024年讨论端侧AI时,重点常是模型能否在手机上运行。现在更实际的问题是:哪些请求留在设备上,哪些请求交给云端,怎样在延迟、质量、网络和隐私之间取舍。这些选择会直接影响产品架构。
范式迁移的背后是三大驱动力。其一是模型能力的分层化。端侧模型负责意图识别、简单推理、实时翻译,云端模型处理复杂分析、知识问答、多步推理。其二是硬件能力的跃升。旗舰手机NPU算力突破50 TOPS,能流畅运行1B-3B参数的端侧模型。其三是网络环境的复杂化。移动网络的不稳定、物联网的边缘场景,迫使架构必须支持离线优先设计。
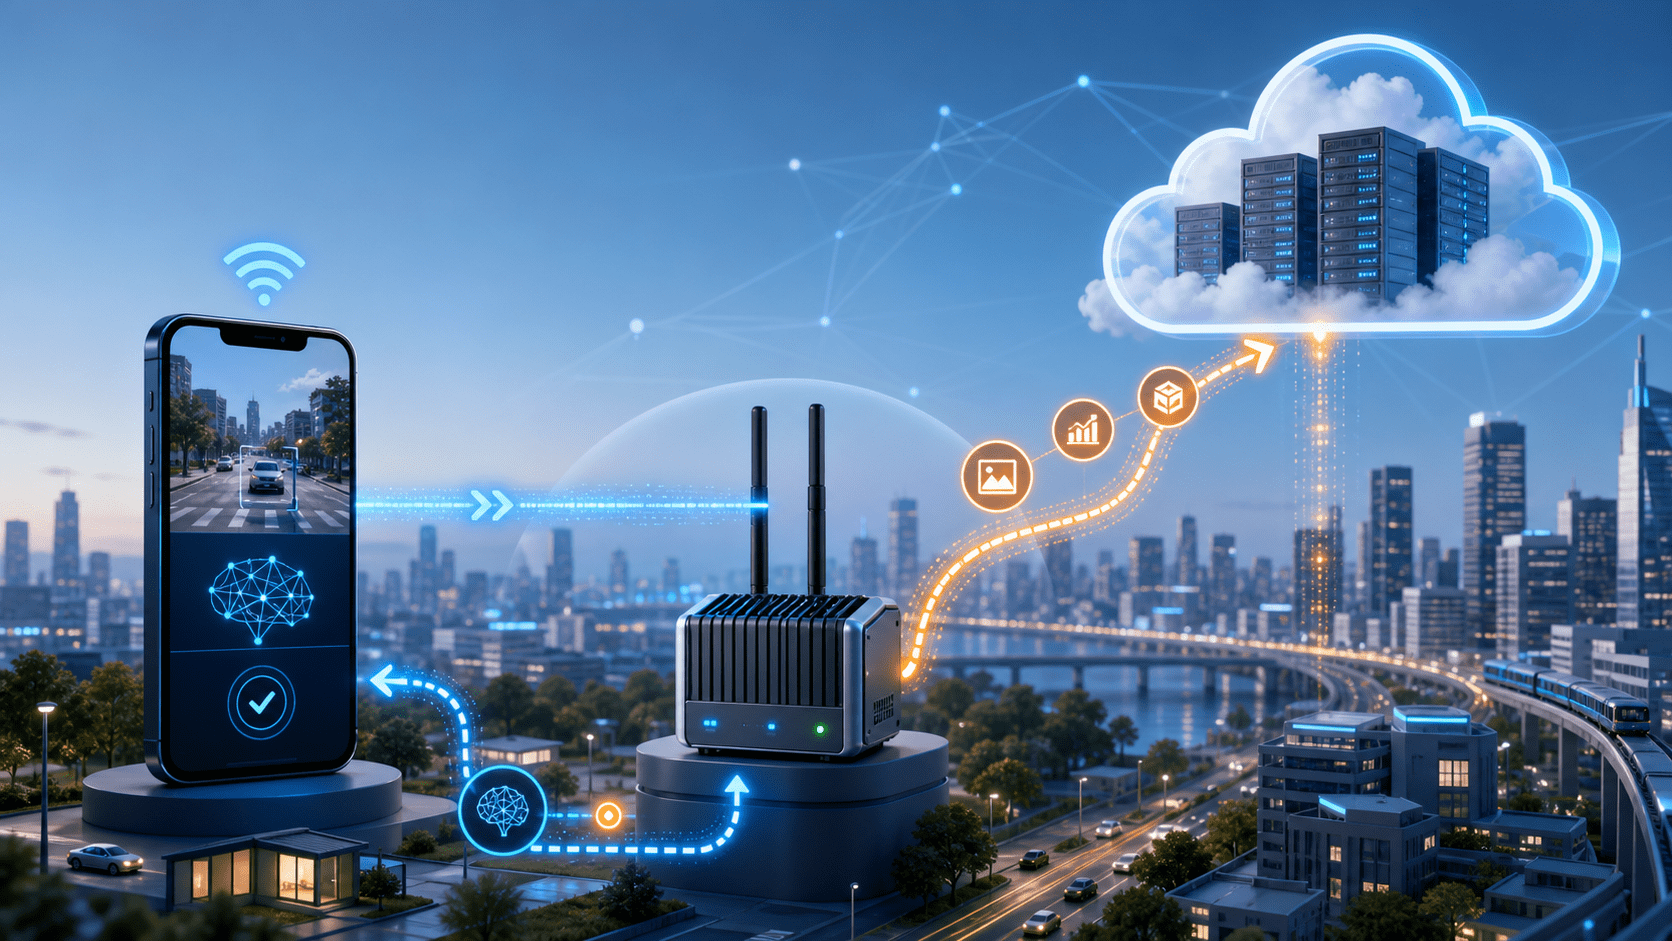
端侧模型部署的三个阶段
阶段一:镜像部署
将云端模型直接量化后部署到端侧,只关心能不能加载运行。使用TensorFlow Lite或ONNX Runtime的量化工具,将FP32模型转为INT8。这个阶段的门槛最低,但模型质量折损也最大。
阶段二:端侧适配
针对端侧硬件进行算子优化。利用NPU的矩阵加速能力,使用厂商SDK进行算子融合。高通SNPE和联发科NeuroPilot都提供了完整的工具链。这个阶段的效果提升明显,但需要为每种芯片分别适配。
import numpy as np
from typing import Optional, Tuple
class OnDeviceInferencePipeline:
"""端侧推理管道:支持多后端切换"""
def __init__(self, backend: str = "qualcomm"):
self.backend = backend
self._initialize_backend()
def _initialize_backend(self):
if self.backend == "qualcomm":
self._init_snpe()
elif self.backend == "mediatek":
self._init_neuropilot()
elif self.backend == "apple":
self._init_coreml()
def quantize(self, model_path: str, precision: str = "int8") -> str:
"""量化模型为端侧格式"""
calibration_data = self._load_calibration()
quantized = self._apply_quantization(model_path, calibration_data, precision)
self._validate_quantized(quantized)
return quantized
def benchmark(self, model_path: str, input_shape: Tuple) -> dict:
"""基准测试:延迟/吞吐/功耗"""
warmup_iters = 10
measure_iters = 100
latencies = []
for i in range(warmup_iters + measure_iters):
start = self._get_timestamp()
self._run_inference(model_path, input_shape)
if i >= warmup_iters:
latencies.append(self._get_timestamp() - start)
return {
"p50_latency_ms": np.percentile(latencies, 50),
"p99_latency_ms": np.percentile(latencies, 99),
"throughput_qps": measure_iters / sum(latencies),
"energy_mj": self._measure_energy(model_path),
}阶段三:模型压缩
使用知识蒸馏、层剪枝、低秩分解等技术,将大模型压缩为端侧尺寸。Meta的MobileLLM系列在技术上取得了关键突破,验证了小于1B参数的模型在特定任务上可以逼近7B模型的表达效果。
端云协同的架构设计
端云协同不是简单的"离线用端侧,在线用云端"。真正的工程挑战在于:如何实现模型的无感切换、如何在网络恢复时优雅同步、如何在隐私约束下共享上下文。
三层路由架构
路由层是端云协同的核心。基于任务复杂度、网络状态、隐私敏感度,将请求路由到端侧、边缘或云端。高德纳的Edge AI报告指出,到2026年底,约40%的企业AI应用将采用端-边-云三层架构。
from enum import Enum
from dataclasses import dataclass
class InferenceTarget(Enum):
ON_DEVICE = "on_device"
EDGE = "edge"
CLOUD = "cloud"
@dataclass
class RoutingDecision:
target: InferenceTarget
fallback: InferenceTarget
reason: str
max_latency_ms: float
class EdgeCloudRouter:
"""端云协同路由决策器"""
def __init__(self, on_device_capability: dict, network_monitor):
self.device = on_device_capability
self.network = network_monitor
self._route_cache = {}
def route(self, task_type: str, input_complexity: float) -> RoutingDecision:
"""决定推理目标"""
cache_key = f"{task_type}_{input_complexity:.2f}"
if cache_key in self._route_cache:
return self._route_cache[cache_key]
decision = self._make_decision(task_type, input_complexity)
self._route_cache[cache_key] = decision
return decision
def _make_decision(self, task_type: str, complexity: float) -> RoutingDecision:
latency = self.network.current_rtt_ms()
# 离线下强制端侧
if latency > 500:
return RoutingDecision(
InferenceTarget.ON_DEVICE,
InferenceTarget.EDGE,
"network_unavailable",
200.0,
)
# 简单任务走端侧
if complexity < 0.3:
return RoutingDecision(
InferenceTarget.ON_DEVICE,
InferenceTarget.EDGE,
"simple_task",
50.0,
)
# 复杂任务走云端
if complexity > 0.7:
return RoutingDecision(
InferenceTarget.CLOUD,
InferenceTarget.EDGE,
"complex_task",
800.0,
)
# 中等任务走边缘
return RoutingDecision(
InferenceTarget.EDGE,
InferenceTarget.CLOUD,
"moderate_task",
200.0,
)隐私与安全的工程权衡
端云协同架构面临的核心矛盾是:云端模型质量高,但需要传输用户数据;端侧模型保护隐私,但能力有限。差分隐私和联邦学习是两种主流的平衡方案。
差分隐私在数据上传前注入噪声,保证单个用户数据的不可区分性。Google的Gboard键盘输入预测是差分隐私在端侧AI的经典案例。联邦学习让模型在端侧训练,只上传梯度更新而非原始数据。Apple在Siri的ASR模型上大规模应用了联邦学习。
class PrivacyPreservingSync:
"""端云隐私同步"""
def __init__(self, epsilon: float = 1.0):
self.epsilon = epsilon # 差分隐私预算
def add_dp_noise(self, embedding: np.ndarray) -> np.ndarray:
"""对embedding添加拉普拉斯噪声"""
sensitivity = np.max(np.abs(embedding)) * 2
scale = sensitivity / self.epsilon
noise = np.random.laplace(0, scale, embedding.shape)
return np.clip(embedding + noise, -1.0, 1.0)
def should_offload_to_cloud(self, query: str, privacy_level: str) -> bool:
"""隐私分级决定"""
pii_patterns = [
r"\b\d{18}\b", # 身份证
r"\b1[3-9]\d{9}\b", # 手机号
]
import re
for pattern in pii_patterns:
if re.search(pattern, query):
if privacy_level == "strict":
return False # 包含PII,不上传
query = re.sub(pattern, "[REDACTED]", query)
return True2026下半年的工程趋势
趋势一:推理框架的成熟
ExecuTorch、MediaPipe和MNN的能力正在靠近,但在设备适配、算子覆盖和调试工具上仍有差异。选型时,兼容现有模型、芯片和发布流程,往往比参数表更重要。
趋势二:端侧Agent的兴起
Apple Intelligence的下一个演进方向是端侧Agent,能在本地完成多步操作而不依赖云端。这将推动端侧模型从"理解"走向"行动",对模型能力提出更高要求。
趋势三:异构计算的深化
CPU+GPU+NPU+DSP的异构调度将成为标配,需要框架层提供统一的算力抽象。开发者不应再手动指定推理后端,而应由运行时自动根据负载动态调整。
结语
端侧AI的下半场,系统设计的重要性日益凸显。从模型部署到端云协同,每一个环节都需要精细的权衡与创新。开发者需要紧跟趋势,灵活运用各种技术手段,才能构建出高效、安全、智能的端云协同AI应用。