循环神经网络的困境与突破:为什么模型有时真的不想学习?
循环神经网络的发展历程充满了意外与挑战。十多年前,Ilya Sutskever提出的观点认为模型具有内在的学习驱动力,只要提供足够的数据和算力,模型就会自主寻找学习路径。这一理念推动了整个行业的快速发展,模型规模不断扩张,训练数据持续增长,算力投入屡创新高。然而,当研究者们开始关注循环网络和隐空间的特性时,情况发生了根本性的变化。
循环模型的设计理念看似简单而优雅:通过在隐空间中反复计算,让同一组网络层多次运行,从而为模型提供更多计算时间。按照理论设想,面对复杂问题时,模型可以多思考一会儿,就像人类在解决难题时需要反复推敲一样。但是现实往往比理论更加复杂,许多模型在实践中表现出明显的局限性。
研究表明,一些模型只能有效利用训练过程中见过的循环深度。当要求它们进行更多轮次的计算时,这些模型可能会偏离正确的解决方案,甚至产生更糟糕的结果。这种现象被形象地描述为模型不愿意学习,实际上反映了循环神经网络在架构设计和训练策略方面存在的深层次问题。
当前主流的Transformer架构采用了不同的策略来应对复杂推理任务。当用户激活大模型的深度思考功能时,会看到冗长的文本输出,其中包含了大量的尝试、推翻和重新思考的过程。虽然这些内容看起来像是废话,但实际上展现了模型的推理轨迹。尽管不能完全代表模型内部的计算过程,但这表明了Transformer解决难题的有效方法:边说边想。
标准Transformer架构类似于一栋楼层固定的建筑,信息从底层输入,依次通过每一层,最终从顶层输出。无论面对简单的一加一运算还是复杂的数学证明,每次生成下一个token时,模型经历的网络深度基本相同。为了克服这一限制,研究人员采用了多轮计算的策略。
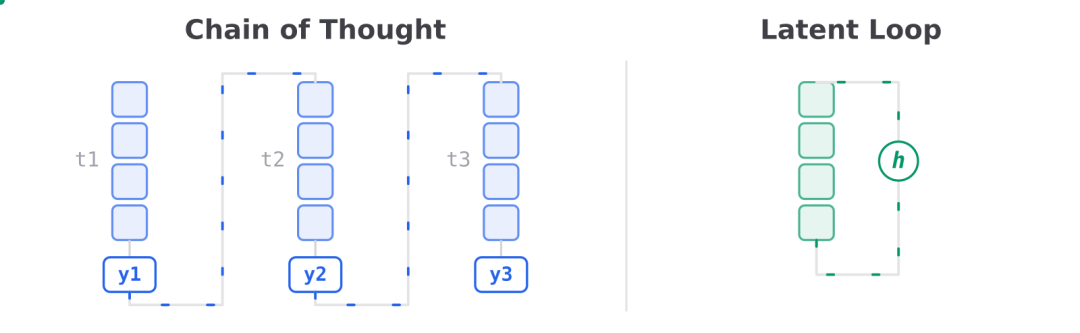
模型首先生成一个token,然后携带之前的上下文进入下一轮计算。输出越长,同一套网络被调用的次数就越多,模型获得拆解问题、检查答案和修正答案的机会也随之增加。这种方法使原本网络深度固定的Transformer能够根据题目难度灵活分配计算量:简单问题快速回答,复杂问题详细分析,必要时还可以让多个答案相互验证。
然而,这种思考方式也存在明显缺陷。模型的内部表示存在于高维连续的隐状态空间中,由于必须通过输出序列来传递信息,许多中间计算过程也被迫组织成可输出的形式。即使某些步骤没有输出的必要,模型也必须生成相应内容才能继续前进。
基于这一认识,研究者们探索了另一种路径:直接在网络层内部实现循环。循环模型的核心思想非常直接:既然单次网络遍历不足以解决问题,那就返回到某些网络层再次执行。每次循环都会更新隐状态,同时复用相同的参数组。
思维链方法通过生成token来串联多次计算,而隐空间循环则让隐藏状态在同一组网络层中反复更新。Universal Transformer、Deep Equilibrium Model以及近年来的循环Transformer都在探索同一个问题:能否让模型根据题目难度自主决定在内部循环多少次?
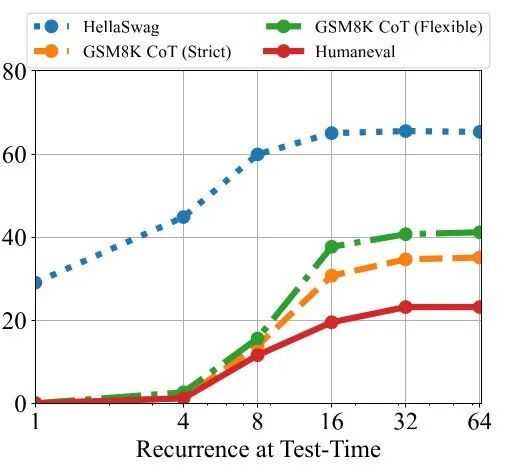
实验结果表明,这种想法确实具有可行性。2025年的一项潜在推理研究将循环深度模型扩展到35亿参数,并使用8000亿token进行训练。测试结果显示,当研究者让同一计算模块多次运行时,模型在部分推理任务上的表现确实持续提升,最多能够利用相当于500亿参数模型完成一次前向传播的计算量。
随着测试时循环次数的增加,模型在GSM8K、HumanEval等任务上的表现继续提高,不同任务在不同深度下趋于饱和。这一发现为循环神经网络的发展提供了有力支持,证明了循环计算在提升模型性能方面的潜力。
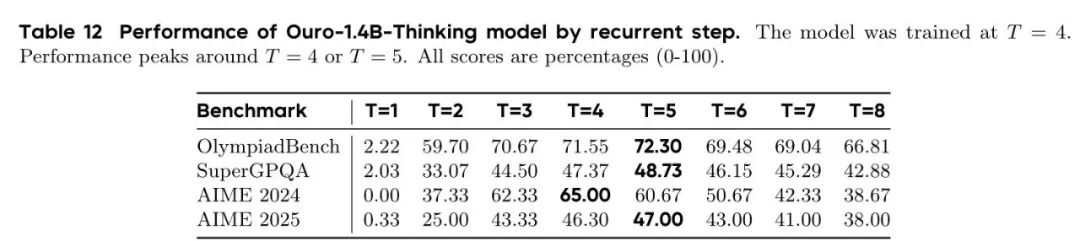
然而,循环次数并非越大越好。2025年发布的循环语言模型Ouro在早期尝试使用8轮循环训练时,很快就出现了损失尖峰和梯度振荡现象。研究者随后将主要训练阶段的循环深度降低到4轮。在测试阶段,虽然将循环次数增加到8轮,但额外计算并未带来更好的结果。
以1.4B参数的Ouro-Thinking为例,该模型在AIME 2024上的成绩从第一轮的0分逐步上升,在第四轮达到65分,但继续循环到第八轮时,成绩反而下降到38.67分。这表明多余的循环轮次不仅没有帮助,反而产生了负面影响。
当前循环模型面临的挑战可以归纳为三个关键问题。首先是理论层面的可行性:共享同一组参数并循环更新隐状态,是否足以表达复杂的计算过程?其次是实践层面的学习能力:模型能否真正掌握这种计算方式?最后是应用层面的稳定性:训练完成后,模型在推理阶段能否持续稳定地进行循环计算?
第一个问题已经得到了相对乐观的答案,真正的困难主要集中在后两个方面。反复调用同一网络结构会导致误差累积,循环次数增加后,隐状态可能表面稳定但实际无法支撑正确结果。
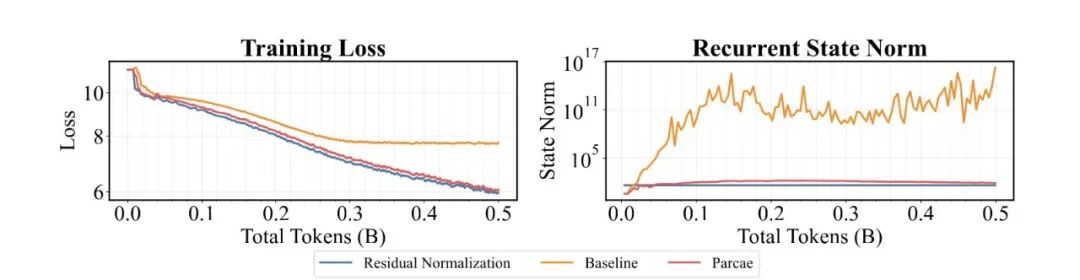
2026年的Parcae研究发现了循环语言模型容易出现残差爆炸和损失突然上升的问题。通过重新设计循环过程中的稳定机制,模型的验证集困惑度最多降低了6.3%。扩展到13亿参数时,该模型在固定参数量和数据量条件下超过了传统Transformer基线。
普通循环基线的循环状态范数迅速爆炸,训练损失随后停止下降,而加入稳定机制的Parcae和残差归一化模型则保持了稳定性。这一结果为解决模型不愿学习的问题提供了新的思路。
与已经磨合多年的标准Transformer相比,大规模循环语言模型的训练策略远未成熟。标准Transformer拥有完整的训练工具包,包括残差连接、归一化、初始化方法、学习率策略和优化器,这些技术在实践中已经得到充分验证。
相比之下,循环模型的训练配方仍需进一步完善。架构设计、优化器选择、损失函数定义和中间监督策略应该如何搭配,可能还需要探索更有效的组合方案。这不仅是技术问题,更是对整个深度学习理论体系的挑战。
循环神经网络的发展历程揭示了人工智能领域的复杂性和挑战性。虽然传统观点认为模型具有内在的学习驱动力,但实际情况表明,模型的学习意愿和能力受到多种因素的影响。循环模型的研究不仅推动了技术进步,也为理解智能的本质提供了新的视角。
未来的研究方向应该重点关注循环稳定性的改进、训练策略的优化以及理论基础的完善。只有解决了这些问题,循环神经网络才能真正发挥其潜力,为人工智能的发展开辟新的道路。同时,这也提醒我们,对于复杂系统的理解和控制仍然需要更多的理论创新和实践探索。
循环神经网络的困境与突破反映了整个深度学习领域的发展特点:理论与实践并重,创新与挑战共存。随着研究的深入,相信会有更多有效的解决方案出现,推动人工智能技术向更高水平发展。