AI世界模型重大突破:智象未来发布全球首款原生全模态交互式世界
过去三年间,AI内容生成领域经历了前所未有的技术变革浪潮。从最初的文本生成到图像创作,再到视频制作,每一项技术突破都推动着行业向前发展。然而,深入分析这些进展后可以发现,现有的AI生成技术仍然停留在传统的单向输出模式:用户输入提示词,模型生成内容,用户被动接受结果。这种范式虽然在视觉质量上不断提升,但在交互性和持续性方面存在根本性局限。
传统AI生成技术的本质是创造静态内容而非动态世界。无论生成的视频多么逼真,用户始终处于观察者的角色,无法真正进入、修改或持续影响生成的虚拟空间。这种局限性制约了AI在更多应用场景中的发挥,特别是在需要深度交互和持续演化的场景中。
行业内的技术专家们早已认识到这一问题的重要性,世界模型概念应运而生。谷歌、World Labs等知名机构纷纷投入大量研发资源,试图构建真正意义上的交互式虚拟世界。然而,市场上的产品究竟是真正在构建可交互的世界,还是仅仅在渲染更加精美的画面,这个问题一直存在激烈争论。
智象未来HiDream.ai的最新成果为这场争论提供了明确答案。该公司正式发布了全球首款原生全模态交互式世界模型HiDream-O1-World,这一突破性产品基于自主研发的UiT统一架构,彻底改变了AI内容生成的基本范式。
HiDream-O1-World的核心创新在于其原生全模态UiT架构设计。该架构摒弃了传统多模态系统的拼接逻辑,将文本、图像、交互等多种输入模态统一映射到共享Token空间中。在这种设计下,图像像素、文本Token、视频体素、音频信号、动作指令、空间坐标等原始信号都在同一套Transformer网络中进行处理,实现了真正的统一理解和生成。
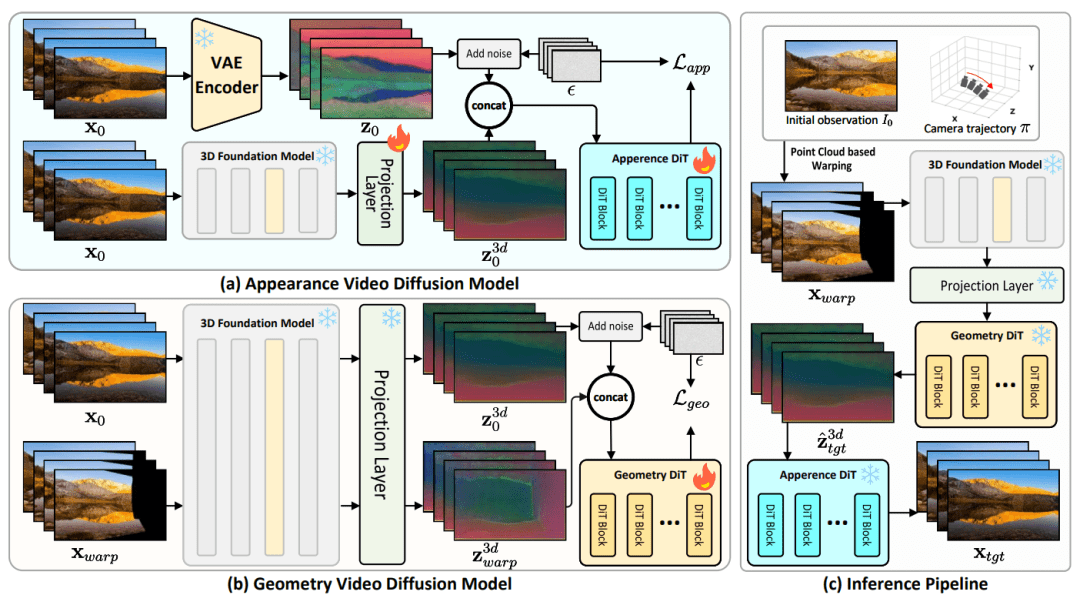
这种架构创新带来了显著的技术优势。传统多模态系统通常采用独立的文本编码器、图像编码器和视频处理模块,各模块独立工作后再通过翻译层交换信息。这种设计的缺陷在于模态间的理解是间接的,跨模态因果逻辑容易在翻译过程中丢失。UiT架构通过统一表征空间解决了这一问题,使模型能够在单一框架内同时处理多种模态信息。
在实际应用中,这种统一处理能力表现为更强的物理一致性和时空一致性。当模型处理苹果从树上落下的场景时,不再是分别理解图像中的运动和文本中的物理概念,而是在统一表征空间中完成对物理因果关系的整体推理。这使得生成的世界更加符合现实世界的物理规律。
HiDream-O1-World在权威评测中表现出色。在美团LongCat与复旦大学联合推出的交互式世界模型评测基准WBench中,该模型首次参评即在Navi分榜中登顶,超越了腾讯混元1.5、阿里Happy Oyster等同类产品。具体而言,HiDream-O1-World在物理维度得分73.3,排名第一;在一致性维度得分88.0,综合排名第一。
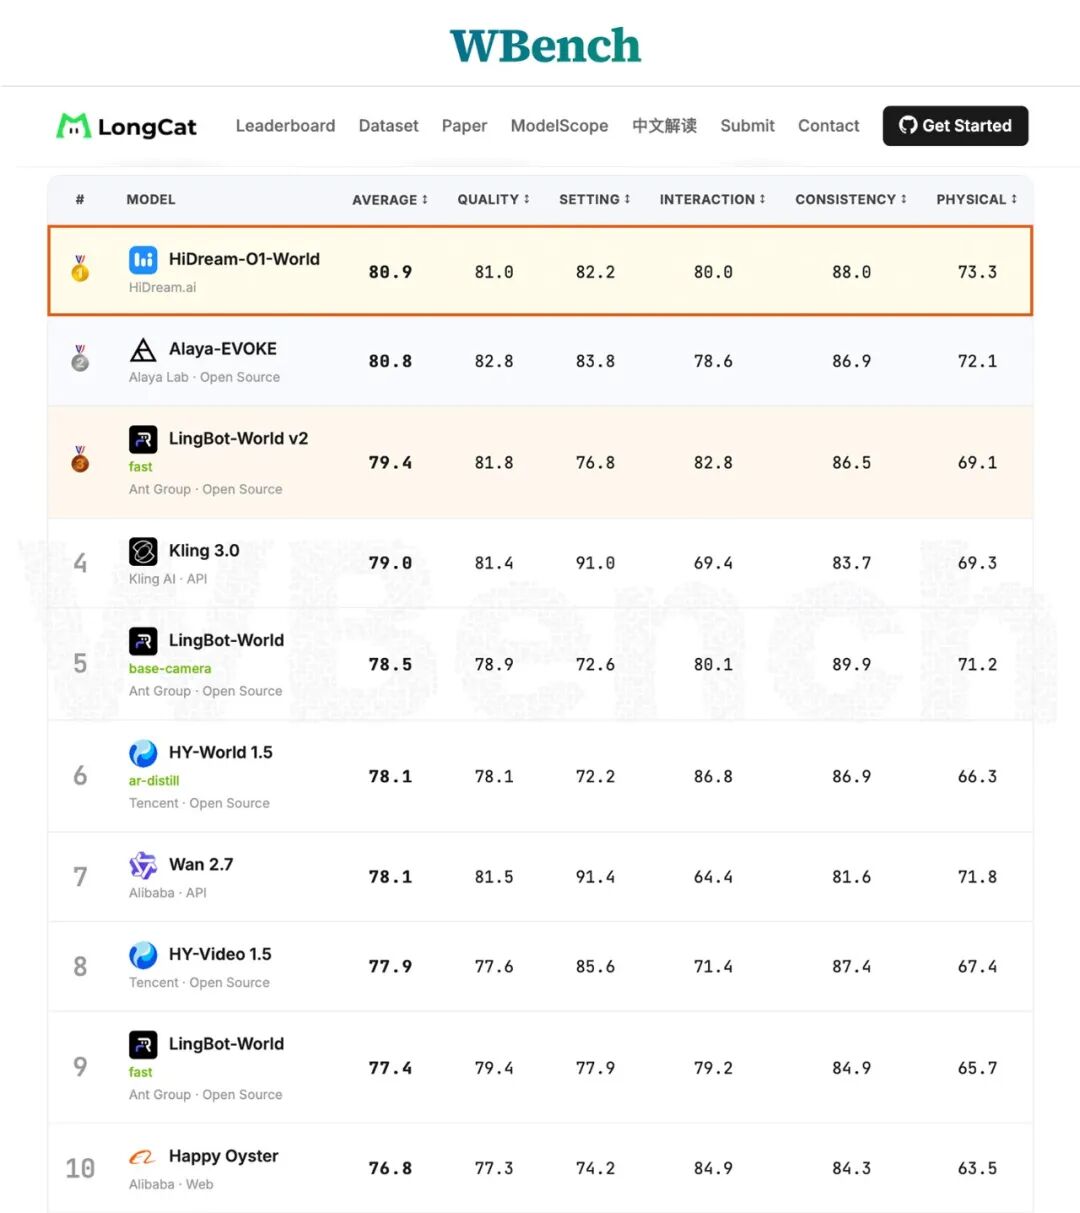
物理维度主要评估生成结果的视觉物理合理性与因果正确性。例如,当物体发生碰撞或表面交互时,结果是否符合基本物理逻辑。HiDream-O1-World在这一维度的优异表现说明其能够准确模拟现实世界的物理现象,生成的结果具有较高的可信度。
一致性维度考察场景记忆、空间结构和跨帧逻辑在持续生成过程中的稳定性。这一指标对于交互式世界模型至关重要,因为用户需要在生成的世界中进行长时间探索和交互。HiDream-O1-World在一致性方面的突出表现确保了用户体验的连贯性和真实性。
HiDream-O1-World提供了多种交互模式,其中漫游模式是最基础也是最重要的功能之一。在该模式下,用户如同置身真实世界,在模型生成的场景中自由移动探索。通过简单的移动控件,用户可以控制角色前进、转向或停留,同时支持第一人称和第三人称视角的自由切换。
以雪山攀登场景为例,用户可以通过移动控件控制角色的前进方向,随着角色不断前行,前方路径和周围环境会根据位置变化实时更新。当角色沿原路返回时,此前生成的地形和场景能够保持高度一致,整个过程类似于真实登山中的连续探索体验。视角切换自然流畅,画面整体稳定,几乎不存在明显的卡顿或漂移现象。
编辑模式进一步扩展了用户的交互能力。在该模式下,用户可以直接对生成的画面进行实时编辑,包括驱动角色执行抓取、奔跑、下蹲、跳跃等各种动作,或者触发环境变化如降雨、物体坠落等动态事件。每次动作转换和场景交互都基于真实的物理模拟,同时保持全局统一性和音视频同步。
在骑行场景的实际演示中,当用户输入