WAM-Diff2突破自动驾驶瓶颈:离散扩散架构如何实现15倍解码加速
自动驾驶技术的发展正在经历一场深刻的架构革命。传统的自回归视觉-语言-动作(VLA)模型虽然在多任务处理方面表现出色,但其固有的串行解码机制和曝光偏差问题,严重制约了实际部署的可行性。复旦大学与引望智能的最新研究成果WAM-Diff2,为这一难题提供了全新的解决思路。

传统自回归VLA模型在自动驾驶应用中面临两个核心挑战。首先是效率瓶颈,逐Token串行生成的计算模式使得推理延迟随序列长度线性增长,这对于需要毫秒级响应的自动驾驶系统来说是致命缺陷。其次是鲁棒性问题,训练阶段的teacher forcing机制与推理阶段的真实环境存在分布差异,导致早期误差在长时序中持续累积,形成曝光偏差。这些问题在复杂的驾驶场景中尤为突出,直接影响系统的安全性和可靠性。
扩散模型的出现为解决这些问题提供了新的可能性。与自回归模型不同,扩散模型支持多位置并行更新,能够在多轮去噪过程中反复修正中间结果。这种特性天然适合处理自动驾驶中的长时域规划任务,但直接从头训练扩散模型会丢失自回归模型已积累的丰富语义知识和多任务推理能力。
WAM-Diff2的核心创新在于提出了一个系统性的架构转换范式。该框架不是简单地替换模型架构,而是通过精心设计的三级层次化蒸馏策略,将成熟的自回归VLA模型平滑迁移到离散扩散架构。这种方法既保留了原有模型的多任务能力,又获得了扩散模型的并行执行优势。
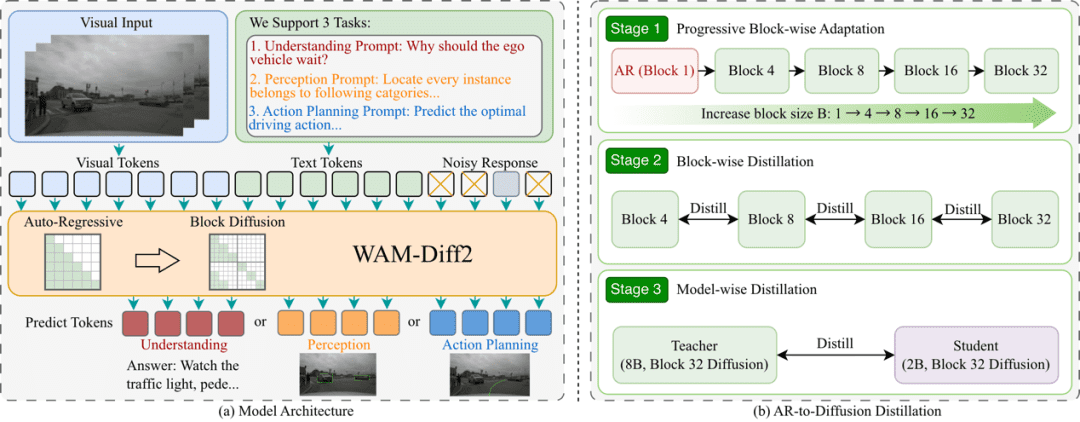
Block-Causal注意力机制是WAM-Diff2技术架构的关键组成部分。该机制将输出序列划分为多个解码块,块内Token可以双向交互并行修正,块间保持因果依赖关系。块大小B成为连接自回归和扩散两种生成范式的连续调节变量,当B=1时等价于标准自回归解码,随着B值增大,单次并行处理的Token数量相应增加。
这种设计巧妙地解决了从顺序生成到并行生成的过渡问题。通过将自然语言问答、二维检测和运动规划统一序列化到相同的Token空间,WAM-Diff2确保了架构迁移过程中多任务能力的完整性。整个转换过程不引入任何任务专用头,保持了模型的统一性和通用性。
三级层次化蒸馏策略体现了WAM-Diff2方法论的系统性。第一阶段的渐进式块级适配通过将解码块大小按1→4→8→16→32逐级扩大,每一级均以前一级权重初始化,使模型在小幅结构变化中逐步学习更大范围的双向依赖。这种渐进式调整有效避免了大步长切换可能导致的优化崩溃,确保注意力机制转换过程的稳定性。
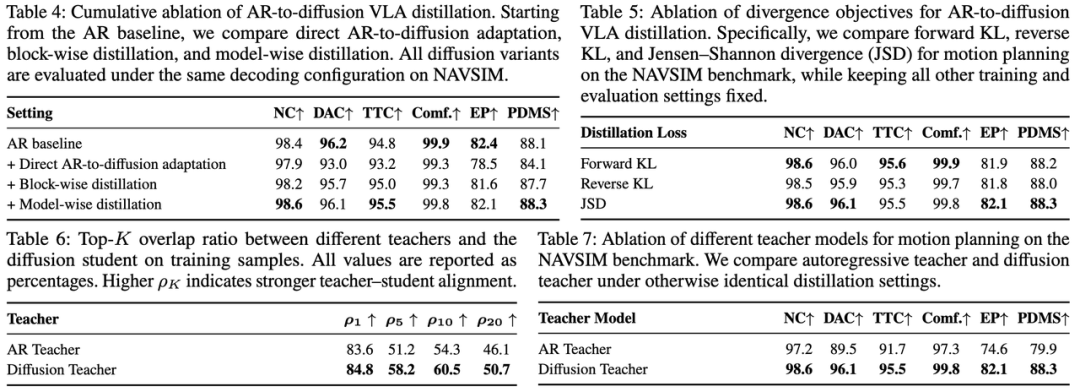
第二阶段的范式一致块级蒸馏采用小块扩散教师模型指导更大块的学生模型。教师与学生在同一受损序列上进行预测,采用对称Jensen-Shannon散度对齐Token分布。相比前向KL散度容易引发的mode-covering行为,JSD能够更好地保留多模态轨迹分布特性,使学生模型学会处理带噪、不完整的中间状态。
第三阶段的跨规模模型级蒸馏利用8B、Block-32扩散模型指导2B、Block-32学生模型。研究发现,8B扩散教师与2B学生的Top-5 Token重合率达到58.2%,显著高于8B自回归教师的51.2%。这表明除了教师规模外,师生生成范式的一致性同样是知识高效迁移的重要前提。
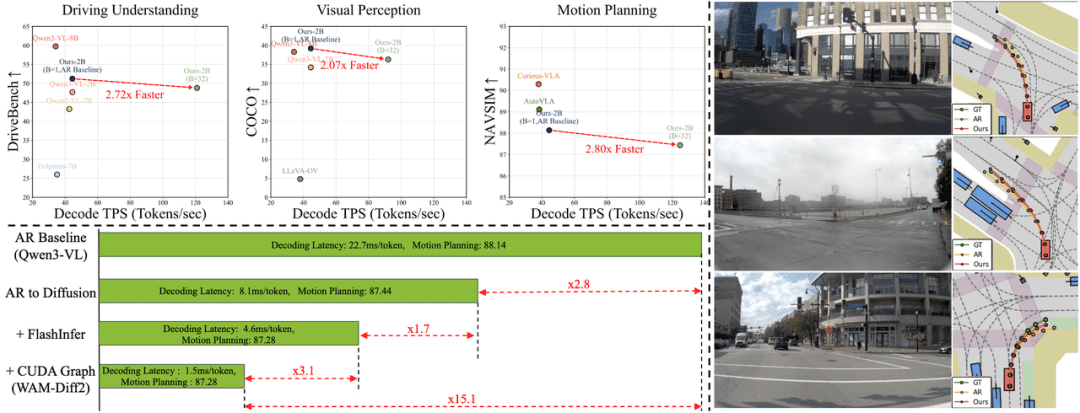
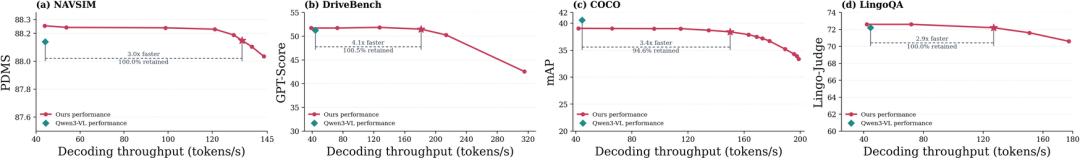
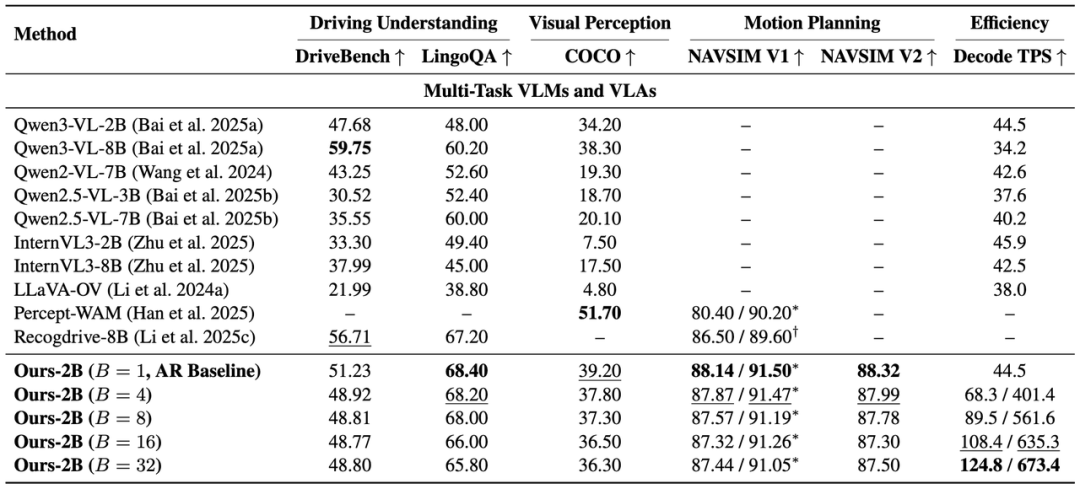
系统级加速效果验证了WAM-Diff2的实用价值。在统一多任务模型下,Block-32的标准实现达到124.8 Tokens/s,较自回归基线的44.5 Tokens/s提升2.8倍。通过针对Block-Causal注意力模式定制FlashInfer计算内核,共享内存吞吐进一步加速1.7倍。利用CUDA Graphs封装固定去噪步数的执行图,消除CPU逐算子发射开销,再加速3.1倍。
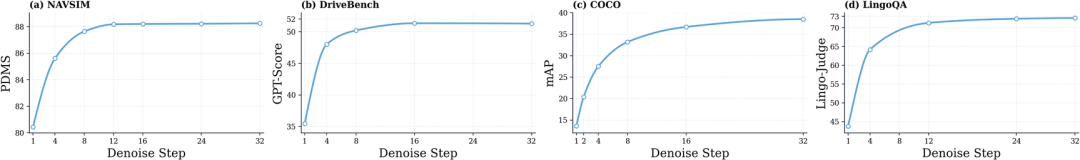
最终解码延迟从22.7 ms/token依次降至8.1、4.6与1.5 ms/token,形成15.1倍累计加速,峰值吞吐达673.4 Tokens/s。值得注意的是,运动规划指标变化不超过0.5个百分点,证明了加速过程对模型性能的影响极小。实验还表明,各基准上的性能大多在8~16个去噪步附近趋于饱和,为实际部署提供了灵活的配置选项。
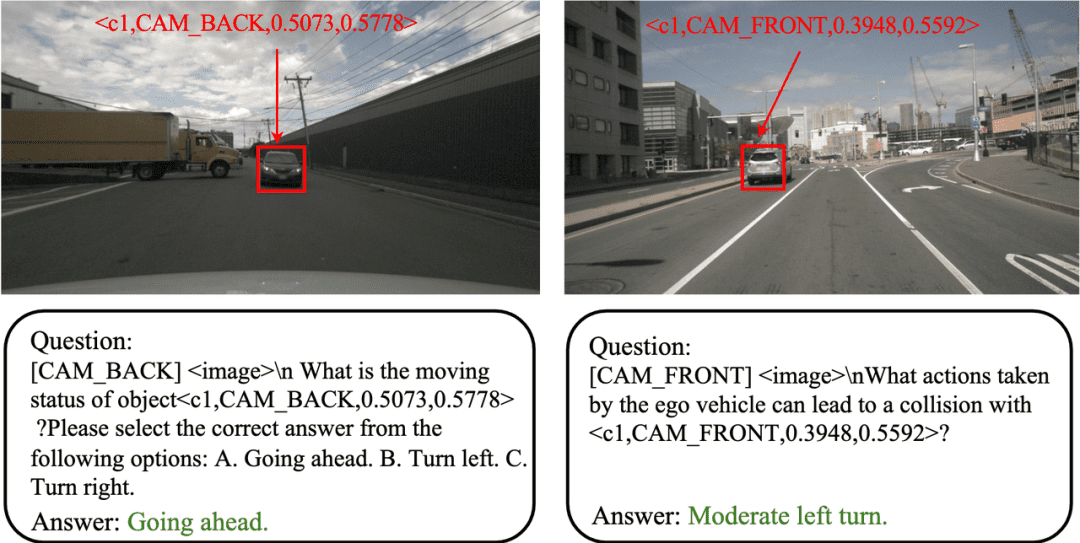
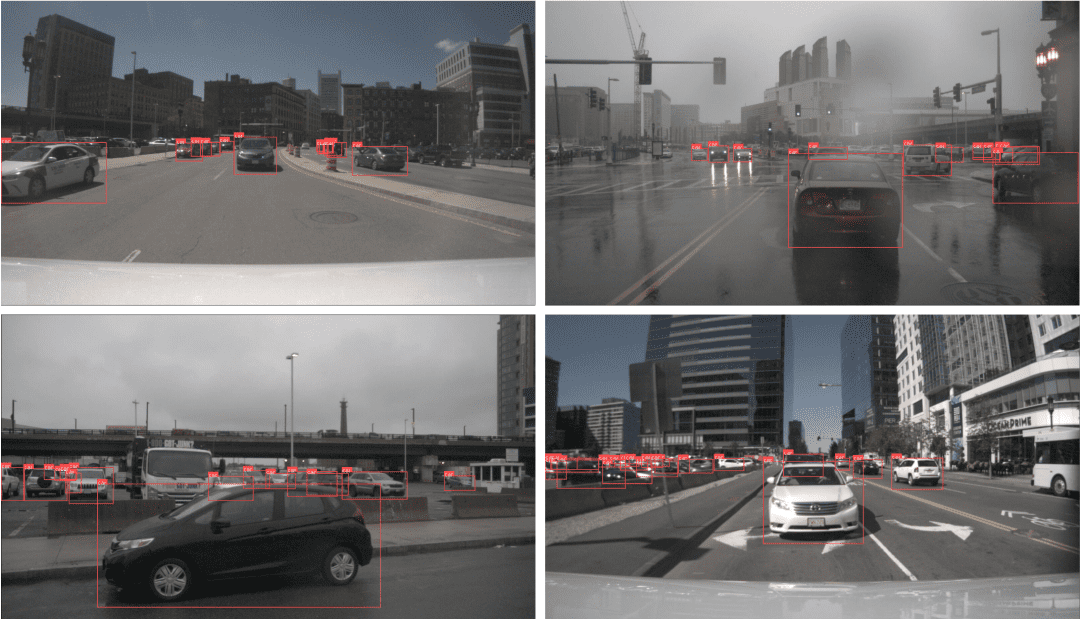
多基准测试结果充分展示了WAM-Diff2的综合能力。在统一多任务协议下,2B、Block-32模型取得48.80 DriveBench、65.80 LingoQA、36.30 COCO mAP、87.44 NAVSIM-v1 PDMS与87.50 NAVSIM-v2 EPDMS的成绩。这些结果来自同一冻结检查点,证明了模型在保持多任务能力的同时实现了显著的并行收益。
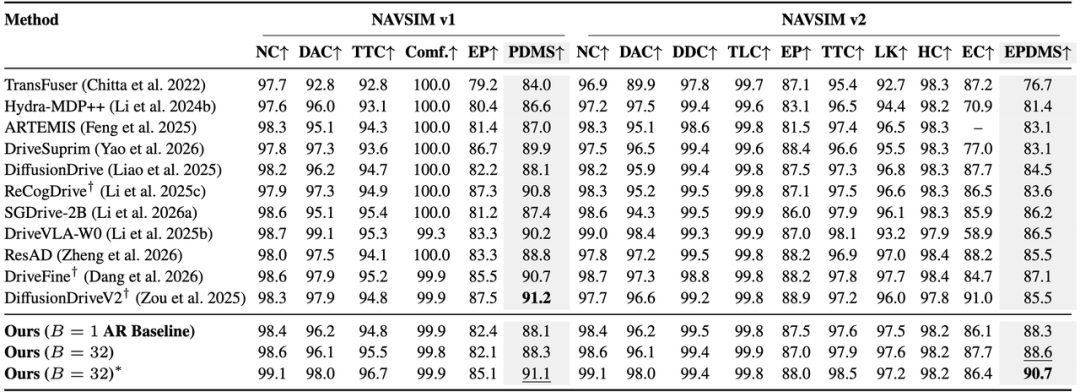
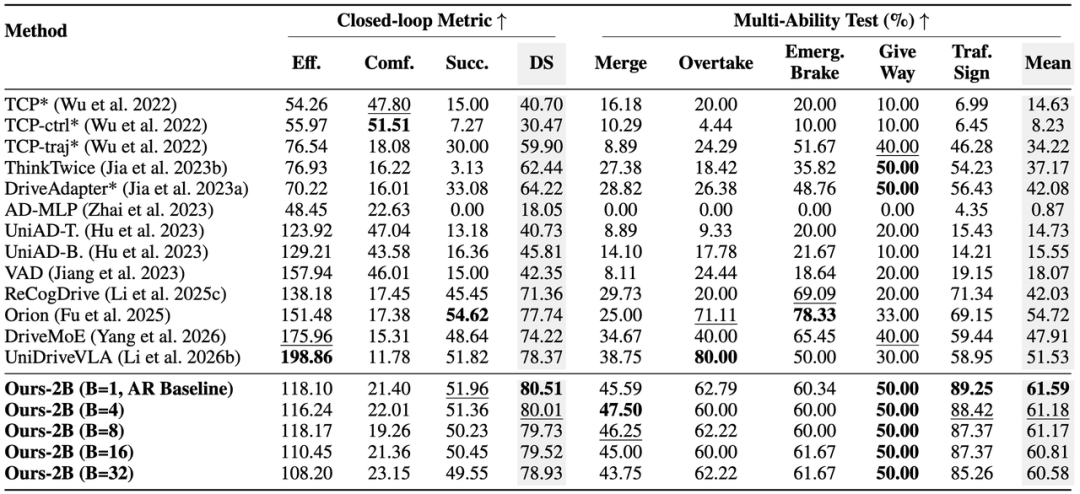
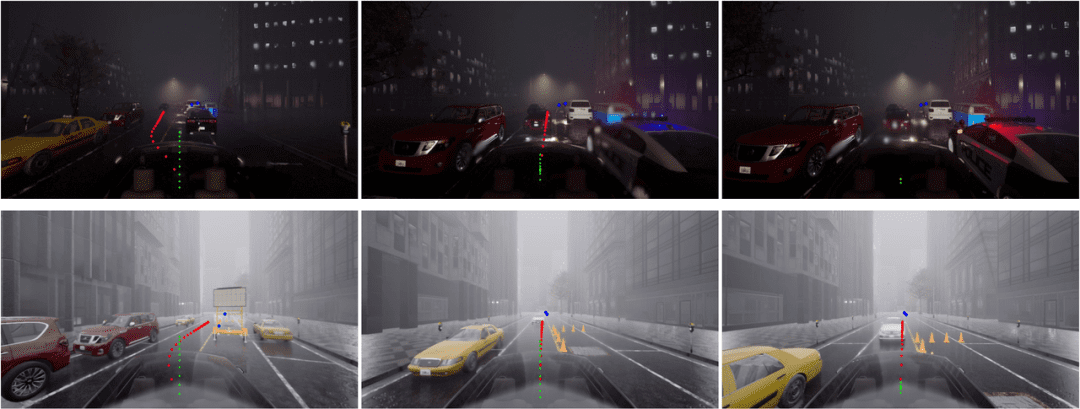
在任务专用的NAVSIM设置下,Block-32取得88.3 PDMS与88.6 EPDMS,结合候选轨迹评分后进一步提升至91.1与90.7,优于ReCogDrive、DriveVLA-W0等先进专用规划模型。Bench2Drive闭环仿真中,模型取得49.55%成功率与78.93驾驶得分,在紧急制动、交通标志遵守等安全关键场景中保持较强表现。
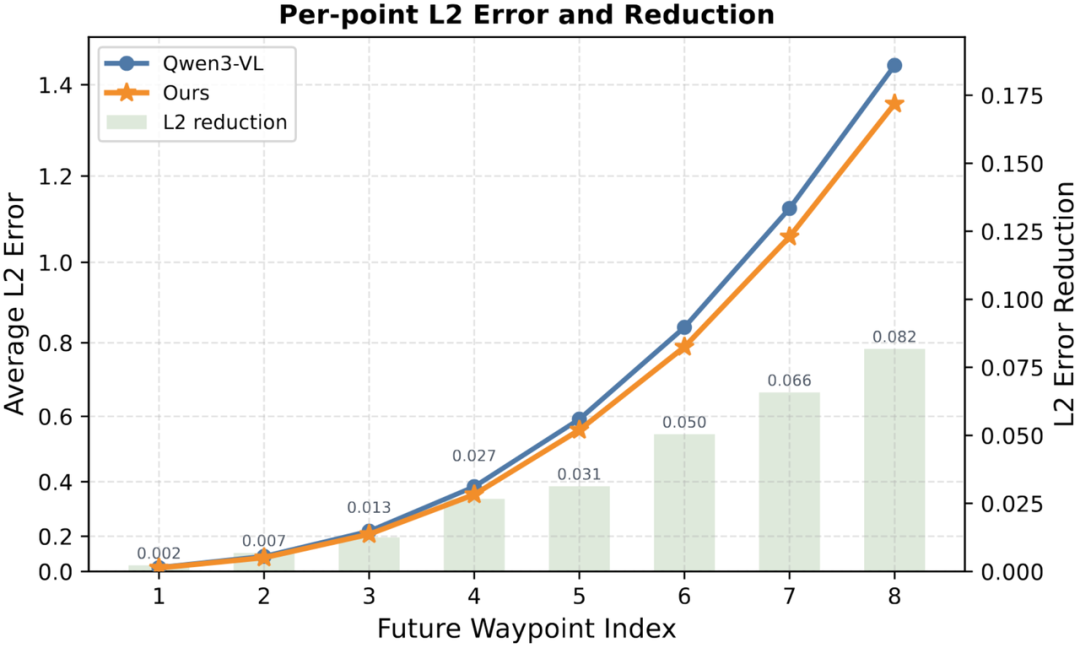
长时域误差分析进一步揭示了扩散生成的优势。在12,146个NAVSIM配对样本上比较未来路点的L2误差显示,自回归基线的平均误差为0.5935米,WAM-Diff2为0.5589米,整体降低5.8%。两者的误差差距从第一个路点的0.002米单调扩大至第八个路点的0.082米,证明块内双向注意力使模型能够反复修正不确定位置的预测,有效抑制误差随预测时域的累积。
技术细节方面,WAM-Diff2基于Qwen3-VL骨干网络构建,所有任务均被序列化至同一Token空间。这种设计确保了架构迁移过程中语义知识的完整传递,避免了因任务分离导致的能力退化。Block-Causal注意力的引入不仅提升了并行度,还增强了模型对上下文信息的理解能力。
实验设计考虑了多种实际应用场景。在不同的去噪步数配置下,模型性能表现出良好的稳定性,为实际部署提供了灵活性。速度与精度Pareto曲线显示,WAM-Diff2在保持高性能的同时实现了显著的效率提升,为自动驾驶系统的实时性要求提供了有力保障。
与其他相关工作相比,WAM-Diff2的独特之处在于其系统性的架构转换方法。不同于从头训练扩散模型的策略,该框架充分利用了现有自回归模型的丰富知识,通过渐进式蒸馏实现平滑过渡。这种方法不仅降低了训练成本,还保证了多任务能力的完整性。
未来发展方向包括进一步优化离散Token化可能引入的空间量化误差,以及探索如何突破自回归教师语义推理水平对扩散学生能力上界的限制。此外,该框架的通用性使其可以直接应用于其他先进的自回归VLA模型,为自动驾驶多模态智能的广泛应用提供了技术基础。
WAM-Diff2的研究成果为自动驾驶领域带来了重要的技术进步。它不仅解决了传统自回归模型的效率和鲁棒性问题,还为多任务学习与并行推理的结合提供了新的思路。随着自动驾驶技术的不断发展,这类创新架构将在推动产业落地方面发挥重要作用。