FireRedTTS3革命性突破:单一模型实现语音克隆设计编辑一体化
语音技术领域迎来重大突破,小红书FireRed团队发布的FireRedTTS3模型成功实现了语音生成与编辑能力的统一整合。这项技术创新不仅在技术层面实现了多项能力的融合,更为语音内容创作带来了前所未有的便利性和可控性。

传统语音合成技术往往需要多个独立系统分别处理不同任务,音色克隆、声音设计和语音编辑通常由不同的模型或模块承担。这种分散式架构不仅增加了系统的复杂性,也在实际应用中造成了诸多不便。FireRedTTS3的出现彻底改变了这一局面,通过单一模型实现了三大核心功能的无缝集成。
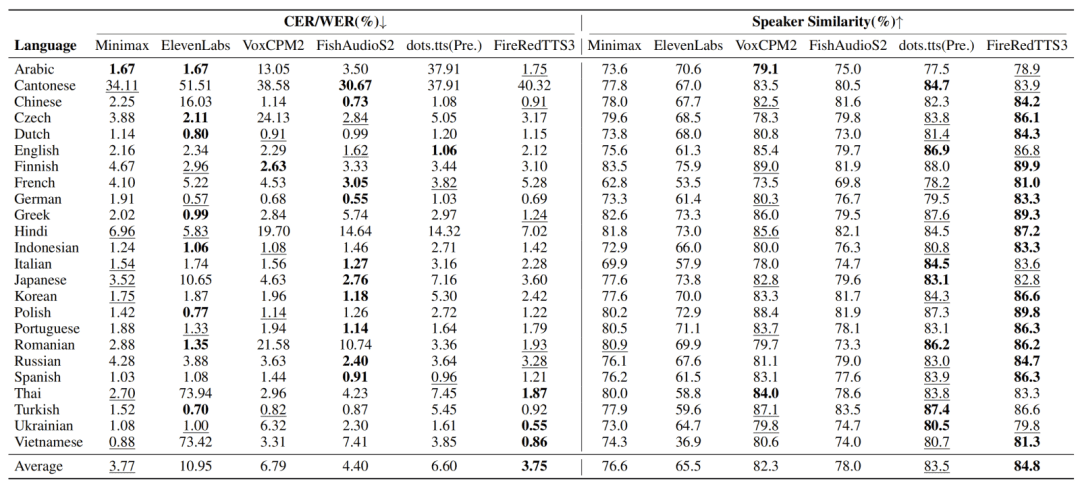
在多语言和多方言支持方面,FireRedTTS3展现出了令人瞩目的能力。模型仅需几秒钟的参考音频,就能够生成24种不同语言和21种中文方言的语音内容。这种跨语言的适应性不仅体现了模型强大的泛化能力,也为全球化应用场景提供了坚实的技术基础。无论是英语、法语、德语等国际主流语言,还是粤语、闽南语、四川话等地方方言,模型都能够准确捕捉并重现其独特的语音特征。
声音设计功能是FireRedTTS3另一大亮点。用户无需提供参考音频,仅通过自然语言描述即可创造出全新的声音特质。这种能力的实现依赖于模型对声音特征的深度理解和精确控制。用户可以描述声音的年龄、性别、情感状态、音色特点等属性,模型会根据这些描述生成相应的语音输出。这种直观的交互方式大大降低了声音创作的技术门槛,让更多非专业人士也能够参与到语音内容的制作中来。
语音编辑功能的精准性同样值得称道。传统的语音编辑往往需要重新生成整个音频片段,而FireRedTTS3能够实现局部精准修改,就像编辑文本一样直接操作语音内容。用户可以指定特定的词汇、语速、音高等参数进行调整,而保持其他部分完全不变。这种精细化的控制能力为语音内容的后期处理提供了极大的灵活性。
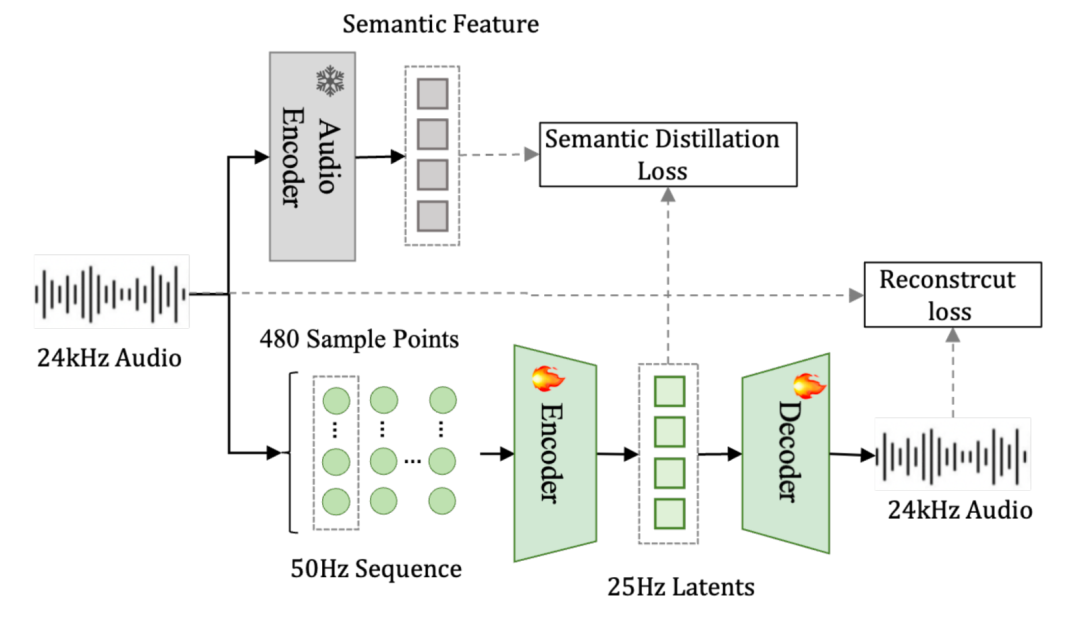
技术架构方面,FireRedTTS3的核心创新在于RedAE语音表示方法。这一方法通过引入语义教师的概念,在tokenizer训练阶段就将语义信息深度融入连续语音表示中。传统的语音表示方法往往面临语义信息缺失或声学细节丢失的问题,而RedAE通过语义蒸馏的方式有效解决了这一矛盾。
语义教师的训练过程采用了多任务学习策略,涵盖自动语音识别、说话人验证等多种语音理解任务。这种综合性的训练方式使得教师模型能够同时掌握内容语义和说话人声学特征,为后续的知识蒸馏奠定了坚实基础。在RedAE训练过程中,冻结的语义教师通过最小化均方误差的方式指导学生模型学习,确保生成的连续表示既保留丰富的声学细节,又具备明确的语义含义。
RedAE的架构设计充分考虑了实用性和效率性。输入的24kHz波形被分割为480采样点的帧序列,形成50Hz的时间分辨率。随后通过两个级联的Transformer模块进行处理,第一个模块负责50Hz上下文建模,第二个模块通过注意力池化机制下采样至25Hz。这种分层处理策略既保证了时间分辨率的合理性,又有效控制了计算复杂度。
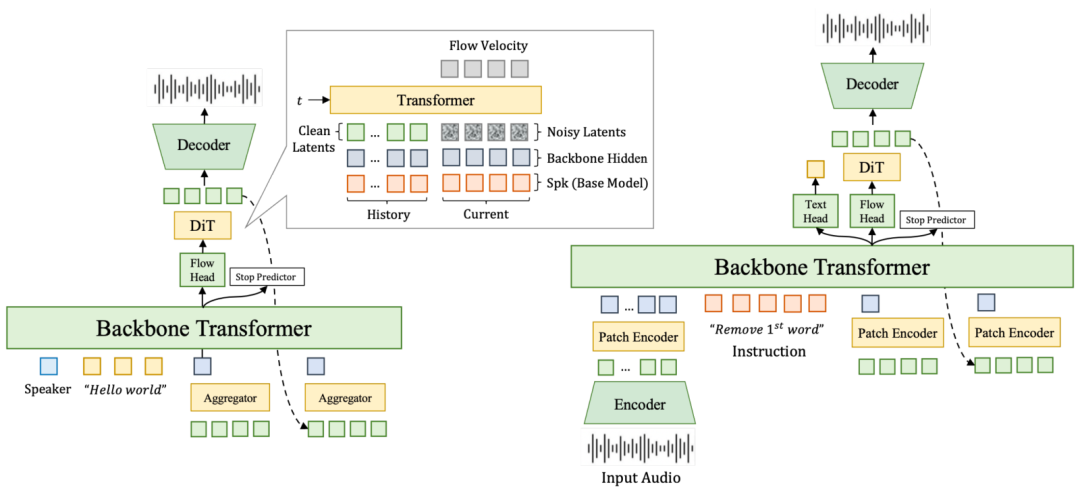
在生成框架方面,FireRedTTS3采用了轻量级的LLM-DiT架构。该架构由聚合器、骨干Transformer和DiT模块三个核心组件构成。聚合器将25Hz的RedAE表示进一步压缩为6.25Hz的潜在patch,显著缩短了序列长度并降低了建模难度。骨干Transformer从Qwen3文本大模型初始化,继承了强大的文本理解和指令跟随能力。DiT模块则负责patch级别的去噪处理,通过历史latent的保留机制维持时间连贯性。
针对不同应用场景,FireRedTTS3提供了两个专门优化的版本。Base版本专注于多语言多方言克隆任务,通过CAM++提取说话人嵌入并结合语言标签指示,实现了跨语言的音色一致性保持。Instruct版本则统一处理克隆、设计和编辑任务,采用ChatML格式并通过结构化文本方案实现精确控制。
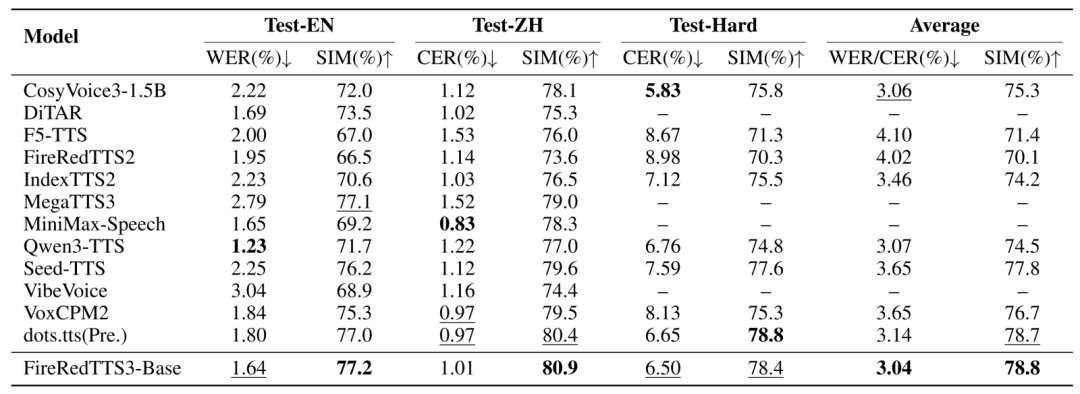
性能测试结果显示,FireRedTTS3在多个权威评测集上取得了显著优势。在Seed-TTS-Eval评测集中,模型在零样本音色克隆任务中实现了3.04%的错误率和78.8%的相似度,两项指标均达到最优水平。在涵盖24种语言的MiniMax-MLS-Test评测中,模型获得了3.75%的平均错误率和84.8%的平均相似度,展现了出色的多语言适应能力。
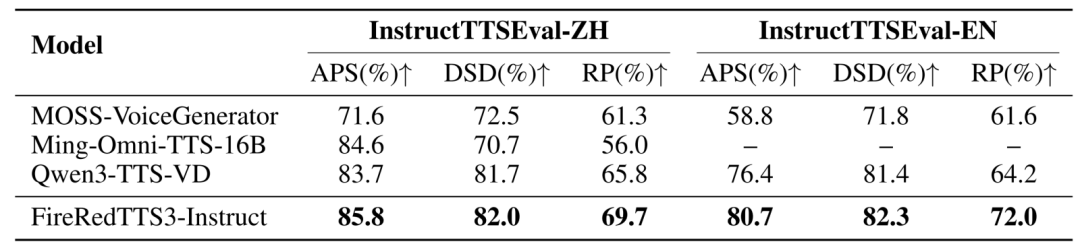
声音设计能力的评估通过InstructTTSEval评测集进行,FireRedTTS3在声学参数指定、风格描述和角色扮演三类任务中均取得最佳成绩。这得益于模型将自然语言指令解析为12维结构化文本方案的设计思路,有效降低了指令歧义并提高了执行精度。
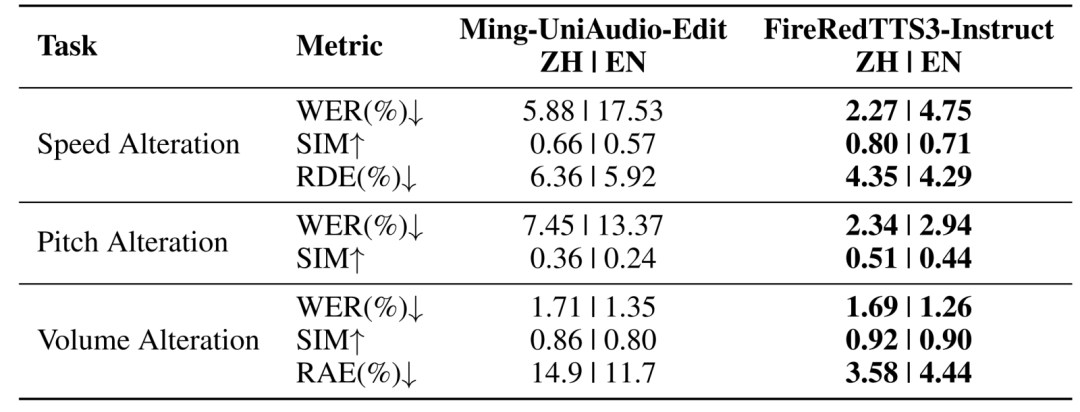
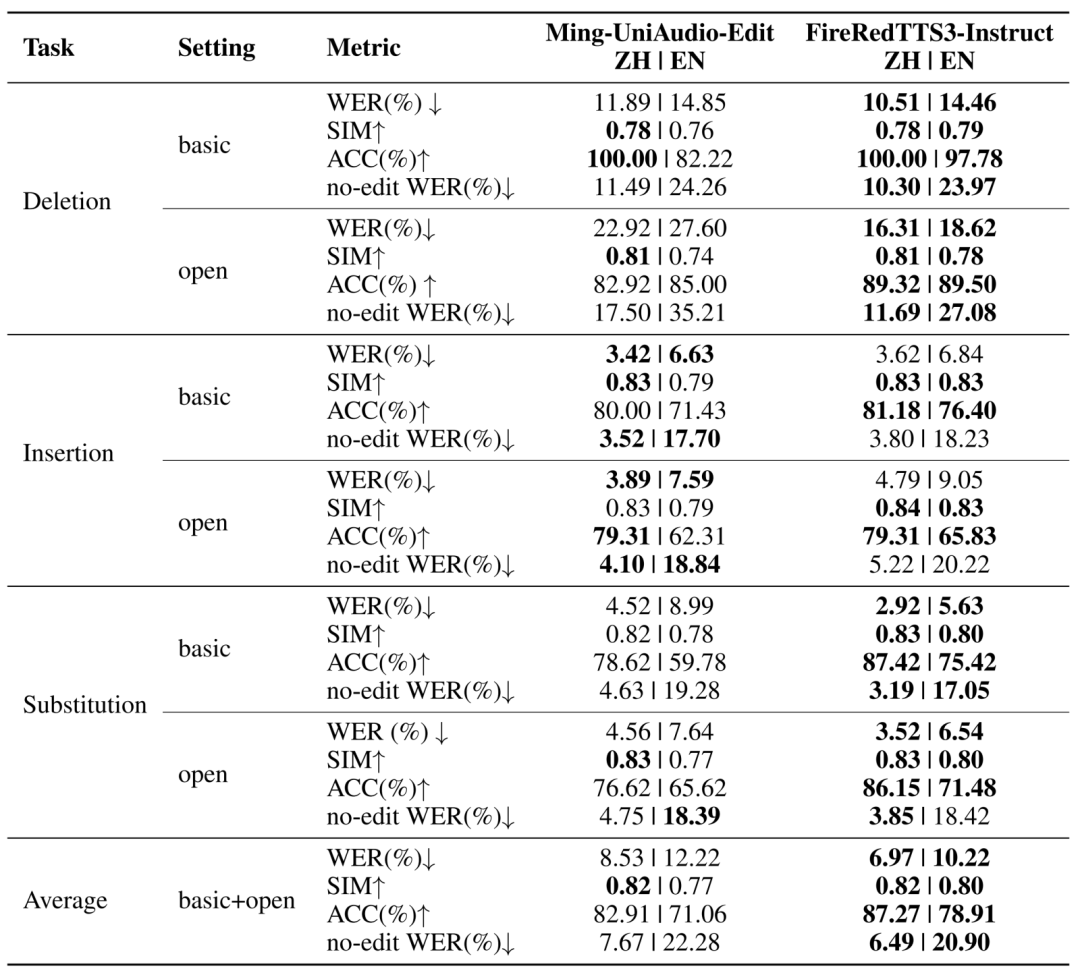
语音编辑性能在Ming-Freeform-Audio-Edit评测集中得到了充分验证。模型在声学编辑和语义编辑两个维度都表现出色,实现了低字错率、高编辑准确率和强说话人相似度的平衡。这种综合性能确保了编辑操作的精确性和音色的稳定性。
技术挑战的解决路径体现了FireRedTTS3的创新思维。传统连续自回归方法面临的误差累积问题通过表示层的优化得到了根本性改善。RedAE通过语义教师的早期介入,使稳定性成为表示的固有属性,从而避免了后期复杂补偿机制的需要。
训练数据的规模和多样性为模型性能提供了重要保障。RedAE训练使用了50万小时的多样化音频数据,包括干净语音、带噪语音、音效和音乐等不同类型。这种丰富的训练数据确保了模型在各种实际场景下的鲁棒性。
应用场景的拓展潜力巨大。FireRedTTS3不仅适用于传统的语音助手、有声读物等应用,还能支持更复杂的语音内容创作、个性化语音服务、多语言教育工具等新兴领域。模型的指令跟随能力使其特别适合需要高度定制化语音输出的应用场景。
技术发展趋势方面,FireRedTTS3代表了语音生成技术从功能导向向体验导向的重要转变。传统的语音合成更多关注基本功能的实现,而现代技术更加注重用户体验和创作自由度。这种转变反映了人工智能技术从工具属性向平台属性的发展趋势。
未来发展方向包括语种和方言的进一步扩展、指令控制精度的提升、编辑功能边界的拓展等。随着技术的不断完善,语音将成为一种更加灵活和个性化的表达媒介,为用户提供前所未有的创作可能性。
产业影响方面,FireRedTTS3的出现将推动语音内容创作生态的变革。个人用户和小型创作者将能够以较低的技术门槛参与到高质量语音内容的制作中来,这将极大地丰富语音内容的多样性和创新性。同时,企业级应用也将受益于这种统一而高效的语音处理能力。
技术标准化的推进将是下一个重要议题。随着FireRedTTS3等先进模型的出现,行业需要建立相应的技术标准和评估体系,以确保不同系统间的兼容性和互操作性。这将有助于构建更加健康和可持续的语音技术生态系统。
安全性和伦理考量也不容忽视。强大的语音生成和编辑能力可能被滥用于虚假信息传播或其他不当用途,因此需要建立相应的技术防护措施和监管机制。这包括语音真实性检测技术的发展、使用规范的制定以及相关法律法规的完善。
FireRedTTS3的成功不仅体现在技术指标的优越性上,更重要的是它为语音技术的未来发展指明了方向。通过将复杂的功能整合到统一的框架中,模型展示了人工智能技术在简化复杂性、提升可用性方面的巨大潜力。这种理念将在未来的AI系统设计中发挥越来越重要的作用。