Claude如何重塑蛋白质设计与实验分析:AI驱动科研流程的两端突破
近年来,人工智能在生命科学领域的渗透已从单一任务辅助逐步迈向全流程参与。Anthropic团队近期公布的研究成果,展示了其大语言模型Claude在蛋白质设计与实验数据分析两个关键环节的突破性能力。这项工作不仅刷新了AI在生物医药研发中的角色定位,更揭示了一种新型科研范式的雏形——由AI协调多工具、整合多模态信息,并自主完成从假设生成到实验验证的闭环。
传统蛋白质工程是一项高度碎片化的劳动密集型工作。研究人员需在文献调研、结构预测、序列生成、界面优化、稳定性评估等多个环节间反复切换,依赖不同软件工具和实验平台。每个步骤都嵌入了大量隐性专业知识,任何一环的失误都可能导致数周甚至数月的努力付诸东流。这种“判断成本”往往比计算资源本身更为昂贵。而Claude的介入,正是试图将这些分散的决策节点整合为一个连贯的智能流程。
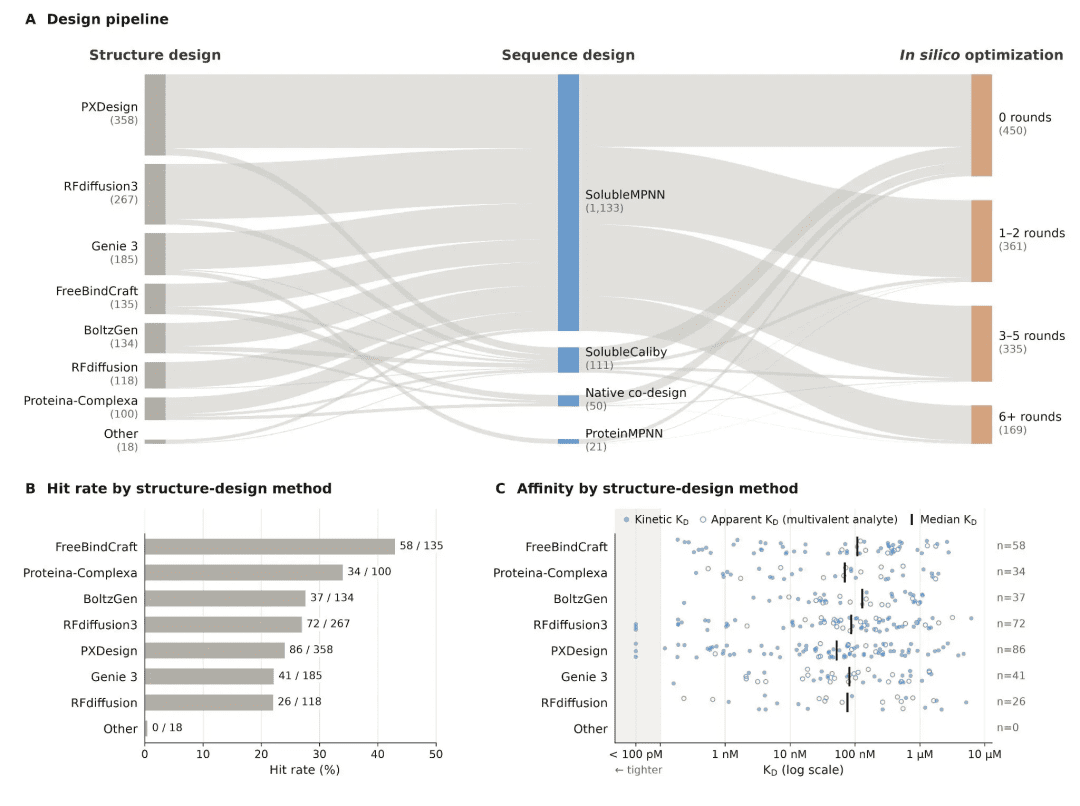
研究团队聚焦于Minibinder的设计——这类小型结合蛋白是现代药物开发的核心构件,能够特异性地识别并结合目标蛋白,从而实现抑制、激活或递送功能。过去,从头设计一个有效的Minibinder通常需要蛋白质工程师针对单一靶点投入数月时间。尽管近年来AlphaFold、RFdiffusion等模型显著加速了结构预测与序列生成,但工具间的衔接仍需专家手动编排,且最终实验验证周期漫长。
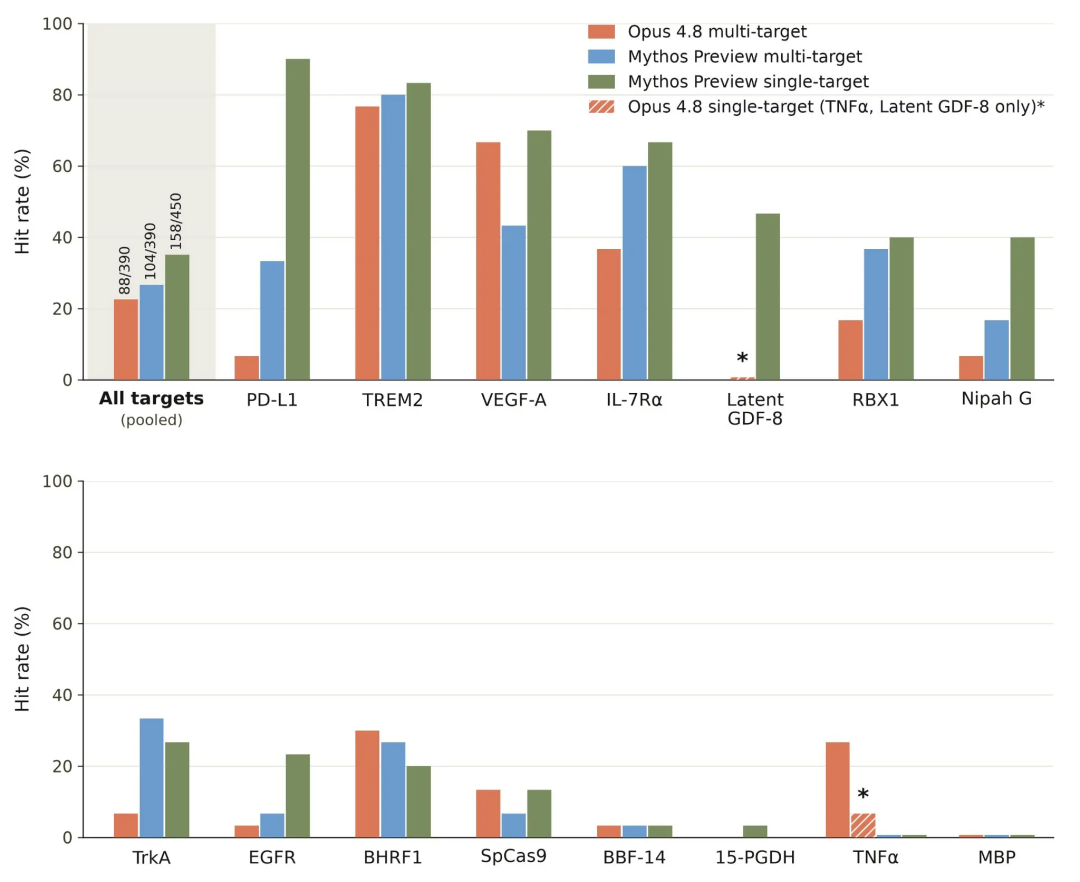
Anthropic此次采用Mythos Preview与Opus 4.8两个模型版本,在15个不同靶点上进行了并行测试。结果显示,在48小时内同时处理全部靶点的任务中,Mythos Preview的整体命中率达到26.7%,Opus 4.8为22.6%。作为对比,当前行业典型的蛋白质设计活动命中率仅为10%–15%。更值得注意的是,当Claude被允许一次专注一个靶点时,Mythos Preview的命中率进一步提升至35.1%。这一数据表明,AI不仅能够执行设计任务,还能根据任务复杂度动态调整策略优先级。
具体案例进一步印证了其潜力。以RBX1为例,这是一个参与泛素-蛋白酶体系统调控的关键蛋白,此前Adaptyv Bio举办的公开竞赛中,全球245个参赛设计仅有9个被实验证实有效,命中率仅3.7%。而Claude在本次实验中生成90个设计,其中28个成功结合,命中率达31%。尤为突出的是,其最优设计的结合亲和力约为竞赛冠军的10倍。这一结果并非偶然优化,而是源于Claude对结合界面几何、静电互补性及疏水相互作用的综合建模能力。
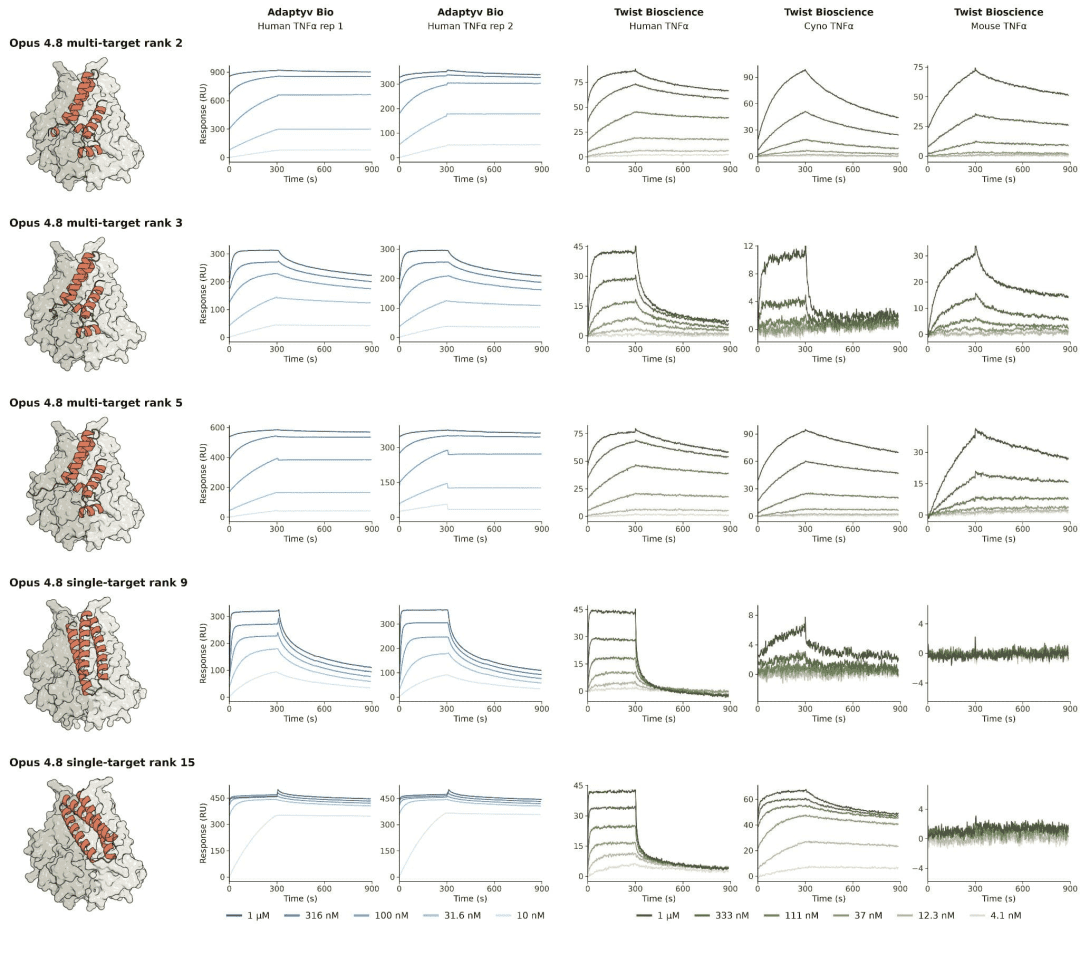
另一个更具挑战性的靶点是TNFα(肿瘤坏死因子α),一种经典的炎症治疗靶标。其三聚体结构和浅表结合口袋使得从头设计高亲和力结合剂极为困难。在此任务中,Mythos Preview未能产出有效结果,但Opus 4.8成功筛选出12个经实验验证的binder。更令人惊喜的是,部分设计展现出跨物种结合能力——能同时识别人、食蟹猴和小鼠的TNFα。这种特性在药物开发中具有重要价值:通常候选分子需针对不同实验动物重新设计适配版本,而跨物种结合剂可直接用于临床前研究,显著缩短研发路径。
当然,AI并非万能。在MBP(麦芽糖结合蛋白)靶点上,Claude测试的90个设计无一成功。这一失败恰恰说明当前方法仍受限于靶标本身的物理化学特性,如柔性区域过多、结合界面模糊或能量景观过于平坦。这也提醒我们,AI的能力边界仍由底层生物物理规律所定义,而非算法本身。
如果说蛋白质设计代表了科研流程的“上游”——即假设生成与方案制定,那么实验数据分析则处于“下游”——即结果解读与验证。Anthropic并未止步于设计端,而是进一步测试了Claude在分析化学领域的自主能力。
在第二组实验中,研究人员向Claude Opus 5提供了两份未经处理的原始仪器数据:一份来自¹H NMR(质子核磁共振),另一份来自LC-MS(液相色谱—质谱)。任务指令仅包含两句话,未提供任何预处理脚本或分析模板。这两类数据在化学实验室中极为常见,但解析过程高度依赖经验:需识别信号峰、积分面积、推断分子结构、评估纯度,并判断是否符合预期产物。
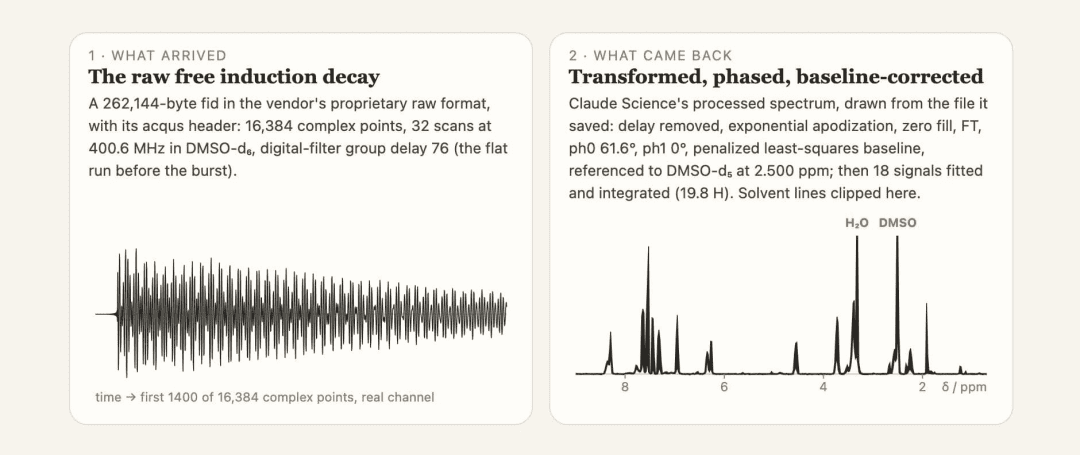
面对NMR数据,Claude在23分钟内完成了全流程分析。它首先将原始时域信号转换为频域谱图,随后自动识别主要化学位移峰,并进行积分计算。其结果与实验室人工分析高度一致。更进一步,Claude主动建议进行重水(D₂O)交换实验以确认可交换质子(如-OH、-NH),这是专业化学家常用的验证手段。此外,它还通过量化信号强度变化,发现并纠正了初始读数中对某峰面积的夸大估计,展现出对数据异常的敏感性。
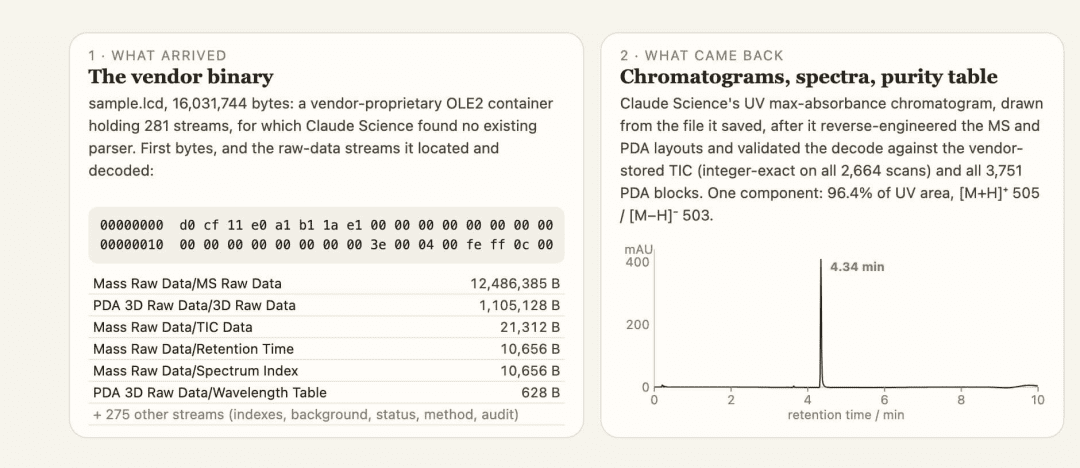
LC-MS任务更具挑战性。原始数据以供应商专有格式存储,缺乏公开的解析规范。Claude通过逆向推断文件结构,成功还原了仪器记录的2664次扫描数据,并据此重建色谱图与质谱图。随后,它准确识别了目标化合物的分子离子峰,估算分子量,并评估样品纯度。整个过程在19分钟内完成,且无需人类干预。
这两项实验共同勾勒出AI在科研中的新角色:不再是被动响应查询的工具,而是能主动规划、执行并反思的智能体。它既能从生物学问题出发,调用多个计算模型生成候选方案;也能从原始实验数据出发,逆向推导化学结论。这种“双向贯通”的能力,正是构建端到端科研自动化的关键。
值得强调的是,Claude的成功并非源于单一模型的超强性能,而在于其对多工具生态的协调能力。在蛋白质设计中,它整合了结构预测、序列生成、能量评分等多个开源模型;在数据分析中,它模拟了专业软件的数据处理逻辑。这种“AI as orchestrator”的范式,可能比追求单一模型全能更具现实意义。
展望未来,若将此类系统与自动化实验平台(如液体处理机器人、高通量筛选系统)结合,有望形成“设计—合成—测试—学习”的闭环。每一次实验反馈都可用来微调AI的判断标准,从而在迭代中不断提升成功率。Anthropic团队也指出,引入蛋白专家的指导与结果反馈将进一步优化性能,这暗示了人机协同仍是近期最可行的路径。
然而,挑战依然存在。当前系统对失败案例的归因能力有限,难以解释为何某些设计无效;跨靶点泛化能力也有待验证;更重要的是,实验验证仍是瓶颈——AI可以生成数百个候选,但湿实验通量决定了最终落地速度。因此,真正的突破不仅在于算法,还需实验技术的同步革新。
无论如何,Claude在蛋白质设计与分析化学两端的突破,标志着AI正从“辅助者”向“协作者”乃至“主导者”演进。它不再只是加速某个环节,而是重构整个科研工作流。对于药物研发这一高成本、长周期的领域而言,这种变革或许将带来前所未有的效率跃升。