世界模型评测新范式:用Agent Player实现长程目标驱动的公平评估
在人工智能迈向具身智能与虚拟世界构建的关键阶段,世界模型(World Models)作为模拟环境动态的核心组件,其能力边界亟需被科学、公平地衡量。然而,现有评测方法普遍存在一个根本性缺陷:过度依赖预设的固定动作序列。这种做法看似标准化,实则忽略了真实用户与虚拟世界互动的本质——人们关心的是“是否完成了绕雕塑一圈并确认其形状未变”,而非“是否精确执行了三次右转”。正是这一认知偏差,导致当前评测结果难以真实反映模型在复杂、开放环境中的实际表现。

针对这一问题,来自香港大学、香港中文大学、浙江大学及快手可灵团队的研究者提出了 PlayWorld ——一种以长期目标为导向、由智能体驱动的世界模型评测新范式。该框架不再将“按键序列”作为评测单位,而是将“完成特定场景下的长程任务”作为核心标准,通过引入具备感知与决策能力的 Agent Player,实现对模型能力的闭环、动态评估。
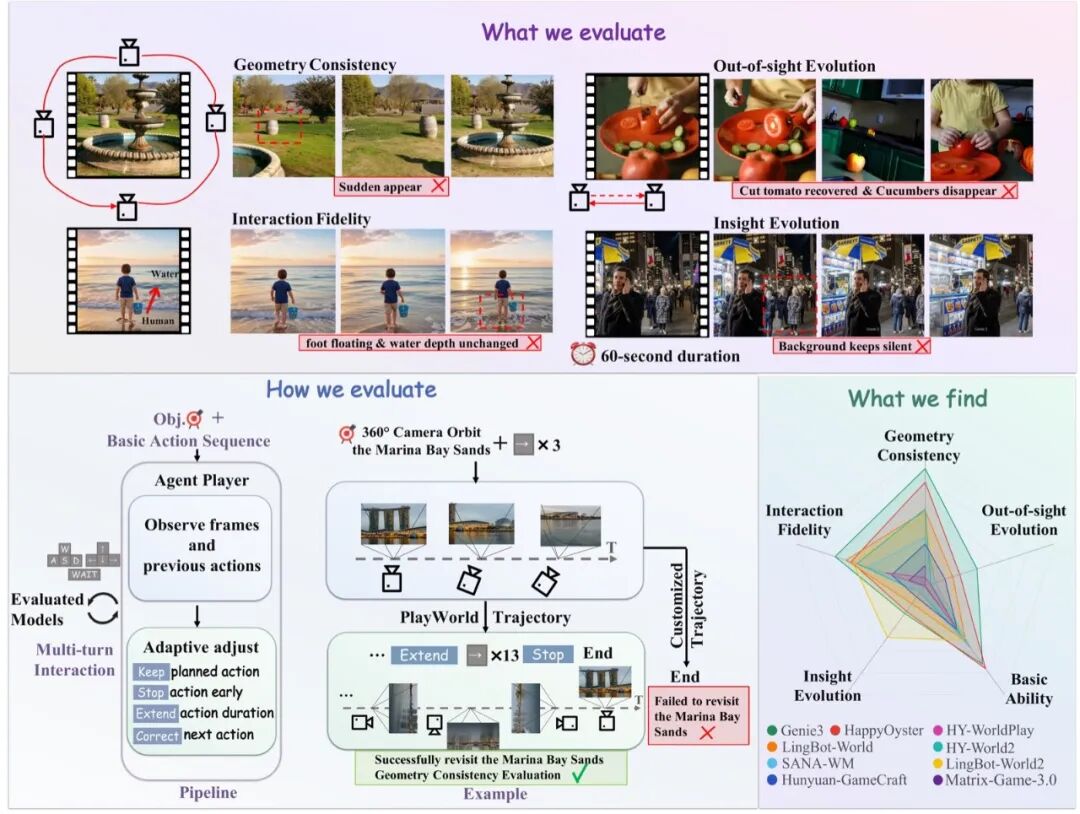
从固定轨迹到目标导向:评测逻辑的根本转变
传统评测中,所有模型接收完全相同的动作指令(如WASD序列),然后对比生成视频的视觉质量或局部一致性。这种方法的问题在于:动作相同 ≠ 状态相同。例如,在“围绕中心雕塑转一圈”的任务中,若某模型因内部动力学偏差未能真正完成360°环绕,仅停留在270°视角,那么后续对其“雕塑是否变形”的判断就失去了意义——因为比较的并非同一空间状态。
PlayWorld 的核心思想是:让评测过程本身具备适应性。给定初始场景和长期目标(如“进入厨房,观察正在煮汤的人是否加了盐”),Agent Player 会根据实时生成的视频帧动态调整操作策略。它不预设完整轨迹,而是在共享先验动作序列的基础上,依据视觉反馈进行在线修正。这种设计既保留了基础可比性,又允许不同模型因其控制粒度或响应特性而采取差异化路径,从而更真实地模拟人类试玩行为。
Agent Player:会看、会调、会停的智能评测者
Agent Player 并非简单脚本机器人,而是一个由多模态大模型驱动的决策系统。其输入包括:当前生成帧、已执行动作历史、场景文本描述及长期目标。基于这些信息,它在每一步从五种决策中选择其一:
- Keep:继续当前动作或进入下一计划步骤;
- Stop:目标视觉状态已出现,提前终止当前动作;
- Extend:运动不足,延长当前动作时长;
- Correct:状态偏离预期,修正下一步动作;
- End:目标达成且观察完成,结束评测。
例如,在“走入水中观察水花”任务中,若模型生成的水面无任何涟漪,Agent Player 可能选择 Extend 以确认是否延迟响应;若人物已完全入水但水面仍无变化,则可能直接 End 并记录交互失败。这种动态决策机制使得评测不再是机械执行,而是基于语义理解的主动探索。
此外,接口转换器模块将统一的WASD动作映射为各模型所需的输入格式(如离散token、连续向量等),确保评测兼容性。研究者刻意避免让Agent从零规划整条轨迹,而是基于预设的“基础动作骨架”进行微调,既降低计算开销,又维持跨模型比较的公平性。
四维评估体系:超越“看起来不错”的深层检验
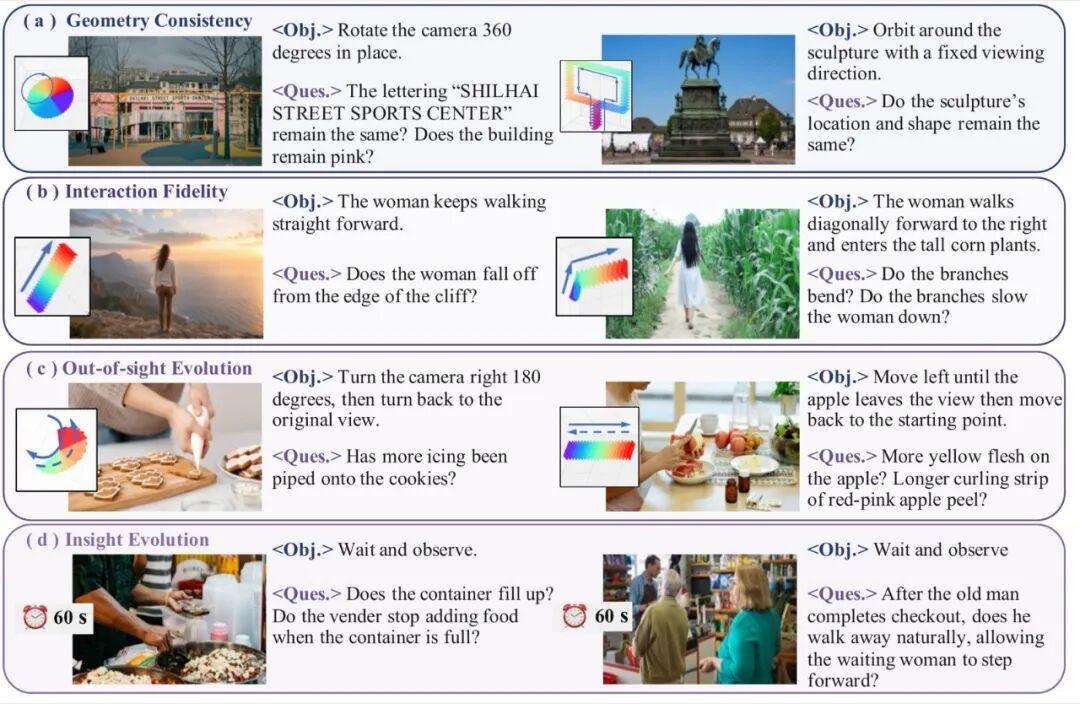
PlayWorld 构建了覆盖世界模型核心能力的四大评估维度,每个维度均通过人工设计的VQA(视觉问答)问题进行量化打分:
几何一致性(Geometry Consistency)
该维度检验模型在视角变换与重访过程中的空间稳定性。例如,当摄像机围绕泰姬陵完成360°旋转后,建筑的纹理、文字、相对位置是否保持一致?实验发现,许多模型虽单帧逼真,但在完整轨迹中会重复生成多个“新泰姬陵”,破坏空间唯一性。PlayWorld 特别筛选包含文字、壁画、标志性结构的场景,因其身份极易被篡改而不易察觉。
交互保真度(Interaction Fidelity)
用户动作是否引发符合物理规律的反馈?测试涵盖人与水、火、悬崖、障碍物等的交互。典型案例如:走入浅水区应激起水花,深入则水位上升;撞墙应停止而非穿模;踩踏草地应有形变反馈。当前模型常在此类动态响应上失效,表现出“视觉合理但物理错误”的割裂现象。
视野外演化(Out-of-sight Evolution)
当目标暂时离开画面,世界是否仍在按因果逻辑运行?例如,一个人在削苹果,镜头转向别处10秒后再回看,苹果应变得更小、果皮更长。若其状态重置或停滞,则说明模型缺乏跨遮挡的状态记忆。PlayWorld 设计了绘画、烹饪、火箭发射等需持续演化的任务,专门检验模型的“后台进程”能力。
视野内演化(In-sight Evolution)
在长达60秒的连续观察中,可见过程是否真实推进?如夜市行人是否自然流动、收银台顾客结账后是否离开、爆竹爆炸后人群是否惊散。许多模型在此维度表现为“循环动画”或“冻结状态”,暴露出其对长时间动态建模的无力。
整个测试集包含171个精心筛选的样本,覆盖820余个VQA问题,确保评估的细粒度与针对性。
实验揭示:当前世界模型的三大能力瓶颈
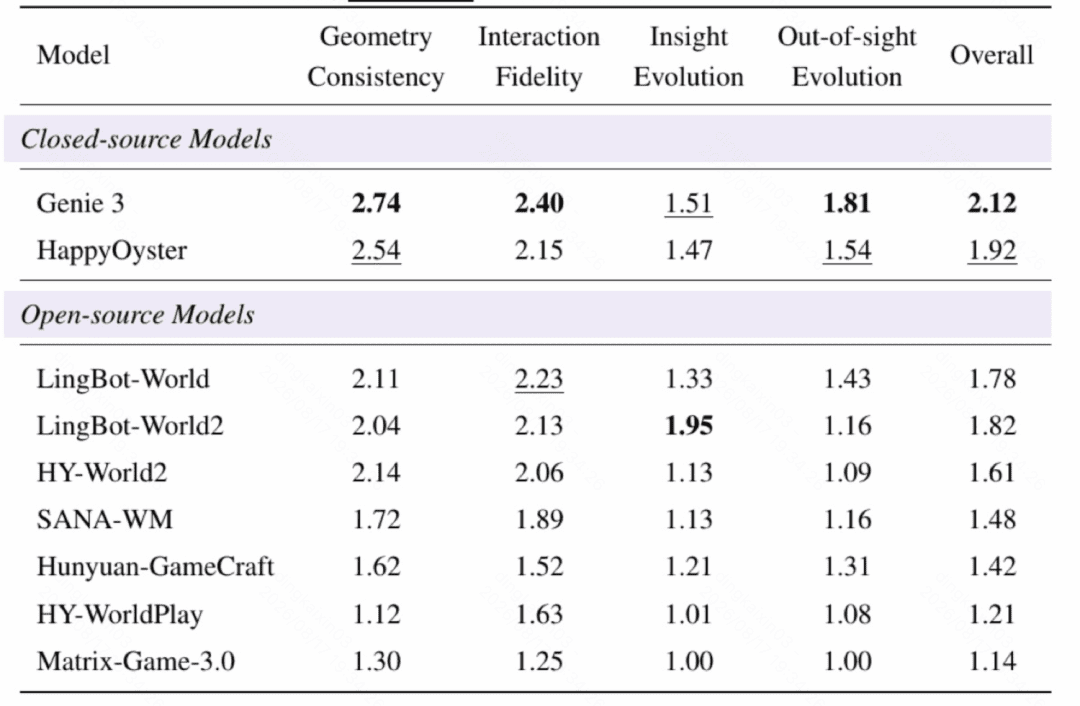
通过对多个SOTA世界模型(包括SANA-WM等)的系统评测,PlayWorld 揭示了当前技术的显著局限:
第一,持续演化能力严重不足。几乎所有模型在视野内外演化维度得分偏低。一个正在进行的过程(如倒水、写字)常陷入静止、循环或突变,表明模型缺乏对跨时间语义状态的维护机制。它们擅长生成“瞬间合理”的画面,却无法支撑“过程可信”的世界。
第二,全局空间一致性脆弱。单帧质量高不等于三维世界成立。在环绕地标任务中,模型频繁出现“多实例生成”问题——不同视角看到的是不同版本的同一物体。这种空间碎片化使得虚拟世界无法被可靠导航或记忆。
第三,轨迹成功≠世界理解。以SANA-WM为例,其轨迹验证通过率达80.4%,意味着多数情况下能“走到目标位置”;但四项rubric综合得分仅1.48(满分5)。这说明模型可能通过表面拟合完成路径跟踪,却未真正建立对物体身份、物理规则或因果链的理解。
这些发现共同指向一个结论:当前世界模型仍处于“外观优先”的初级阶段,距离构建稳定、连贯、可交互的虚拟世界仍有巨大差距。
开源与影响:推动评测范式升级
PlayWorld 不仅是一种方法论创新,更提供了可复现的基础设施。研究团队已开源评测数据集(含171个场景)、VQA问题集、Agent Player代码及模型适配接口。项目主页与Hugging Face仓库为社区提供了即用型工具,有望成为世界模型领域的标准评测基准。
更重要的是,PlayWorld 将评测视角从“模型能否执行指令”转向“用户能否信任这个世界”。在AI生成内容日益渗透游戏、仿真、元宇宙等场景的今天,这种以用户体验为中心的评估逻辑,或许才是衡量世界模型真正成熟度的关键标尺。
未来,随着Agent Player能力的增强(如引入强化学习、记忆机制),评测任务可进一步扩展至多目标协同、长期记忆验证等更复杂场景。而PlayWorld所揭示的能力缺口,也将为下一代世界模型的研发指明方向:不仅要生成好看的视频,更要构建一个在时间、空间与因果上自洽的世界。