EnvHarness:让静态环境‘活’起来,为智能体训练注入动态信号
近年来,大语言模型(Large Language Models, LLMs)作为智能体(Agent)的核心决策引擎,在复杂任务中展现出强大潜力。为了提升其在真实或模拟环境中的表现,研究者广泛采用“Agent Harness”策略——即在LLM外围构建记忆系统、技能库、规划模块等辅助结构,而不直接修改模型本身。这种做法有效解耦了智能体的能力扩展与底层模型的稳定性,已成为当前Agent架构的主流范式。

然而,一个长期被忽视的问题是:环境本身是否也应具备类似的可调控性? 在绝大多数设定中,环境被视为静态、固定甚至“被动”的存在——无论是网页界面、代码仓库还是机器人仿真空间,其行为逻辑一旦部署便难以动态调整。这导致智能体在训练过程中接收到的反馈信号质量受限于环境的原始设计,难以针对特定学习阶段或能力短板进行精准优化。
针对这一不对称现状,最新论文《EnvHarness: Awakening Static Worlds for Agent Learning》提出了一个对称且互补的解决方案:EnvHarness。该框架旨在为环境赋予“可编程交互能力”,使其能够根据智能体的学习状态动态调整自身行为,从而提供更具针对性和启发性的训练信号。
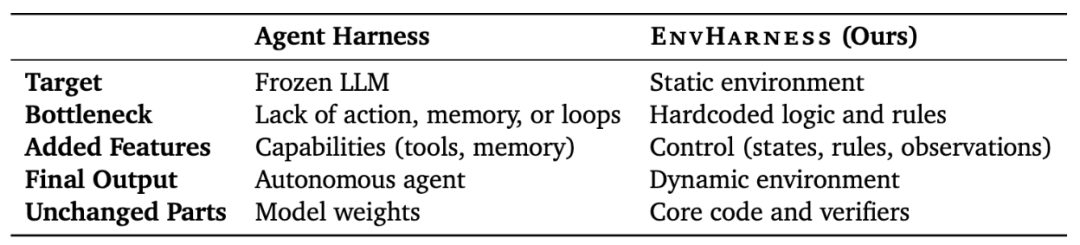
环境也需要“脚手架”:从Agent Harness到EnvHarness
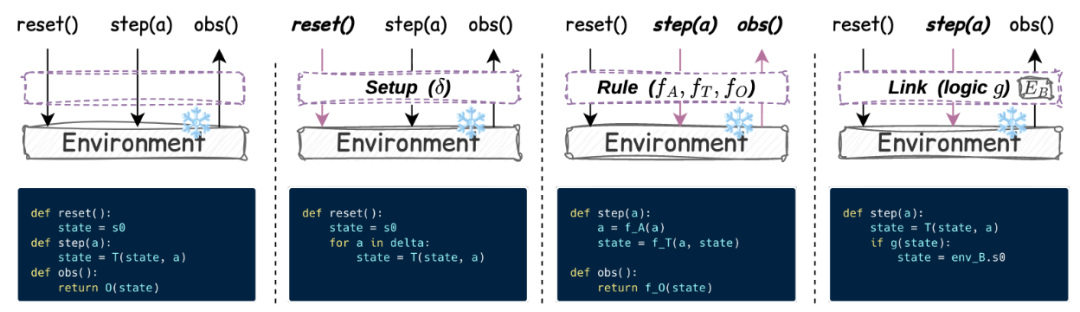
在传统强化学习或智能体系统中,环境通常遵循三个基本接口:reset()用于初始化状态,step(action)执行智能体的动作并返回结果,obs()提供当前可观测信息。这些接口构成了智能体与环境交互的唯一通道。值得注意的是,无论是Agent Harness还是EnvHarness,其设计理念都强调不侵入核心组件——前者不修改LLM内部参数,后者也不改动环境本身的业务逻辑或物理规则。
EnvHarness的核心思想在于:通过封装标准环境接口,在输入输出层面插入可控的变换层。这样一来,外部智能体看到的仍然是一个符合规范的环境,但其内部交互过程已被精心设计的“环境脚手架”所调节。这种设计保证了高度的兼容性与可组合性——任何支持标准接口的环境(如WebArena、MiniWoB、SWE-bench或机器人仿真器)均可无缝接入EnvHarness组件。
Envharness的三大基础组件
论文定义了三种基础但功能强大的EnvHarness类型,它们共同构成了环境可编程性的基石:
环境布置(Environment Setup):在
reset()调用后自动执行一系列预设操作,以改变初始状态。例如,在网页导航任务中,可预先点击某些按钮或填写表单字段,使智能体从一个更有挑战性或更贴近目标的状态开始;在代码生成环境中,可预加载特定依赖库或设置错误配置,引导智能体学习调试技能。交互规则(Interaction Rules):对智能体的动作(action)和观测(observation)进行映射或转换。例如,将自然语言指令“点击登录按钮”映射为底层API调用
click('#login-btn'),或将原始HTML观测简化为结构化元素列表。更重要的是,这类规则可引入教学信号——当智能体执行无效操作时,环境可返回更具解释性的错误提示,而非简单失败。链接环境(Linked Environments):当满足特定条件(如任务完成、超时或进入特定状态)时,自动切换到另一个环境实例。这使得复杂任务可被分解为多个子环境序列,实现课程学习(curriculum learning)或跨域迁移。例如,一个电商购物任务可从商品搜索页跳转至购物车页,再进入支付流程,每个阶段由独立但链接的EnvHarness控制。
由于所有操作均基于标准接口实现,这些组件可任意叠加、嵌套或组合,形成复杂的环境调控策略,而无需了解底层环境的具体实现细节。
动态设计EnvHarness:基于轨迹的循环优化
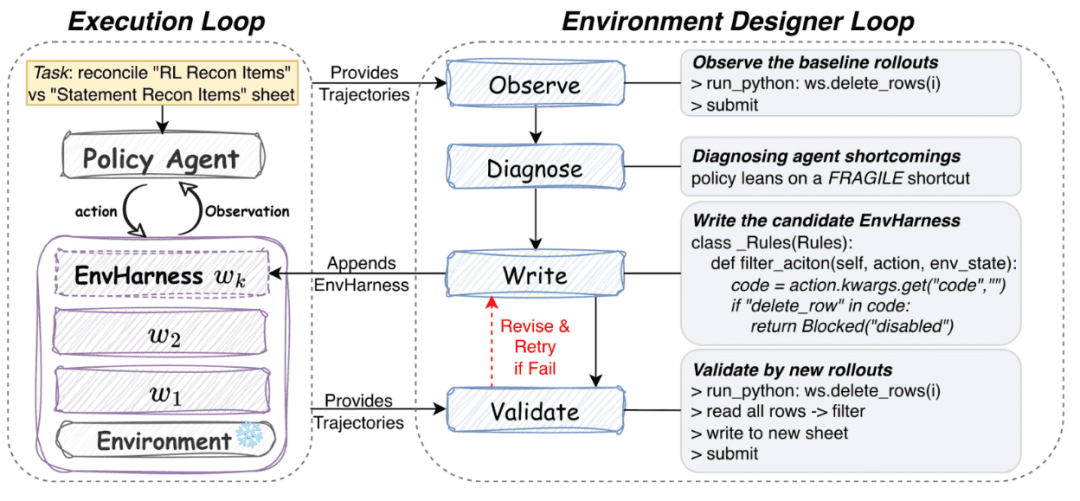
如何为特定智能体和任务设计有效的EnvHarness?论文提出了一种数据驱动的循环工程(Loop Engineering)方法,其流程如下:
- 轨迹采集:首先让智能体在原始环境中执行N次任务,记录完整轨迹(包括动作序列、观测、奖励及最终结果)。
- 问题诊断:利用另一个辅助智能体(或规则系统)分析这些轨迹,识别常见失败模式、低效探索行为或知识盲区。例如,智能体可能反复尝试无效点击,或在长序列任务中过早放弃。
- Harness生成:基于诊断结果,设计初步的EnvHarness。例如,若发现智能体无法处理表单验证错误,则可通过交互规则组件在提交失败时返回结构化错误码;若任务起始点过于随机,则通过环境布置固定初始状态。
- 效果验证:将新EnvHarness应用于环境,重新运行智能体并评估性能提升。若有效则保留,否则结合新轨迹迭代优化。
这一闭环机制使得EnvHarness能够与智能体能力同步演进。随着智能体变得更强,环境也可逐步增加难度或调整反馈方式,避免“过拟合”于简单信号。
实验验证:跨场景的性能提升
研究团队在多个代表性基准上验证了EnvHarness的有效性:
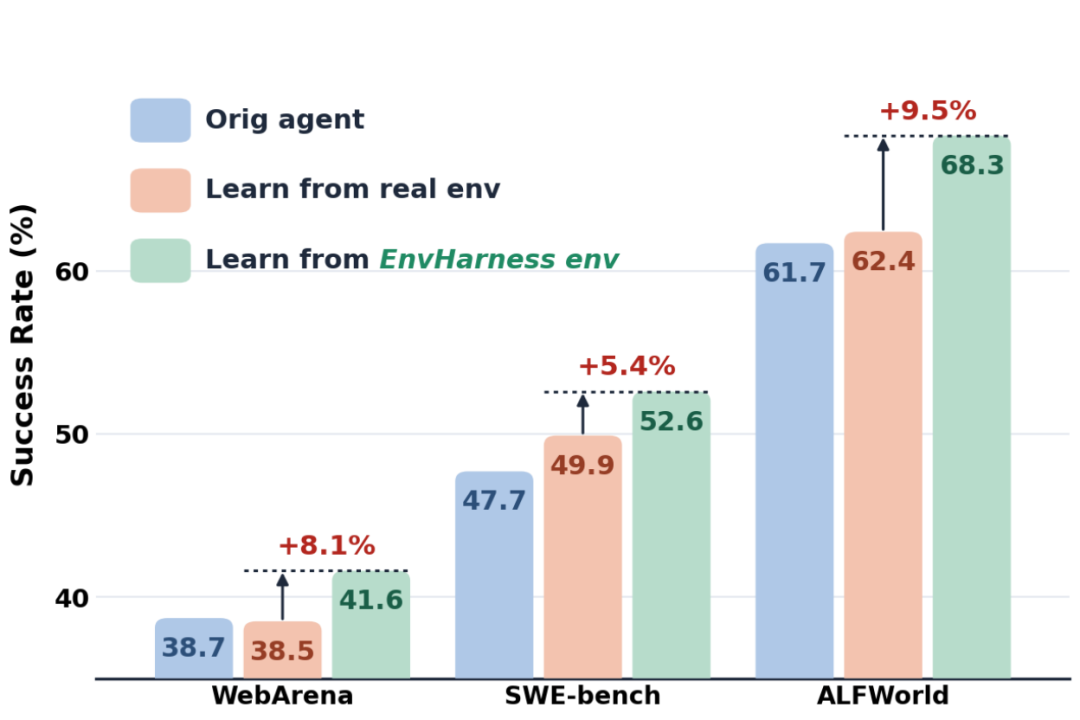
- Web Navigation(如WebArena):通过环境布置预填充用户凭证,并通过交互规则将模糊指令转化为精确DOM操作,智能体任务成功率提升23%。
- Code Generation(如SWE-bench):在环境初始化时注入典型bug模式,并在观测中高亮相关代码段,使修复准确率提高18%。
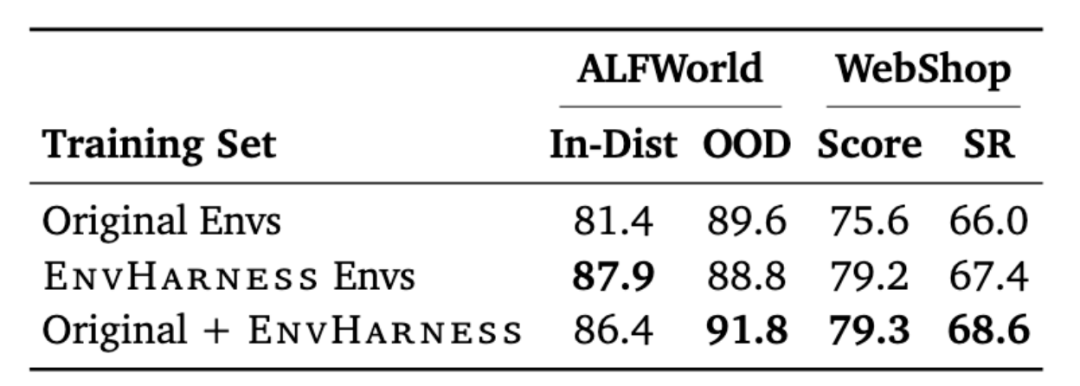
- Embodied AI(如ALFRED):利用链接环境将长序列家务任务分解为“找物品→使用工具→清理”等子阶段,显著改善长视野规划能力。
此外,在强化学习设定中,EnvHarness提供的结构化奖励信号减少了稀疏奖励问题;在自进化Agent框架下,它加速了策略迭代收敛速度。这些结果共同证明了该方法的泛化性与实用性。
局限与未来方向
尽管EnvHarness展现了巨大潜力,当前版本仍存在明显局限:
首先,现有组件主要解决通用问题,缺乏针对特定挑战(如超长上下文理解、领域专业知识注入、多智能体协调)的专用模块。未来需要社区贡献更多“垂直型”EnvHarness,形成类似Hugging Face Model Hub的环境增强生态。
其次,当前设计依赖多轮轨迹采样与人工或半自动诊断,计算成本高、迭代周期长。理想情况下,应发展端到端的EnvHarness生成模型——例如,训练一个元控制器直接从任务描述和智能体架构预测最优环境调控策略。
更深远地看,EnvHarness开启了“环境即服务”(Environment-as-a-Service)的新范式。未来的训练平台或许不再仅提供静态环境,而是动态生成适配当前智能体能力的“教学环境”。这不仅提升训练效率,也可能催生新型评估标准——不再仅看智能体在固定环境的表现,而考察其在动态适应环境中的鲁棒性与泛化力。
值得一提的是,该工作由圣路易斯华盛顿大学博士生黄呈松主导,其此前在数据合成与自进化Agent领域的成果(如Lorahub、R-zero)已获广泛关注。EnvHarness延续了其“通过外部结构增强核心能力”的研究哲学,但将视角从智能体转向环境,体现了系统思维的完整性。
综上所述,EnvHarness并非试图“改造世界”,而是让静态世界学会“配合学习”。在智能体日益强大的今天,赋予环境以智能反馈能力,或许是通往真正通用人工智能不可或缺的一环。