原方智能启动:世界模型如何构建机器的‘信念’?
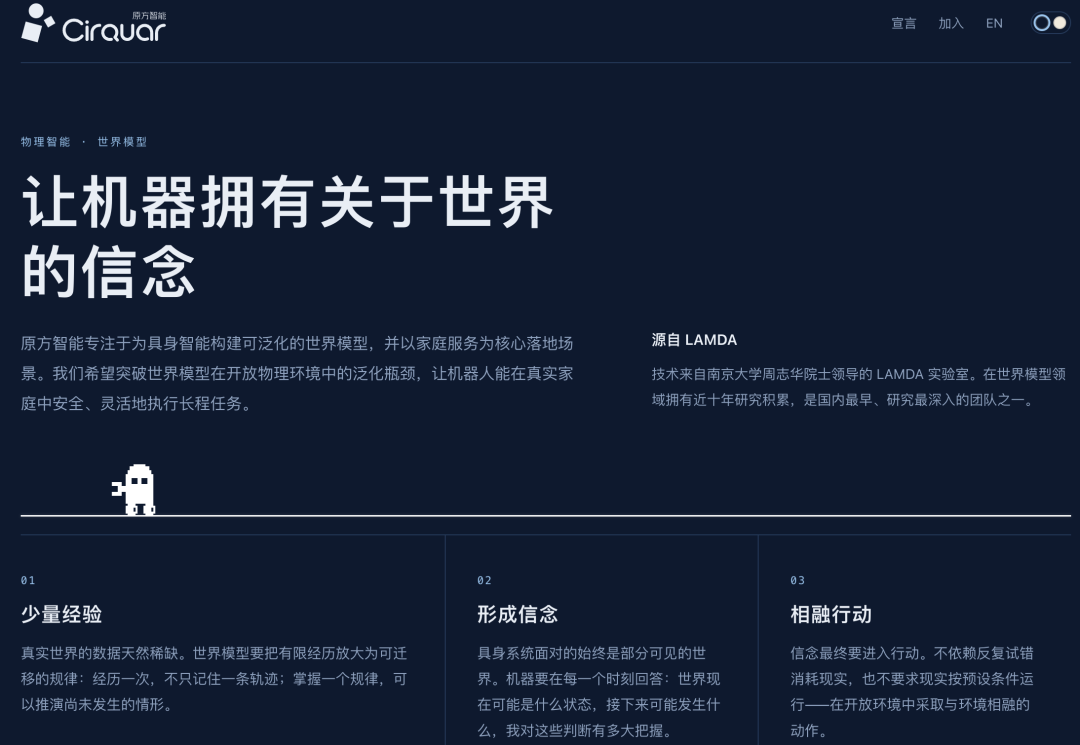
在人工智能迈向物理世界的关键阶段,一家名为原方智能(Cirquar AI)的新锐公司悄然登场,却带来了极具前瞻性的技术宣言——《让机器拥有关于世界的信念》。这一看似哲学化的表述,实则指向一个高度工程化且理论扎实的技术路径:以世界模型(World Model)为核心,构建能在复杂、动态、部分可观测的真实环境中持续推理、决策并进化的智能系统。
原方智能由南京大学LAMDA实验室博士生林浩鑫与机器人学院助理研究员唐开强共同创立。两人不仅具备深厚的学术背景,更拥有丰富的机器人工程实践经验。这种“学术+产业”的双重基因,使得公司从诞生之初就锚定于解决真实世界中的智能难题,而非停留在仿真或理想化场景。
所谓“信念”,在原方智能的语境中,并非指代人类的情感或主观确信,而是一种基于有限观测与既有经验,对不可完全观测世界状态所形成的可更新的概率性估计。这种估计必须能够回答四个关键问题:当前世界处于什么状态?潜在的运行规律是什么?我的行动会带来哪些可能后果?我对这些判断的不确定性有多大?
要实现这一点,传统端到端的感知-决策范式显然力不从心。当环境充满噪声、传感器存在盲区、行动具有延迟甚至不可逆后果时,智能体需要一个内部的“模拟器”——即世界模型——来填补感知空白、预演未来、评估风险。这正是原方智能将世界模型置于技术核心的根本原因。
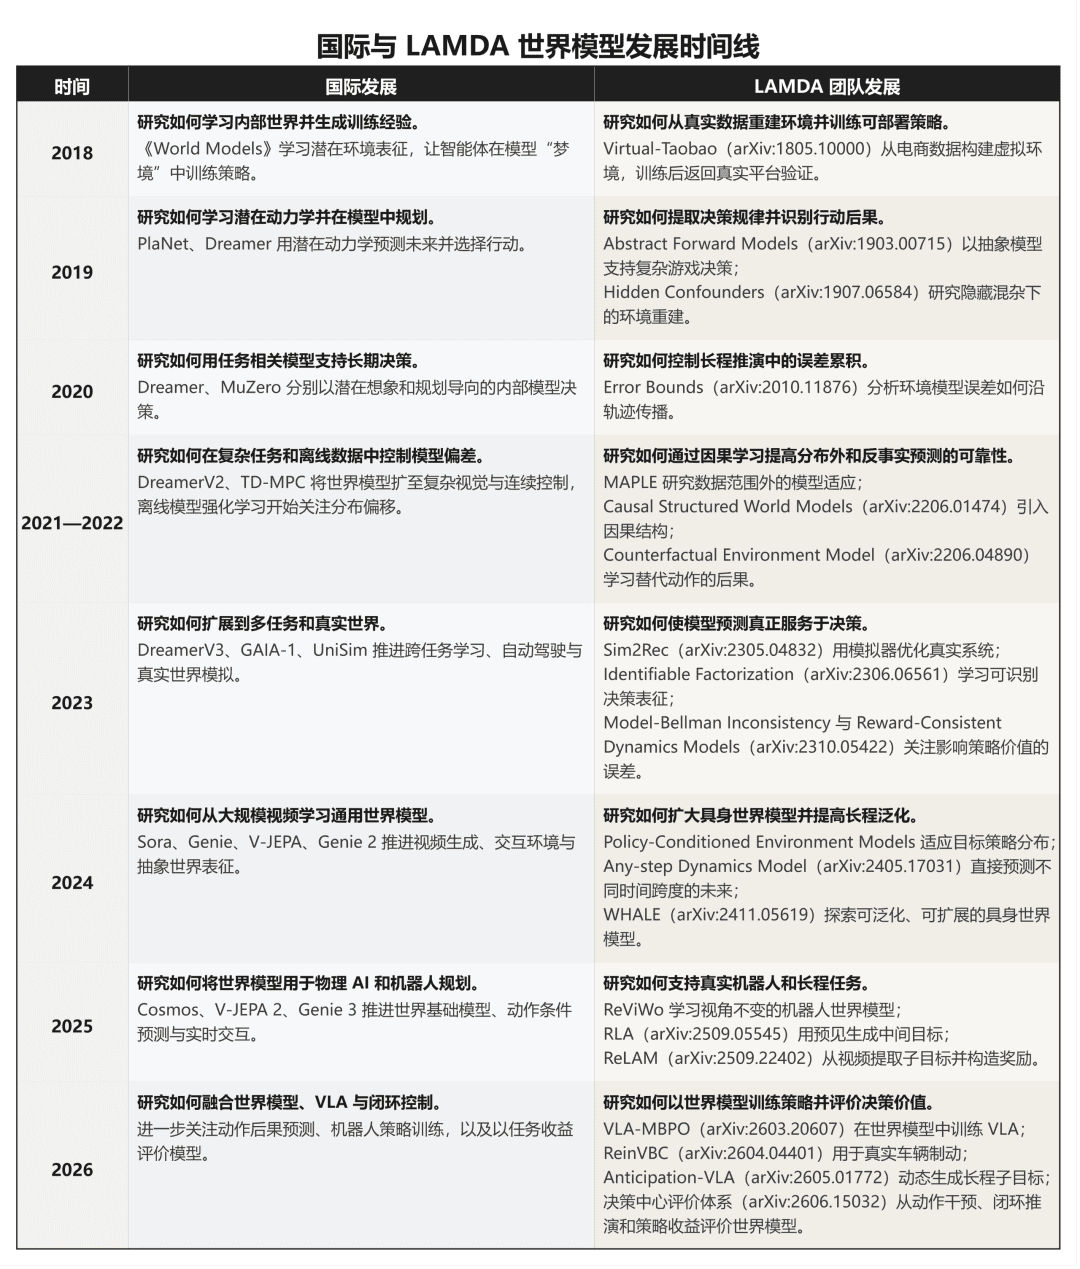
回溯其技术源头,LAMDA团队自2018年起便系统性地布局世界模型研究,几乎与国际前沿同步。当年,David Ha等人发表《World Models》,提出在“梦境”中训练策略,引发学界广泛关注。几乎同时,LAMDA团队发布了Virtual-Taobao(arXiv:1805.10000),从真实电商平台日志中重建虚拟环境,让推荐策略先在模型中学习,再部署到真实系统验证。这一工作奠定了其“从现实学习世界,在模型生成经验,用经验训练策略,回现实验证效果”的研究范式。
这一范式看似简单,实则蕴含深刻挑战。首要问题在于:模型学到的究竟是真实因果规律,还是数据中的虚假相关?2019年,团队开始关注隐藏混杂变量下的环境建模(arXiv:1907.06584),警惕将历史行为与结果之间的统计关联误判为因果效应。后续工作进一步探索因果结构世界模型、反事实环境建模与可识别表征(如arXiv:2206.01474等),旨在确保模型不仅能“描述过去”,更能“指导未来”——即支持未见过的干预行动。
例如,在自动驾驶中,若模型仅学会“踩刹车时车会停”,但未理解“刹车力度、路面摩擦、车速”之间的物理关系,那么在湿滑路面或紧急避障时,其决策可能致命。因此,因果正确性与反事实泛化能力,是世界模型能否用于高风险物理系统的分水岭。
另一个长期被忽视的问题是:世界模型的预测精度是否真正转化为策略性能的提升?许多研究追求视频生成的逼真度或单步预测误差最小化,但这并不保证长程推演的有效性。LAMDA团队早在2020年就对环境模型的长程误差进行了理论分析(arXiv:2010.11876),指出误差累积会导致策略在模型中表现优异,却在现实中失效。
为此,团队转向更务实的评价标准:模型能否正确比较不同动作的优劣?能否可靠预测奖励与风险?能否在其中训练出优于纯现实交互的策略?最终,策略回到真实世界后是否确实表现更好?这一系列问题推动世界模型从“预测工具”进化为“决策基础设施”。
2024年底,团队发布WHALE(arXiv:2411.05619),标志着其研究进入规模化具身阶段。WHALE尝试从跨任务、跨机器人的异构数据中提取共享的世界规律,解决策略迁移、长程一致性与虚拟经验可信度等难题。值得注意的是,该工作早于Cosmos、V-JEPA 2、Genie 3等国际大模型的集中爆发,显示出LAMDA团队对技术趋势的前瞻性把握。
随后,研究进一步落地到真实机器人平台。面对摄像机视角变化、光照干扰、执行器噪声等现实挑战,团队提出稳定表征学习方法,并发展出“预见”(Anticipation)路线——模型不仅要预测未来状态,还要为主动任务生成中间目标并动态调整。相关成果如RLA、ReLAM和Anticipation-VLA(arXiv:2509.05545等)展示了在复杂操作任务中,模型如何引导智能体分阶段达成目标。
2026年,技术链条迎来关键整合:VLA-MBPO(arXiv:2603.20607)首次实现了在交互式世界模型中端到端训练视觉-语言-动作(VLA)模型。流程如下:真实机器人采集少量交互数据 → 构建世界模型 → 策略在模型中大量试错,生成虚拟经验 → 利用虚拟+真实数据联合优化VLA策略 → 将新策略部署回真实机器人验证。这一闭环大幅降低了对真实交互的依赖,同时提升了策略的泛化能力。
与此同时,团队还提出了面向具身决策的世界模型评价框架(arXiv:2606.15032),明确反对仅以视频重建质量作为评判标准。该框架强调三大维度:动作后果预测准确性、长程规划支持能力、现实任务性能增益。只有在这三方面均表现优异的模型,才被视为“有用”的世界模型。
原方智能的成立,正是将这一八年积淀从实验室推向开放物理世界的转折点。公司提出的“三道关卡”——少量经验、形成信念、相融行动——恰好对应其技术演进的三个层次:
第一关“少量经验”,解决数据效率问题。通过虚拟环境与模型生成经验,智能体无需海量真实交互即可学习,这在机器人、工业控制等领域至关重要;
第二关“形成信念”,解决认知深度问题。借助因果建模、不确定性量化与可识别表征,系统能区分相关与因果,理解自身认知边界;
第三关“相融行动”,解决闭环可靠性问题。通过预见机制与VLA-MBPO等架构,确保模型中的规划能无缝转化为现实中的有效行动。
这种层层递进的技术路线,展现出对通用具身智能本质的深刻理解:真正的智能不是对环境的被动反应,而是在内部构建一个可操作、可推理、可修正的世界镜像,并以此指导行动、积累经验、持续进化。
放眼行业,当前多数具身智能方案仍依赖大规模真实数据训练或局限于特定任务。而原方智能选择了一条更艰难但更具扩展性的道路——以世界模型为引擎,驱动智能体在有限经验中生长出对世界的结构性理解。这不仅是技术路径的选择,更是对智能本质的一种哲学主张。
随着物理AI浪潮的兴起,世界模型正从学术概念走向产业核心。原方智能的出现,或许将加速这一进程,并为通用具身智能的发展提供一条兼具理论严谨性与工程可行性的中国路径。